
一句话总结:10 月出了两个很有代表性的垂域模型——灵境税务大模型把功夫全花在语料底座上(4.8 万篇文档、8000 部法规、逐条标时效),ZGCM-1 则把训练过程整个交出来(三阶段权重、数据配方、遥测日志全开源)。一个教你怎么治数据,一个教你怎么训模型。
做行业模型的人迟早要面对同一个问题:通用模型什么都懂一点,什么都不精。解法有两条,这两天的两个发布正好各占一头。
一条是把领域数据挖到极致,模型参数不用大;另一条是把训练方法做成可复现的公开配方,让别人在你的基础上继续。前者是工程活,后者是研究活。
路线 A:灵境税务,把语料做成可验证的底座
第一个开源的税务大模型,10 月发布,权重在魔搭社区。合作方是北京灵境技术和北京华夏税务师事务所,后者提供专业侧的把关。
| 项目 | 参数 |
|---|---|
| 参数规模 | 8.95B |
| 基座 | Qwen3.5-9B-Base |
| 训练方式 | 全参数 CPT + SFT(明确说明不是浅层 LoRA) |
| 继续预训练 | 3,248 步 |
| 指令微调 | 32,493 步,25.99 万条(垂域 22.8 万 + 通用 3.1 万) |
| 语料 | 约 4.6 万篇 / 约 1.4 亿字 |
| 获取 | 魔搭社区(ModelScope) |
真正值得看的是语料治理
参数和步数都是常规量级,这篇最该抄的是他们处理数据的方式。
原始素材是 11 个专业语料文件、4.8 万余篇文档,覆盖 8000 多部税务法规,再叠加会计准则、审计准则、会计制度、评估准则。加上 2.3 万条 12366 专业回复、近 3000 篇判例、12 类申报表单。文件级去重后剩 4.6 万篇。
然后过了四道工序:去重、清洗、时效标注、结构统一。
第三道是关键。税务领域有个通用大模型必然踩的坑:法规会废止、会修订。模型如果不知道「这条已经失效」,就会一本正经地引用一条早就作废的条款。他们的做法是把每份文档标成「现行有效 / 已修改 / 已废止」,三类按不同权重处理。
第四道是把字段契约定死:id / 正文 / 来源 / 类型 / 时效 / 标签 / 切块归属。这套契约的价值在检索和溯源——答案里要给出法规全称、文号、条款号,就得靠这些字段。
这套方法可以直接搬到别的垂域:医疗要标指南版本,金融要标监管口径,建筑要标规范版本号。「时效」这个维度几乎所有严肃垂域都得有,但大多数开源数据集根本不标。
能力清单对应的是真实工作流
- 带出处的法条问答与时效提示(先结论,再给法规全称、文号、条款)
- 分步税额计算(含税/不含税、限额/据实、一般/简易计税等边界)
- 涉税案例检索与说理
- 12 类申报表的填报说明
- 稽查、复议程序咨询
我看这份清单的感觉是:它没有吹「超越 GPT」,而是老老实实列了六个具体活。这种克制反而是可信信号。
路线 B:ZGCM-1,把整个训练过程交出来
中关村学院的 7B 稠密模型,从零训练。它的卖点不是能力,是开源范围。
| 项目 | 参数 |
|---|---|
| 参数规模 | 7B 稠密 |
| 上下文 | 256K |
| 训练 | 从零开始,非微调 |
| 开源范围 | 预训练/中期/后训练三阶段权重、中间检查点、数据配方、遥测日志、评估套件 |
大部分所谓「开源模型」只给最终权重。ZGCM-1 把中间检查点、数据配方、训练日志、评测代码一起放出来了,论文里还写了八条经验发现。
这个做法对一个研究者的价值远大于「又一个 7B 模型」——你能看到它在 16K、64K、256K 三个上下文阶段分别怎么过渡,能看到哪些数据配比有效哪些无效,能复现失败。
三个技术选择
混合注意力。 交错使用门控滑窗注意力和全注意力,长上下文时滑窗负责省算力、全注意力负责保质量。
FP8 Muon 优化器。 论文里提到 TWEO 让 FP8 训练变得可行。低精度训练一直是长上下文训练的省钱关键,但稳定性难搞。
渐进课程的中期训练。 上下文按 16K → 64K → 256K 三档扩,并把交互轨迹重新表述成马尔可夫决策过程来训练。这一步是把「对话数据」转成「智能体决策数据」的关键,也是它能兼顾 Agent 能力的原因。
八条结论里我认为最该抄的三条
论文列了八条,其中三条对做模型的人直接有用:
- SFT 质量胜于数量。 这个结论不新,但这次有可复现的实验支撑。
- 长中期训练可以替代超长 SFT。 意思是与其灌大量指令数据,不如在中期训练阶段把能力打好。这条如果成立,能省下大量标注成本。
- 通用数据对 agent 训练是必要的。 纯垂域数据训出来的 agent 会僵化,得掺通用数据。
第三条和我之前的判断一致:垂域模型的通病是「专业但笨」,掺通用数据能缓解,代价是专业浓度被稀释,比例得试。
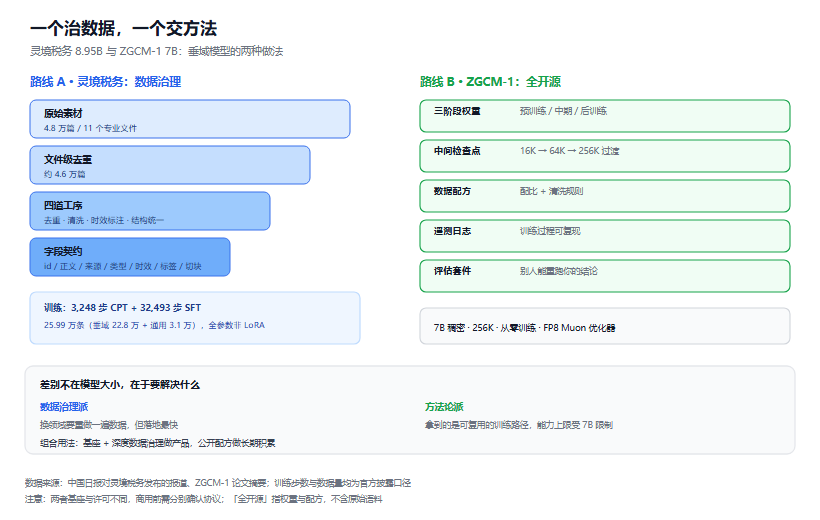
图 1:左为税务模型的数据治理漏斗,右为 ZGCM-1 的开源五件套
两条路的本质差别
| 维度 | 灵境税务 | ZGCM-1 |
|---|---|---|
| 起点 | 成熟基座(Qwen3.5-9B) | 从零训练 |
| 投入重点 | 数据治理与领域对齐 | 训练方法与可复现性 |
| 产出 | 一个能用的垂域模型 | 一套能抄的训练配方 |
| 适合谁 | 要直接上生产的团队 | 要研究或二次开发的人 |
| 短板 | 换领域要重做一遍数据 | 7B 的能力上限就摆在那 |
我的判断是这两条路不冲突,甚至该组合。做行业产品,直接拿灵境这种思路(基座 + 深度数据治理)落地最快;做长期技术积累,ZGCM-1 这种公开配方能帮你少走弯路。
一个反面提醒:垂域模型最容易死在「数据看起来多,但不可验证」。4.6 万篇、1.4 亿字听着不少,真正决定质量的是那四道工序——尤其是时效标注。没有这一步,模型越像专家,错得越像专家。
FAQ
8.95B 这个尺寸做垂域够用吗?
够用。垂域任务的知识范围窄、术语集中,9B 级别配合高质量语料通常比 70B 通用模型更准。代价是通用能力弱,所以训练时要掺通用数据保底。
为什么不直接用 RAG 而要训模型?
RAG 解决「查到」,模型解决「会算、会说、会引」。税额计算、申报表填报这类任务需要模型理解计算规则,光检索文档做不出来。实务里两者是配合关系。
ZGCM-1 的「全开源」包不包括数据本身?
给的是数据配方(配比、清洗规则、处理流程),不是原始数据。原始语料通常有版权和许可限制,没法直接放出来,这是行业惯例。
税务模型的权重能商用吗?
基座 Qwen3.5-9B-Base 有自己的协议,垂域权重又可能有额外条款。上生产前必须把两层协议都读一遍,别假设「开源=随便用」。
普通人能用上这两个模型吗?
税务模型面向中小企业主、财务、税务师,实际价值在带出处的法条问答和填表说明。ZGCM-1 更适合研究者和开发者,7B 稠密在消费级机器上量化后能跑。
结语
这两个发布放一起看,恰好说明了垂域模型的两条主线:一条是把数据做到可验证,一条是把方法做到可复现。
真正稀缺的不是模型,是那四道数据工序和那八条训练结论。模型半年就过时,方法能用三年。
参考资料
- 中国日报 - 灵境税务大模型发布:语料规模、训练步数与六大能力
- ZGCM-1 论文摘要与技术要点 - 全开源 7B、256K 上下文、八条经验发现
- 本站 Qwen3.8 家族解读 - 基座协议与 9B 档位参考
- 本站 10 月开源权重季 - 许可证四档划分
- 真正值得看的是语料治理
- 能力清单对应的是真实工作流
- 三个技术选择
- 八条结论里我认为最该抄的三条
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。