
一句话总结:x64dbg 告诉你「这条指令在做什么」,Ghidra 告诉你「这段代码在算什么」。这篇讲清五个窗口的分工、六个必会操作、从动态地址换到静态地址的方法,以及为什么自动分析经常认错函数。
上一篇 PE 结构里提到,找偏移只是第一步,看懂逻辑是另一回事。在 x64dbg 里读汇编,一百行之后就开始晕了;而 Ghidra 能把整段函数反编译成 C 风格的伪代码。
Ghidra 是美国国家安全局开源的工具,Apache 2.0 协议,免费。这一点当年发布时挺让人意外,现在它已经是逆向的标准工具之一。
前置
- Ghidra:官网下压缩包,解压即用,不用安装
- JDK 21:新版 Ghidra 要求这个版本,装错了启动会直接报错退出
- 内存 8GB 起步:自动分析大型二进制很吃内存,分析 100MB 的可执行文件时 16GB 才舒服
- 时间:第一次分析一个中型程序,自动分析可能要跑几分钟到十几分钟
启动脚本是 ghidraRun.bat(Windows)或 ghidraRun(Linux/macOS)。
五个窗口,各管一件事
| 窗口 | 看什么 | 什么时候用 |
|---|---|---|
| Program Trees | 按内存块列节 | 确认代码段范围和加载基址 |
| Symbol Tree | 函数、导入、导出、标签 | 找入口、找系统 API 调用点 |
| Listing | 反汇编指令 | 需要精确到指令时 |
| Decompiler | C 风格伪代码 | 主战场,八成时间在这 |
| Data Type Manager | 结构体与类型定义 | 把 [rbx+0x138] 变成 player->health |
真正提效的是 Data Type Manager 这个。默认分析出来的伪代码里全是 *(int *)(param_1 + 0x138),你只要在 Data Type Manager 里建一个结构体,把字段命名好,伪代码立刻变成人话。
这一步的工作量和 ReClass 那套思路一致(见 ReClass 那篇),只是 Ghidra 里可以直接把结构体应用到函数签名上,全函数生效。
六个必会操作
G:跳转。 输入地址或符号名,直接定位。从别处抄来的地址都靠这个。
L:重命名。 对函数、变量、标签都有效。取名是最便宜的注释,FUN_140001a20 改成 calc_damage 之后,整个调用链都看得懂了。
右键 → References → Show References to:看谁调用了这个函数。 这是逆向里最高频的动作,比读代码本身更常做。想看某个 API 在哪里被用,就查它的引用。
右键 → Data → 改类型。 把 undefined4 改成 int、把指针改成结构体指针,伪代码可读性会跳一个档。
F:标记为函数。 自动分析漏掉的函数,选中起始地址按 F,Ghidra 会重新按函数解析这一段。
分号:加注释。 你的分析结论要写下来,否则三天后自己都看不懂。
有一件事我觉得值得强调:Ghidra 的伪代码不是真的 C。它是反编译器的「猜测」,变量名、类型、控制流都可能是错的。看到不合理的地方,回 Listing 对照指令确认,别把伪代码当源码看。
地址怎么对过去
这一步新人最容易卡住。
x64dbg 里显示的地址是运行时地址,比如 StarFall.exe+1A2C0 或者 0x7FF6A1B42C0。Ghidra 里显示的是文件映像地址,通常是 ImageBase + RVA。
换算方法:
- 在 x64dbg 里记下「模块名 + 偏移」的形式,那个偏移就是 RVA
- 在 Ghidra 的 Program Trees 里看 image base(PE 常见
0x140000000) - 目标地址 = image base + RVA
比如 RVA 是 0x1A2C0,image base 是 0x140000000,Ghidra 里按 G 输入 14001a2c0 就到了。
不要直接抄 x64dbg 的绝对地址,因为 ASLR 每次重启都变。永远用「模块 + 偏移」这套坐标系,它是不变的。
反过来也成立:在 Ghidra 里看到一个可疑函数,想知道它运行时参数是什么,就带着 RVA 回 x64dbg 下断点。这两边来回切,是逆向的日常。
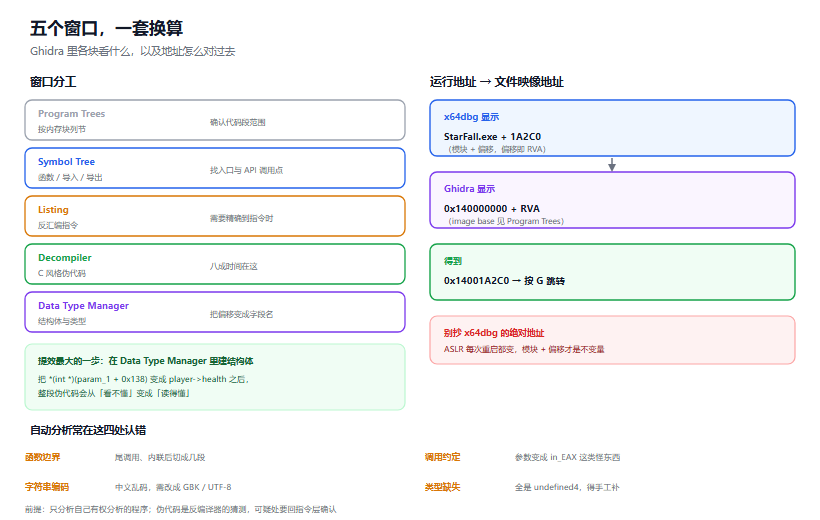
图 1:左为五个窗口各管什么,右为运行地址与文件映像地址的换算
自动分析为什么会认错
自动分析做了很多事:识别函数边界、推断调用约定、识别字符串、传播类型。但它靠的是启发式规则,遇到下面几种情况就会出错:
函数边界识别错。 编译器优化后的尾调用、内联展开,会让 Ghidra 把两个函数当成一个,或者把一个函数切成几段。表现是伪代码里出现莫名其妙的跳转。
调用约定推断错。 尤其是手写汇编、或者用了非标准约定的代码。参数全变成 in_EAX 之类的怪东西时,就是这个原因。可以在函数签名上右键改调用约定。
字符串乱码。 中文字符串经常显示成乱码,因为默认按 ASCII 解码。在字符串上右键改编码为 GBK 或 UTF-8 就能修。
类型全错。 没有符号信息时,Ghidra 只能用 undefined4 这类占位类型。这不是它笨,是信息真的缺失,需要你手工补。
有个实用技巧:只跑必要的分析项。Analysis → Auto Analyze 里可以取消勾选耗时长的项(比如某些数据类型的推断),第一次导入先快速看一眼,需要时再补跑。
脚本能力
Ghidra 支持 Java 和 Python(Jython)脚本,这一点比很多商业工具大方。
常见的用法:批量重命名、导出所有函数列表、扫描特定指令模式、把分析结果导出成 JSON。
脚本放在 Window → Script Manager 里,也可以写自己的放到 ghidra_scripts 目录。另外它支持 headless 模式(命令行 analyzeHeadless),可以批处理一堆样本。
如果你要做「一次分析一百个样本,找出用了某个加密函数的那些」,headless 脚本是唯一可行的方式。
坑清单
坑一:JDK 版本不对。 启动直接报错退出,或者卡在启动界面。看官方 release note 要求的 JDK 版本,别装最新版就完事。
坑二:自动分析没跑完就下结论。 分析过程中函数还没识别完,你看到的伪代码是不完整的。等状态栏的分析进度结束再看。
坑三:把伪代码当源码。 反编译器的推断会错。看到「这逻辑不对」时,回指令层确认。
坑四:直接抄运行时地址。 ASLR 每次不同,必须用 image base + RVA。
坑五:分析超大文件时内存爆。 可以在 support/analyzeHeadless 或启动配置里调 JVM 堆大小(-Xmx),默认值对大型二进制不够。
坑六:忘记保存项目。 Ghidra 的改动(重命名、类型、注释)都在项目里,虽然会自动保存,但强制关闭可能丢。分析一段就 CtRL+S 一次。
边界
这篇讲的是静态分析,适用于自己有权分析的程序:自己写的、开源的、靶场里的、明确授权的样本。
Ghidra 的正经用途很广:分析第三方库的行为、检查闭源组件有没有偷偷联网、研究恶意样本、给没有源码的老系统做维护文档、学习编译器的优化策略。
需要提醒的是,静态分析和动态分析要配合。只静态看,容易把「理论上会执行」当成「实际会执行」;只动态看,容易漏掉那些需要特定条件才触发的分支。
FAQ
Ghidra 和 IDA 该选哪个?
预算有限选 Ghidra,功能覆盖了大部分需求。IDA 的优势在插件与脚本资源(数量多)、反编译质量(Hex-Rays 确实更强)、以及处理某些特殊格式的经验。学生和业余用途 Ghidra 完全够。
能分析 ARM 和 MIPS 吗?
能,Ghidra 支持一大堆架构,包括 ARM、MIPS、PowerPC、以及一些嵌入式常用的。分析固件时这点很关键。
.NET 程序能用吗?
能打开,但看到的是 IL 或者 JIT 后的产物,可读性一般。托管代码用 DNSpy / ILSpy 更合适。
分析一个程序要多久?
小型工具几秒到一分钟,中型应用几分钟,大型游戏主程序可能十几分钟。分析时间是线性的,取决于代码量。
能反编译出可直接编译的代码吗?
不能。反编译结果是给人读的,变量名、类型、控制流都不保证正确,也没法直接编译通过。
结语
Ghidra 的价值是把「读汇编」变成「读带类型的伪代码」,效率差好几倍。
但它给的是猜测,不是真相。真正可靠的分析是:Ghidra 里看懂结构,x64dbg 里验证行为,两边对上了才算数。
参考资料
- Ghidra 官方站点 - 下载与安装要求(含 JDK 版本)
- Ghidra 官方仓库 - 源码、发布说明与脚本示例
- Ghidra 在线帮助 - 反编译器与 Data Type Manager 用法
- 本站 x64dbg 入门 - 动态侧如何与静态分析配合
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。