
一句话总结:科大讯飞 10 月 22 日在 1024 开发者节发布星火 X2.6,走的是「云端不大、端侧够用、中间靠路由」这条路。核心数字有两个:4B 端侧模型的智能体任务覆盖度 41.9%(业界主流约 12.8%),以及端云路由准确率 96.1%(此前 81.2%)。后者才是这套方案能不能成立的关键。
先说结论:这个发布真正的技术含量不在模型本身,在「派单」。
4B 模型再强也有天花板,讯飞自己的说法是目标做到 60% 覆盖度。剩下 40% 怎么办?交给云端。那么「哪些任务该留在本地、哪些该上云」这个判断的准确率,就直接决定了整套方案的体验和成本。
定位:云端不做太大
刘庆峰给的判断是:未来 60% 的 AI 应用跑在本地,30% 端云协同,10% 由云端独立完成。
这个比例和现在的主流路线是反的。多数厂商的做法是云端堆到最强,端侧只做个入口。讯飞反过来:云端模型「不会做太大」,重点放在通用端侧模型 + 一体化调度。
为什么选 4B?他的解释我认为是这份材料里最实在的一句:4B 既是做智能体任务的最低规模,也是能在主流消费级硬件上跑起来的最大规模。
也就是说,这个尺寸不是技术偏好,是被两端卡出来的:再小接不住多步工具调用,再大装不进笔记本和车机。
两个核心数字
| 指标 | 数值 | 对比 |
|---|---|---|
| 端侧智能体任务覆盖度 | 41.9% | 业界主流 4B 模型约 12.8% |
| 端云路由准确率 | 96.1% | 此前 81.2% |
| 端侧上下文 | 最长 100 万 Token | 原生支持,非外挂 |
| 训练算力 | 全国产 | 全栈自主路线 |
关于 41.9% 这个数,各家报道的表述有出入:有的写「由业界主流的 12.8% 提升到 41.9%」,有的写「领先最好的 4B 模型 12.8%」。两种说法对不上(前者意味着差距 29.1 个百分点,后者意味着 12.8 个百分点)。我按前一种理解,因为它和「覆盖度 41.9%」这个绝对数能对上。
「智能体任务覆盖度」这个指标本身也值得留意:它不是某个标准榜单,是讯飞自己定义的口径,指模型能完成的任务类型占比。自定口径的分数只能自己和自己比,看趋势可以,跨厂商对比要谨慎。
派单员与裁判员:路由是怎么训出来的
这套机制我认为是整篇最值得记的部分。
端云路由要解决的问题很具体:一条用户请求进来,判断它该在本地跑、上云跑、还是两边配合。判断错了,要么白花 token,要么本地跑不动。
常规做法是写规则或训一个小分类器,但规则覆盖不全,分类器缺少反馈信号。
讯飞的做法是引入一个「评语模型」当裁判:同一个任务,端侧和云端各跑多次采样,裁判对比两边的结果质量,给出打分,这个打分变成奖励信号,反过来训练路由。再用协同交替训练把这个循环跑起来。
词元星火 CTO 刘权的比喻是:路由是派单员,评语模型是裁判员,用裁判打分反复训练派单员。
一年之内路由准确率从 81.2% 提到 96.1%。这个提升幅度比模型参数的增长更有意义,因为路由错一次的代价是双重浪费:既花了本地算力,又花了云端 token。
数据不出端是怎么做到的
流程设计得比较克制:
- 需要上云时,敏感信息先在本地脱敏
- 脱敏结果给用户检查、修改、确认
- 只上传脱敏后的内容,本地原始文件不上传
- 云端返回结果后,在端侧还原敏感信息
- 支持自定义脱敏策略
现场演示的是一个「机器人创业公司 CEO 做经营复盘」的场景:模型读本地邮件、附件和各区域周报,找出不同团队重复跟进同一客户的风险,并标注信息来源。整个过程资料不出端。
这个演示选得聪明,因为「重复跟进同一客户」这种判断恰好需要跨文档关联,而这类活过去是云端模型的强项。
医疗那边也有个数字
同日星火医疗大模型 V3.7 在 MedBench 5.0 上拿到 99.6 分登顶。这类专业榜单我不太敢直接采信单项分数,但至少说明在垂直领域他们还在持续投入。
另外有个背景值得一提:讯飞 6 月成立了子公司「词元星火」(注册资本 10 亿,刘权领衔),9 月 1 日就开源过 X2.5-4B 和 X2.5-1.7B,当时是端侧模型里首个原生支持 100 万 token 的。所以 X2.6 不是突然冒出来的,是这条线迭代了一年的结果。
这条路的风险在哪
第一,路由准确率的天花板。 96.1% 意味着每 25 次调度有 1 次判错。判错的表现可能是「本该本地跑的被送去云端」(多花钱、慢),也可能是「本该上云的硬在本地跑」(结果差)。后者用户感知更明显。
第二,端侧硬件的碎片化。 笔记本、车机、手机、智能家居的算力和内存差异巨大,同一个 4B 模型在不同设备上的实际体验会差很远。发布会上说的是「主流消费级硬件」,这个定语很关键。
第三,自定口径的指标缺少外部验证。 41.9% 这个数没有第三方复现,MEDBench 99.6 也是单一榜单。我倾向于把这两个数当「方向正确」的信号,而不是「已经领先」的证明。
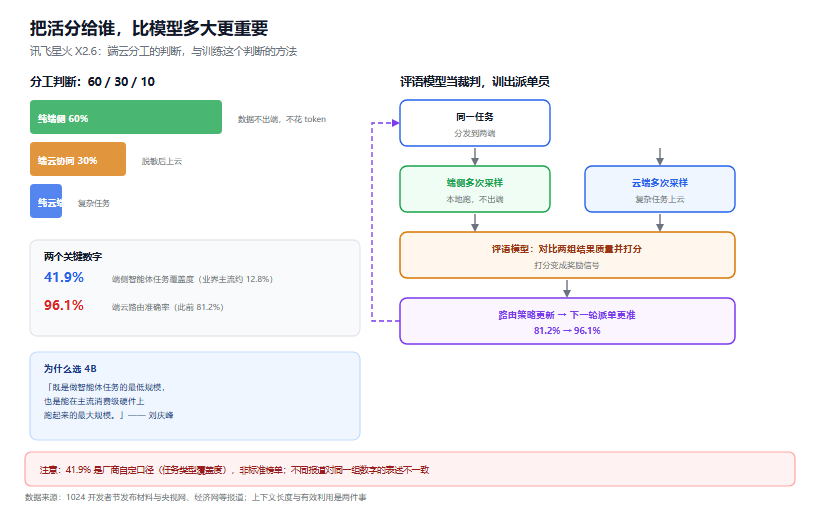
图 1:左为 60/30/10 的分工判断,右为评语模型训练路由的循环
FAQ
4B 模型真能跑 100 万 token 上下文?
官方说原生支持。但要注意:上下文长度和「能不能有效利用」是两件事。100 万 token 塞进去,模型能不能精准定位到中间那段信息,是另一个问题,通常需要专门的检索增强。
端云协同和直接调云端 API 比,省多少?
取决于路由准确率和任务分布。理论上本地完成的那部分不花 token,但端侧要消耗设备电量和算力。具体账要按自己的任务组合算,官方没给通用的成本模型。
个人开发者能用吗?
端侧模型之前开源过(X2.5 系列),X2.6 的开放方式要看官方后续说明。云端 API 一直有开放。
和手机厂商自带的端侧模型比呢?
定位不同。厂商自带模型通常深绑自家系统能力,讯飞这类通用端侧模型的优势是可以跨设备、跨品牌部署,缺点是对系统级 API 的调用权限没那么深。
国产算力训练影响能力吗?
刘庆峰的说法是「训端侧模型够用」。从公开数据看不出明显短板,但也没有同口径的对比实验,这点存疑。
结语
这个发布最有价值的地方,是把「端云协同」从一句口号变成了可度量的两个数:任务覆盖度和路由准确率。
前者决定端侧能顶多少活,后者决定调度靠不靠谱。模型参数量在这个框架里反而不是主角。
至于 60/30/10 这个判断会不会成真,我持谨慎态度。本地跑的比例取决于硬件换代速度,比模型迭代慢得多。
参考资料
- 经济网 - 1024 开发者节:60/30/10 判断与 4B 尺寸的选择理由
- 央视网 - 端云协同的调度机制与十大任务类别
- 川观新闻 - 星火 X2.6 发布:脱敏流程与端云一体架构
- 京报网 - 评语模型训练路由的细节与 96.1% 准确率
- 本站 MiniCPM5-2B 本地部署实战 - 端侧模型的显存与量化实账
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。