
一句话总结:所谓 Agent,剥掉包装就是一个 while 循环:模型输出工具调用、你执行、把结果塞回去、再问一次。真正的工程量不在循环本身,在三个边界——工具报错怎么回传、怎么防止无限循环、上下文怎么不爆。
先破除一个误解。很多人以为 Agent 是个复杂框架,得装 LangChain、AutoGen 之类。其实核心逻辑不到 100 行,框架加的那几千行主要在编排、重试、可观测、多 Agent 协作。
搞清楚最小循环长什么样,你才知道框架在替你做什么、什么时候不该用框架。
前置
pip install OpenAI一个能调工具调用的模型:本地 Ollama(http://localhost:11434/v1)或任何 OpenAI 兼容接口。openai 这个 SDK 现在基本成了事实标准,换成别的服务商只改 base_uRL。
循环的形状
用户任务
  ↓
[模型] ──有 tool_calls?──否──→ 输出最终答案 → 结束
  ↓ 是
[执行工具] → 结果回填 messages
  ↓
回到 [模型](受 max_rounds 限制)
就这么简单。难点全在方括号里。
完整代码
import json
from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", API_key="ollama")
MODEL = "qwen3:4b"

TOOLS, HANDLERS = [], {}

def register(schema, handler):
    TOOLS.append({"type": "function", "function": schema})
    HANDLERS[schema["name"]] = handler

# ── 两个示例工具
def read_file(path: str) -> str:
    with open(path, encoding="utf-8", errors="replace") as f:
        return f.read()

def list_dir(path: str) -> str:
    import os
    return "\n".join(sorted(os.listdir(path))[:200])

register({
    "name": "read_file",
    "description": "读取本地文本文件。用于查看代码、日志、配置;不要用它读二进制文件。",
    "parameters": {
        "type": "object",
        "properties": {"path": {"type": "string", "description": "文件绝对路径"}},
        "required": ["path"],
    },
}, read_file)

register({
    "name": "list_dir",
    "description": "列出目录下的文件名。不清楚有什么文件时先调它。",
    "parameters": {
        "type": "object",
        "properties": {"path": {"type": "string", "description": "目录绝对路径"}},
        "required": ["path"],
    },
}, list_dir)

def call_tool(call) -> str:
    """执行一次工具调用,任何异常都转成字符串返回给模型"""
    name = call.function.name
    try:
        args = json.loads(call.function.arguments or "{}")
    except json.JSONDecodeError as e:
        return f"参数不是合法 JSON:{e}"

    handler = HANDLERS.get(name)
    if handler is None:
        return f"没有名为 {name} 的工具,可用的是:{', '.join(HANDLERS)}"
    try:
        return str(handler(**args))
    except TypeError as e:
        return f"参数不匹配:{e}"
    except FileNotFoundError:
        return "文件不存在,检查路径后重试"
    except Exception as e:
        return f"执行失败:{type(e).__name__}: {e}"

def run(task: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": "你是本机助手。需要文件内容时调用工具,不要凭印象猜。"},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages,
            tools=TOOLS, tool_choice="auto", temperature=0,
        )
        msg = resp.choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            result = call_tool(call)
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,          # 少这一行,接口直接 400
                "content": result[:4000],         # 截断,防止把上下文撑爆
            })

    return f"达到 {max_rounds} 轮上限仍未完成"

if __name__ == "__main__":
print(run("看看当前目录下有哪些文件,然后告诉我这个项目是干什么的"))跑通之后你会看到一件事:模型并不是每次都听话。有的会反复读同一个文件,有的会先列出目录再猜文件名。这不是 bug,是它只有你给的那些工具和那几句描述。
三个边界,决定这套东西能不能用
边界一:工具报错必须回传,不能抛
上面 call_tool 里每个 except 都返回字符串,这是刻意的。
如果异常往上抛,循环直接中断,模型永远不知道自己错在哪。而如果返回 "文件不存在,检查路径后重试",模型有相当大概率下一步就换个路径再试。
这是「Agent」和「一次调用」最大的行为差异:错误反馈是它自我修正的唯一输入。
代价是你要克制:错误信息要短、要可操作,不要贴完整 traceback,否则几千 Token 的堆栈会挤掉真正的上下文。
边界二:轮数上限是硬要求
max_rounds=8 不是保守,是必需。没有它,模型完全可以陷入「读文件 → 觉得不对 → 再读同一个文件」的死循环,一次任务烧掉几十万 token。
三层防护我一般这么配:
| 层 | 手段 | 作用 |
|---|---|---|
| 轮数 | max_rounds | 兜底,防死循环 |
| 预算 | 累计 token 或调用次数上限 | 防单轮超长 |
| 幂等 | 同参数同工具的去重 | 防重复劳动 |
第三层最容易被忽略。写一个 (name, args_json) 的集合,命中就返回「这个调用刚刚做过,结果如下」并从缓存取,能省掉大量重复请求。
边界三:上下文会爆
每次工具返回都往 messages 里塞。读三个 50KB 的日志文件,上下文就满了。
上面的 result[:4000] 是最粗暴的截断。实际用的时候我建议再细一点:
def trim(text: str, liMIT: int = 4000) -> str:
    if len(text) <= limit:
        return text
    head = text[: int(limit * 0.7)]
    tail = text[-int(limit * 0.2):]
    return f"{head}\n...[中间省略 {len(text)-len(head)-len(tail)} 字]...\n{tail}"
保留头部和尾部,中间标注省略了多少。头部通常有文件标识和开头内容,尾部往往是错误信息或结果,中间是最不重要的。
工具设计比循环重要
这段是我认为整篇最值钱的。
模型决定调哪个工具,靠的是 name + description + parameters schema。写得含糊,它就不用。
# ✗ 模型不知道什么时候该用
{"name": "search", "description": "搜索"}

# ✓ 有边界、有场景、有禁用条件
{
    "name": "grep_code",
    "description": "在代码库里按正则搜索文本,返回匹配行及行号。用于定位函数定义、变量使用;不要用它读整文件内容,那个用 read_file。",
    "parameters": {
        "type": "object",
        "properties": {
            "pattern": {"type": "string", "description": "Python 正则,不支持跨行"},
            "path": {"type": "string", "description": "搜索根目录"},
            "max_results": {"type": "integer", "description": "默认 30,上限 100"},
        },
        "required": ["pattern", "path"],
    },
}
三个要点:写明「什么时候别用」,参数加上限,返回值格式固定(模型要能预测解析难度)。
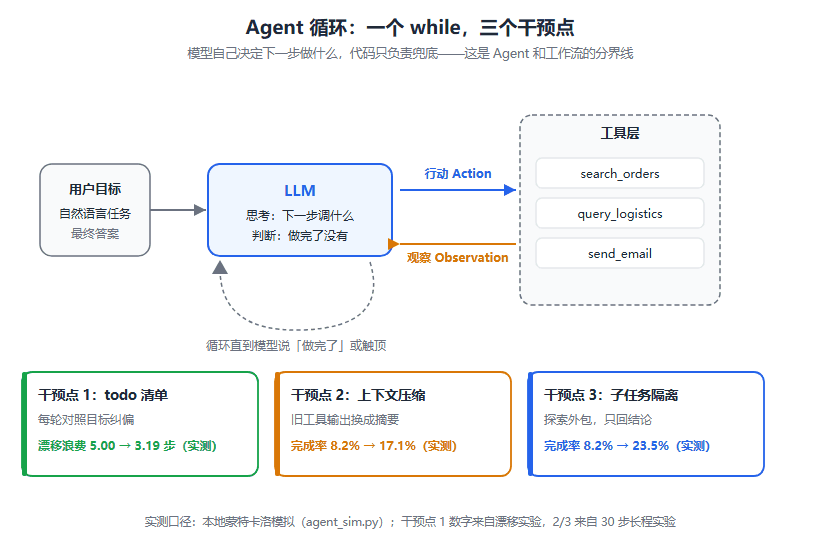
图 1:循环本体只有四步,工程量都在两侧的防护上
坑清单
坑一:漏了 tool_call_id。 回填结果时缺这个字段,OpenAI 兼容接口直接返回 400,报错信息通常很含糊。这是排第一的坑。
坑二:把异常往上抛。 循环中断,模型失去修正机会。所有工具执行都要包 try。
坑三:没设轮数上限。 线上跑一晚烧掉几百块的案例不少。默认给 6 到 10 轮。
坑四:temperature 没设 0。 同样的任务每次结果不一样,调试时根本没法复现。
坑五:工具返回结构化对象而不是字符串。 有些实现会返回 dict,序列化失败就变成「工具调用失败」这种无用信息。统一 str() 或 json.dumps()。
边界
这套最小实现适合「单机、短任务、工具数量少」的场景:本地文件分析、内部工具串联、把固定流程自动化。
不适合:多 Agent 协作、需要长期记忆、需要人在环路里审批的流程。这些确实该上框架,因为框架解决的是编排和状态管理,不是循环本身。
另外提醒一句:给了文件读写权限的 Agent,等于把你的文件系统交给了模型判断。工作目录要隔离,别在下载目录里跑(原因见投毒那篇)。
FAQ
必须要框架吗?
不用。先把这个 80 行跑通,你会发现大部分需求它就能满足。真需要多 Agent 再上框架,那时你也知道该选哪个。
本地 4B 模型能跑 Agent 吗?
能跑,但工具调用准确率明显低于大模型,通常需要多试几轮或加更明确的提示。7B 以上会稳很多。
怎么调试?
每次都把 messages 落盘成 JSON,出问题时回放。这比在循环里打断点有效得多。
多轮工具调用会不会很慢?
会。每轮都是一次完整的模型推理。8 轮意味着 8 次调用,本地 4B 模型可能几十秒,云端 API 看延迟。
怎么加人类确认?
在 call_tool 里对危险工具(写文件、执行命令)加一道 input() 确认,或者返回「需要用户确认」让上层处理。
结语
Agent 这个词被包装得太重了。剥开看,它是「模型 + 循环 + 工具 + 错误反馈」四件东西。
把这四件写对,比套十个框架管用。
参考资料
- OpenAI 官方文档 - Function calling 与 tool_calls 消息格式
- Ollama OpenAI 兼容层 - 本地模型如何对接同一套 SDK
- 本站 llama.cpp Function Calling 实战 - 完全本地不依赖云端的做法
- 本站 从零写一个 MCP 服务器 - 把工具做成可复用协议
- 边界一:工具报错必须回传,不能抛
- 边界二:轮数上限是硬要求
- 边界三:上下文会爆
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。