
一句话总结:Liquid AI 10 月 27 日放出 LFM3 家族,六个约 2B 的模型全部从同一个 1.7B 骨干分出,覆盖文本、视觉、音频、全模态和决策。文本模型 4bit 量化后约 1GB、上下文 256K、单卡能微调。但许可证有个门槛:年营收 1000 万美元以上的公司不能商用。
这个发布值得单独写,不是因为「又一个 2B 小模型」,而是它做了一件别人没做的事:一个骨干,六个头。
过去的小模型路线是每个能力训一个模型:文本一个、视觉一个、语音一个,部署时全装上去,加起来内存就爆了。LFM3 的做法是把它们做成同一棵树的分支,你按需要挑一枝。
六个模型各管什么
| 模型 | 输入 | 输出 | 定位 |
|---|---|---|---|
| LFM3-1.7B | 文本 | 文本 | 本地智能体、工具调用、结构化输出 |
| LFM3-VL-2B | 文本 + 图 + 视频 | 文本 | 首个支持视频输入的视觉模型,1.9B |
| LFM3-Audio-2B | 文本 / 音频 | 文本 / 语音 | 语音对话、转写、合成、18 种语言 |
| LFM3-Omni-2B | 全模态 | 文本 + 语音 | 首个全模态模型 |
| d1-2B | 文本 + 图 + 视频 | 带校准概率的结构化答案 | 决策类任务 |
| d1-Omni-2B | 全模态 | 同上 | 决策 + 音频输入 |
那个 d1 系列值得多说一句:它不做长文生成,你给它一个情境(比如一张工单、一张照片)加一串问题,它一次前向就把所有问题答完,每个答案带校准过的概率。
这个设计思路很实际。工单分类、票据识别、界面元素判定这类任务,你要的不是「写一段话」,而是「给个判断和置信度」。用生成式模型去凑,既慢又不稳定。
架构:24 层里只有 6 层做全局注意力
tri-hybrid 是这次的核心词。把 24 层拆开看:
- 13 层门控短卷积:卷积核大小 7(上一代是 3),负责近距离模式
- 5 层滑动窗口注意力:窗口 256 Token,负责局部关系
- 6 层全局注意力:负责整段输入的关系
注意力是长上下文的成本大头,只留 6 层做全局,剩下的用便宜的卷积和局部注意力顶,这是长上下文能跑在设备上的关键。
另外三个改动值得记:
逐头门控注意力。 给每个注意力头加一个 sigmoid 门,头没东西可说时可以直接关掉。官方说这能压制激活值的异常大值,而异常值正是量化掉点的元凶。这条对小模型很重要,因为你要靠 4bit 才能塞进 1GB。
部分 RoPE。 全局注意力层只旋转每个头的高频那一半位置编码,另一半按内容匹配、不管距离。滑动窗口层保持完整 RoPE。
三明治归一化。 每个块的输入和输出都做归一化,让激活值尺度稳定。
训练上,骨干在 22T token 上预训练,末段 3.5T 是中期训练,专门掺了更多智能体轨迹和工具调用数据,同时把上下文从基础长度拉到 256K。这个顺序有意思:先学语言,再学用工具,而不是靠后训练硬灌。
编码器是另一块硬骨头
视觉侧换了自研编码器,卷积和注意力混合,164M 参数。官方称精度对齐 Qwen3.5-2B 的视觉编码器,但 FLOPs 少 2.2 倍,比之前的 SigLIP2 方案省 3 倍算力。
视频处理有个巧思:把抽样的每两帧压成一个时间片,时间序列长度直接减半。这是用「少看几帧」换速度,对以「看懂发生了什么」为目标的场景够用。
音频侧更有意思。编码器是滑动窗口注意力加短卷积,完全因果,意思是模型可以边听边算,不用等你说完。官方给的首次出字延迟低至 50ms。
配套的 LiquidCodec 音频分词器,官方数据是单 CPU 线程上约 87 倍实时速度(Apple M4 Max),支持流式解码。这个数字如果属实,意味着语音输出的成本几乎可以忽略。
跑分:它挑了自己赢的榜
Liquid 宣传的核心是 LFM3-1.7B 用少 35% 的参数打过了自家上一代 2.6B。具体到分数:
| 测试 | LFM3-1.7B | 对比 |
|---|---|---|
| WebArena-Verified | 38.42 | LFM2.5-2.6B 3.02;Qwen3.5-9B 28.94 |
| AutomationBench | 41.29 | Qwen3.5-9B 15.10 |
| MCP-Atlas(工具调用) | 32.57 | Qwen3.5-9B 42.67 |
| SWE-bench Verified(代码) | 43.40 | Qwen3.5-9B 51.20 |
看后两行。在「浏览器长任务」和「自动化流程」上它确实超了 9B 的 Qwen,但在工具调用和代码上还是输的。
这不是说官方数据有问题,而是宣传口径的选择很正常:挑赢的说。写这篇的时候我特意把输的两项也列出来,因为很多人选型就看一张图,容易误判。
视觉模型那边,62 个视觉基准的平均分从 57.6 提到 71.4,官方称与 Gemma 4 12B 相当(对方大六倍)。音频的 UTMOSv2 语音质量分是 3.83(上代 3.22)。
许可证:免费下载,但商用有门槛
这条必须单独说,因为最容易踩。
权重可以免费下,但年营收 1000 万美元及以上的公司不在商用许可范围内。个人、小团队、研究用途没问题;公司用就得谈授权。
对比一下:Qwen 系是 Apache 2.0 完全放开,Nanbeige 也是 Apache 2.0。Liquid 这个门槛放在「端侧商用」场景里其实是硬约束,因为端侧模型最典型的买家恰恰是设备厂商和 App 公司。
接入情况
day-0 支持的名单挺长:AMD、Arm、NVIDIA、OpenRouter、Qualcomm、Vercel、Ambarella、Intel(OpenVINO)。本地推理栈那边,llama.cpp、MLX、Ollama、vLLM、SGLang、Unsloth 都能接。
Arm 那边给了一组自己测的初步数字:LFM3-1.7B 用 Q4_0 量化、开启 SME2 后,预填充约 3.1 倍、解码约 1.5 倍加速。这是 Arm 侧的口径,不是 Liquid 官方主表,参考着看。
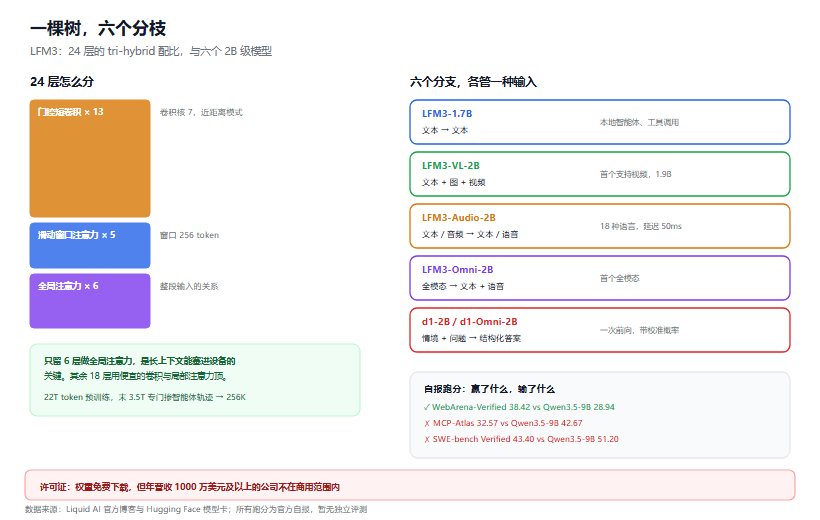
图 1:左侧是 24 层的 tri-hybrid 配比,右侧是六个模型的分支与各自的输入输出
FAQ
2B 的模型能干正事吗?
看干什么。分类、抽取、结构化输出、语音转写、界面理解这类「边界清晰」的活,2B 够用而且快。开放式推理和复杂代码不行,那不是它的目标。
为什么要一个骨干分六个头,不直接训六个模型?
省。共用骨干意味着大部分权重是共享的,部署时可以按需只装一个头,微调时也只动一小部分。对端侧这种内存寸土寸金的环境,这个结构优势很实际。
1GB 是真的吗?
官方口径是文本模型 4bit 量化后约 1GB。实测会受量化方案和运行时影响,上下浮动一些正常。
能商用吗?
营收低于 1000 万美元可以用;超过就得单独谈。这一点和 Apache 2.0 的模型差别很大,选型时先确认。
和 Gemma、Phi 这些端侧模型比呢?
同档位。差异在「一个骨干多模态」这个结构,以及决策模型这条比较少见的线。具体谁强要看你的任务,官方对比数据只覆盖它选中的榜。
结语
LFM3 的真正卖点不是分数,是结构:一个骨干、六个头、单卡可微调、1GB 能装下。
对做端侧应用的人来说,这意味着你可以先在手机上验证一个想法,再决定要不要为它单独训模型。这个「试错成本」的下降,比任何单项跑分都值钱。
前提是许可证那关过得去。
参考资料
- Liquid AI 官方博客 - LFM3 架构、训练与六个模型说明
- Hugging Face - LFM3 权重合集与模型卡(含基准明细与许可证)
- Liquid AI 文档 - 各模型的推理与微调方式
- TPS Report - LFM3 技术细节:24 层 tri-hybrid 配比与编码器设计
- 本站 Nanbeige4.3-33B 解读 - 另一个 30B 档开源选项
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。