
一句话总结:AI 说错品牌信息,多数不是模型故意使坏,是它在"对账"时发现你的信源自相矛盾,干脆挑一个说或者含混带过。解法不是跟模型较劲,是把全网关于你的信息收拾成同一套事实:先建唯一事实基准表,再逐渠道对齐,最后用固定问题集持续监测。
先看一个真事:AI 说错话,企业买单
2024 年加拿大有个判例。一家航空公司的聊天机器人告诉客户,丧亲票价可以退款——实际上这家公司没有这项政策。客户拿着聊天记录去申诉,加拿大仲裁庭裁定航空公司败诉,按聊天机器人说的赔。案子叫 Moffatt v. Air Canada,在法律圈和 AI 圈都转了一圈。
国内企业的例子更日常。百分点科技的选型文章里写过:大模型在商业问答中存在信息偏差,容易输出错误产品参数、过时企业资质。你官网挂着新品型号,AI 嘴里还是三年前那款;你早搬了地址,AI 让人去老地方找你。说错一次,用户截图发群里,公关成本比优化成本高得多。
AI 为什么会说错:它在对账,你的账对不上
要理解怎么修,先得知道 AI 怎么"想"。现在主流 AI 搜索走的是 RAG(检索增强生成)链路,大致四步:查询解析、向量召回、事实校验、答案生成。问句先转成语义向量,系统召回全网相关文档片段,模型比对多个来源,再组织答案。
关键在第三步。信源彼此印证时,模型倾向于给出确定表述;相互冲突时,它往往只能模糊、回避甚至出错。中国经济网的一篇技术解读把这一点说得很直白:这也是"AI 幻觉"在产业侧的重要成因之一。
还有一层原因:实体消歧。大模型和知识图谱要把散落在各平台的名称、地址、业务描述归并到同一家公司名下。你的信息要是有多个版本——全称和简称混用、地址电话不一、业务描述前后矛盾——实体对齐就失去了锚点,模型要么把你识别成多个主体,要么在不同版本之间摇摆。
所以 AI 说错你,大概率不是它坏。是你的账本太多本,它不知道翻哪本。
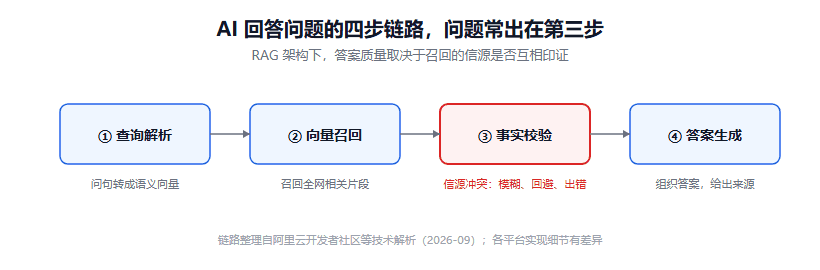
图 1:RAG 四步链路,答案质量取决于第三步召回的信源是否互相印证
先建一份"唯一事实基准表"
动手改任何渠道之前,先做一份品牌事实基准表,把这些信息写死:
| 类别 | 要写死的内容 |
|---|---|
| 主体信息 | 企业全称、简称、成立时间、注册地址、经营范围 |
| 产品信息 | 核心产品/服务的标准名称、型号、关键参数 |
| 资质证据 | 资质认证、专利、参编标准 |
| 数据口径 | 用户量、市占率等核心数字,注明统计时间和来源 |
这份表是全公司对外内容的唯一事实源。后续所有稿件、问答、官网文案,都从这同一套事实出发生成,任何人写内容前先对表。
然后是校准顺序,这个顺序经常被搞反。正确做法是先改权威渠道——官网、百科优先——再让低权威渠道向基准对齐。先改小渠道再去动官网,等于先污染信源再补救。思默 AI 的清单里还有个细节:新内容上线前先查重,别让同一事实以两种说法同时存在。
让 AI 认得出你是哪家
实体一致性的目标,是让机器确认"这是同一家企业"。第三方 GEO 服务商常用一套三层信任结构来判断进度,我把它画成了图。
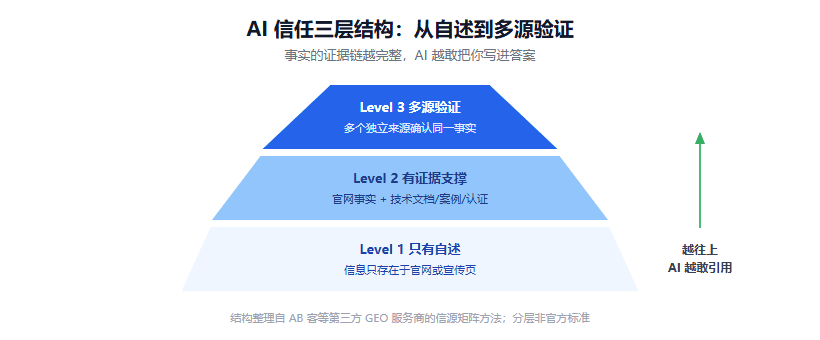
图 2:从只有自述到多源验证,事实的证据链越完整,AI 越敢引用
最底下一层只有自述:信息存在于官网或单页宣传里。这时候 AI 不是不想引用你,是它只看到你自说自话,没有第二个声音。
中间一层有证据支撑:官网事实加上技术文档、客户案例、认证、FAQ。事实开始有凭据,模型的确定表述变多。
最上面一层多源验证:多个独立来源能确认同一个关键事实。到了这层,AI 写答案时才放心把你写进去——注意,是"独立来源",你自己在十个平台发同一篇稿,算一个声音。
落到动作上,四类信源按优先级排。官网是地基,企业全称、统一社会信用代码、地址、联系方式、核心业务介绍要齐全,并且加上结构化标记:JSON-LD 写清官方名称、别名、成立时间、总部,再用 sameAs 把官网、百科、Wikidata、领英这些官方资产的地址互相挂起来,等于给 AI 一张关系网。其次是百科类,百度百科、维基百科、Wikidata,AI 经常直接引用。再次是媒体报道,第三方媒体的信任度远高于品牌自述。最后是第三方评测和用户评价。
英文圈还有个细节值得抄:sameAs 那串链接别省。模型确认"这些页面说的是同一家",靠的就是这些交叉挂起来的标识。
发现说错了,怎么修
修错误的前提是发现错误。方法不复杂:列一份固定的问题集,三十条左右,覆盖品牌词、产品词、对比词;每两周在主流 AI 平台上问一遍;记录三件事——说没说你、说了什么、引用了谁。这套做法来自 ResSO 的监测建议,他们把每轮结果打上"准确/过时/幻觉"的标签,追踪幻觉率的变化。
发现反复出现的错误说法之后,修法是:找到错误信息的源头渠道,改它;同时发布一份反叙事内容,用可被提取的格式——问答、对比表、定义式表述——把正确事实讲清楚,确保能被抓取。ResSO 的建议是反叙事要趁早发、按可提取的格式写,晚了错误说法会在网上自我复制。
有两件事别做。一是调模型的"温度"参数,底层的事实信息是错的时候,调温度只会让错误答得更稳。二是发免责声明,"AI 可能有错"这类提醒不改变模型输出什么,该错照样错。
还有一个被低估的动作:写清楚你不做什么。ResSO 的说法叫 negative clarity——幻觉经常在品牌没说的空白处编造。产品页上明说适用场景、不适用场景、关键限制,模型需要"猜"的部分就少一分。我挺认同这点,大部分企业的官网只讲自己有什么,不讲自己没什么,等于留了一堆空白给 AI 填。
FAQ
Q1:AI 说错品牌信息,能要求平台删掉吗?
能反馈,但别指望。大模型没有"搜索快照"那种固定页面可下架,它的错误来自训练数据或实时召回的片段,这次改了下次训练还可能回来。更可靠的路数是修信源:把源头渠道改过来,再发一份反叙事内容,让正确信息在多个渠道互相印证。
Q2:实体一致性要做多久才见效?
没有统一答案,我也不打算编一个。思默 AI 的口径是渠道校准完、基准表跑起来之后,AI 的引用行为会随各平台抓取周期慢慢变化;ResSO 给的参照是新的 answer-ready 内容发布后 30 天内,看它是否出现在 AI 的引用里。我的经验判断:信源改动是慢变量,按季度看趋势,别按天看。
Q3:小公司没百科没媒体,怎么开始?
从官网和能自主控制的渠道开始:官网结构化标记、官方自媒体账号、地图标注。信任结构里最底层的"自述"不是没用,它是地基。只是别停在自述——至少补一个第三方信源,行业媒体报道或第三方评测都行,让事实有第二个声音。
Q4:品牌改名或换域名,旧信息怎么处理?
旧域名做 301 跳到新域名,各平台旧资料尽量更新一遍,官网 Organization 标记里用 sameAs 把新旧资产挂起来。Search Atlas 提过一个现象叫 competitor bleed——品牌属性被安到竞品头上,改名期最容易发生,因为实体对齐的锚点断了。
Q5:这套东西和 SEO 的 NAP 是一回事吗?
思路同源,做法升级。NAP(名称、地址、电话一致)是本地 SEO 的老概念,实体一致性把它扩展到了业务描述、产品参数、数据口径。用中国经济网的说法,GEO 更接近一套企业实体治理与信任表达体系,不是关键词优化换皮。
结语:我的判断是,实体一致性是整个 GEO 里最不玄学的一部分——它不需要猜算法,只需要对账。全网信息收拾成同一套事实,AI 再说错你,你至少知道错在哪、找谁改。反过来,内容技巧学得再多,账本自己先乱了,都是白搭。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。