
开源仓库
共 8 个仓库 · 按最近更新排序
 vuejs/core
🖖 Vue.js is a progressive, incrementally-adoptable JavaScript framework for building UI on the web.
 twbs/bootstrap
The most popular HTML, CSS, and JavaScript framework for developing responsive, mobile first projects on the web.
 DIYgod/RSSHub
🧡 Everything is RSSible
 tailwindlabs/tailwindcss
A utility-first CSS framework for rapid UI development.
 Minglink/dsh-infinite-gen-5
DeepSeek v4.1 flash 逆向工具(无限五代) 求 Star 收藏 ⭐欢迎大家提交项目的改进
 xia-sc/dsh-opencode-go
DeepSeek Harness LLM provider plugin for OpenCode Go (zen-go route)
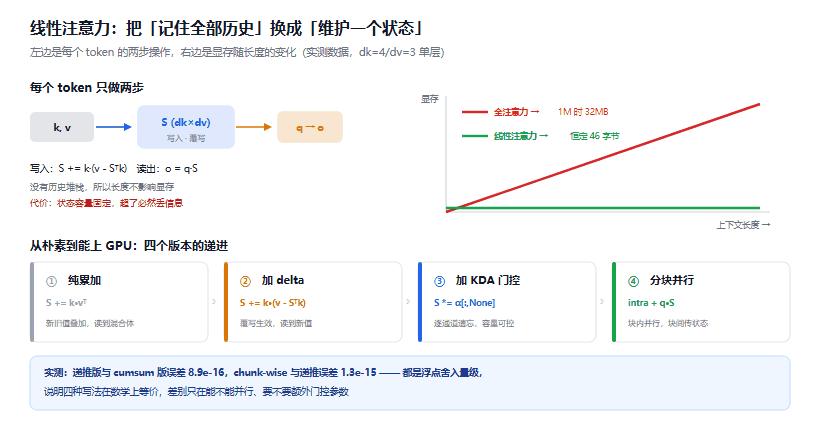
线性注意力到底省了什么:从 O(n²) 到固定状态,120 行代码跑通
一句话总结:线性注意力省掉的不是计算,是「必须记住全部历史」这个前提——把注意力查表变成对一个固定大小状态的读和写,显存从随长度线性增长变成常数;代价是容量有上限、旧信息会被覆盖。本文用120行NumPy把递推、delta覆写、逐通道遗忘门、块内并行四个版本全部实现并跑过,每一步都给了真实输出。上周写...
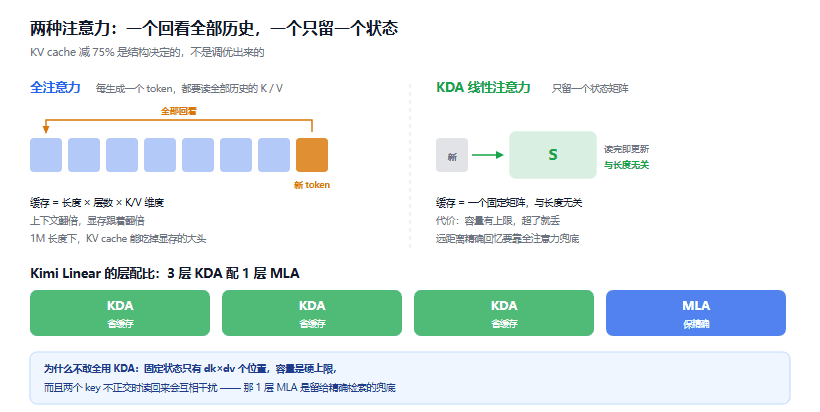
Kimi Linear 深度解读:KV cache 砍掉 75%、1M 上下文快 6 倍,线性注意力第一次真能用了
一句话总结:Moonshot今天开源的KimiLinear用「3层线性+1层全注意力」的混合结构,把KVcache砍掉最多75%、1M上下文解码吞吐提到6倍,同时短长上下文和强化学习任务全面不输纯全注意力基线;但官方自己承认外部复现还在进行,而两年前MiniMax从线性注意力退回全...