
一句话总结:Moonshot 今天开源的 Kimi Linear 用「3 层线性 + 1 层全注意力」的混合结构,把 KV cache 砍掉最多 75%、1M 上下文解码吞吐提到 6 倍,同时短长上下文和强化学习任务全面不输纯全注意力基线;但官方自己承认外部复现还在进行,而两年前 MiniMax 从线性注意力退回全注意力的先例说明这条路还没定论。
大模型这几年一直在做一件事:把上下文撑长。100 万 Token 已经不算新闻了,但撑长之后有个躲不掉的问题——推理时显存和算力都按长度线性涨。
原因在注意力机制本身。标准自注意力在生成每个 token 时,都要回头看前面所有 token,所以工程上必须把历史的 K 和 V 全缓存下来,这就是 KV cache。上下文翻一倍,缓存翻一倍;上下文到了 100 万,光缓存就能把显存吃干净。
Moonshot 今天(10 月 31 日)在 Hugging Face 放了 Kimi Linear 的技术报告和权重。它的思路不是把缓存压缩得更聪明,而是换掉整套机制:让模型只保留一个固定大小的状态,随 token 逐个更新,不再回头翻历史。
这条路叫线性注意力,学术界研究了六七年。Kimi Linear 的价值在于,它可能是第一个在「性能不输、工程能跑」两个条件同时成立的开源尝试。
规格与三个核心数字
| 项 | 值 |
|---|---|
| 总参数 / 激活参数 | 48B / 3B(MoE) |
| 层结构 | 每 4 层里 3 层 KDA(线性注意力)+ 1 层 MLA(全注意力) |
| 训练 token | 1.4 万亿 |
| KV cache 降幅 | 最多 75% |
| 1M 上下文解码吞吐 | 最多 6 倍(对比同规格全注意力基线) |
| 开源内容 | 权重、KDA 内核、vLLM 集成、检查点 |
| 基座对比 | 相同训练配方下的纯 MLA 基线 |
| 许可证 | 需查 HF 仓库页确认,本文不做假设 |
官方给的三个数字:KV cache 最多减 75%、1M 上下文解码吞吐最多 6 倍、在短上下文、长上下文、强化学习三类任务上全面超过同配方的纯全注意力基线。
三个「最多」都有限定语。6 倍是在 1M 上下文、解码阶段的峰值,短上下文下这个优势会缩到很小,因为那时 KV cache 本来就不大。这点后面单独讲。
KDA:把遗忘门从一个数变成一串数
要理解 Kimi Linear 改了什么,得先知道线性注意力的老问题。
线性注意力把注意力算成一个固定大小的矩阵状态 S,尺寸是 dk × dv(key 维 × value 维)。每读一个 token 就更新一次状态。没有历史缓存,显存不随长度涨,这是它全部吸引力的来源。
但老版本有个毛病:只加不减。新信息不断往状态里累加,旧信息永远抹不掉,时间一长状态里塞满了互相干扰的残影。表现就是「记得住大概、记不清具体」。
Gated DeltaNet 用两步改善了这件事。一是加衰减门 α,让旧内容随时间淡化;二是加「Delta 规则」,写入时不是简单加上 v,而是加上「v 减去当前状态读出来的值」:
S_t = (I - β_t·k_t·k_t^T) · α_t · S_{t-1} + β_t · k_t · v_t^T那个减法的意义是「先擦再写」:如果这个 key 位置已经有内容,先把它抹掉,再写新的。这样同一个事实被更新时,不会新旧两份叠在一起。
Kimi Linear 的 KDA(Kimi Delta Attention)改的是 α 的形状。原来 α 是每个 head 一个标量,所有 key 通道共用一个遗忘速度;KDA 把它变成 dk 维向量,每个 key 通道有自己独立的遗忘率:
S_t = S_{t-1} · Diag(α_t) + β_t · (v_t - S_{t-1}·k_t) · k_t^T差别在哪?打个比方:原来的模型像一本笔记,只能整体决定「这一页要不要撕掉」;现在能逐行决定哪一行模糊、哪一行清晰。对长文档和长对话这种信息密度不均匀的场景,这个粒度差别是实质性的。
顺带说个旁证:Kimi K3(今年早些时候的旗舰)的 93 层注意力里,有 69 层用的就是 KDA。这说明它不是实验室里的新玩具,已经在主力模型上跑过。
混合架构:为什么不敢全用线性
这是我认为整篇最值得说的地方。
Kimi Linear 没有把所有层都换成 KDA,而是 3 层 KDA 配 1 层 MLA(全注意力)。为什么留那一层?
因为固定大小的状态有个数学上的硬上限:它只有 dk × dv 个位置。信息一旦超过这个容量,就必须扔掉一些。而且读回来的时候,如果两个 key 不正交,它们的值会互相干扰。所以对「精确回忆很久之前某个具体细节」这类任务,纯线性结构做不到。
那一层全注意力就是用来兜底的:它保留完整历史,负责精确检索;KDA 层负责长距离的模糊记忆和整体吞吐。两者分工,不是互相替代。
这个设计不是 Kimi 独创。Qwen3.5 用的是 3:1 的 Gated DeltaNet 与全注意力混合,Qwen3-Next 同思路,NVIDIA 的 Nemotron 3 是 Mamba-2 状态空间层配注意力层。混合已经是当前主流的工程答案。
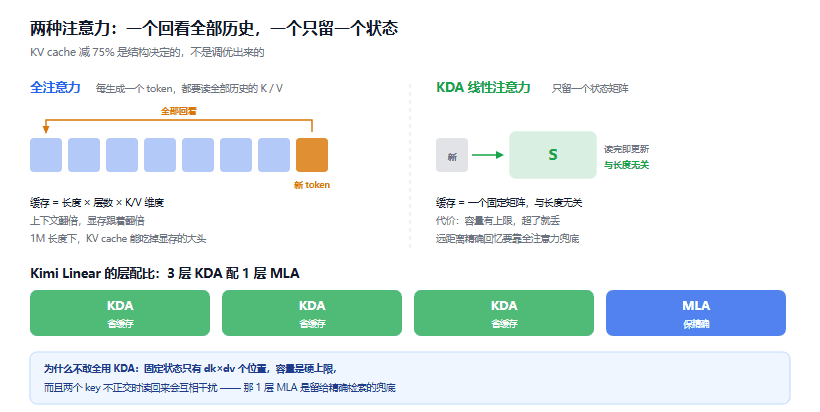
图 1:左边是全注意力必须缓存全部历史,右边是 KDA 只留一个固定大小的状态;下方是 3:1 混合层的分工
一个反面先例,必须提
2025 年初,MiniMax 的 MiniMax-01 用了很激进的配比:7 层 lightning attention 配 1 层 softmax 注意力。当时也是主打长上下文吞吐。
但后来的 MiniMax M2,回到了纯全注意力。
这个转向值得认真对待。它至少说明:效率上的优势,不必然换算成最终效果上的优势。当训练规模、数据质量、后训练配方都在快速变化时,架构层面的效率收益可能被别处的提升盖过去。
所以我读 Kimi Linear 这份报告时,最在意的不是那三个数字,而是报告里那句话:外部复现还在进行中。这句话的意思是,目前所有成绩都来自 Moonshot 自己的实验设置。第三方用同样的混合结构但不同的训练数据,会不会复现同样的结论,现在还不知道。
工程落地:vLLM 那边改了什么
架构再漂亮,推理框架不支持就等于零。Kimi Linear 这次把 KDA 内核和 vLLM 集成一起开源了,这一点比数字更有诚意。
在 vLLM 里支持混合注意力,要解决的核心问题是显存管理。全注意力层的缓存是「每个 token 一段 K 和 V,随长度线性增长」,KDA 层的状态是「每个请求一个固定大小的矩阵,长度无关」。两种形态混在一个模型里,分页管理就乱了。
公开的工程说明里提到两个处理:一是 KVCache Group,把规格相同的层分组共用 Block Table,减少调度元数据开销;二是 UniformTypeKVCacheSpecs,允许把异构层合并,让 Page Size 等于组内各层之和。此外 KDA 的状态还需要做对齐处理,否则并行计算时访存会错位。
这些细节听起来枯燥,但它们决定了一件事:你能不能在自己的机器上真的跑起来,还是只能读论文。
优势与短板
优势:长上下文场景的显存占用和吞吐改善是数量级的;权重、内核、推理集成都开源,不是只发论文;KDA 已经在自家旗舰上验证过,不是纯研究品;混合结构留了全注意力兜底,避免了纯线性模型的召回短板。
短板,官方和社区都提到过的:
一是外部复现未完成,所有对比都在同一实验设置下,横向可比性待验证。
二是覆写不增加容量。Delta 规则能改善「同一位置更新」,但状态尺寸没变,塞进去的信息总量上限没变,超了照样丢。
三是 6 倍吞吐有强前提:1M 上下文、解码阶段。日常 8K 对话里这个优势很小,因为那时 KV cache 本来只占几百 MB,砍掉 75% 也没省多少。想验证的话,压测方法那篇给了完整的分位测法。
四是长尾风险没被完全消除。非正交 key 的相互干扰是数学性质,不是工程能修的,只能靠全注意力层补。
五个问题
Kimi Linear 是 Kimi K3 的下一代吗?
不是同一个东西。Kimi Linear 是架构研究报告加 48B 的验证模型,K3 是旗舰产品。KDA 已经在 K3 上用了,Kimi Linear 更像把这个机制单独拎出来做公开验证。
普通开发者能用吗?
权重和推理代码都放出来了,理论上能跑。但 48B 总参、3B 激活,INT4 量化后大概还要 25GB 上下显存(粗估,我没实测),消费卡跑不动,得有 A100/H100 级别或者多卡,算显存的思路可以照那篇套。
KV cache 减 75% 是怎么算出来的?
按 3:1 的层配比,那 3 层 KDA 完全不存 KV cache,只有 1 层 MLA 存。理论上缓存就降到原来的 1/4,也就是减 75%。这是结构决定的,不是测出来的,所以这个数字比较可靠。
不是。Clover 那篇里换的是「生成方式」,用并行去噪代替逐 token 生成;Kimi Linear 换的是「注意力计算方式」,用固定状态代替历史缓存。两者都在解决同一类问题的不同侧面:怎么让长上下文不那么贵。
值不值得现在跟进?
如果业务重度依赖长文档、长对话、Agent 多轮,值得看,这个方向的收益是实打实的。如果只是普通问答,收益有限,等第三方复现结果出来再决定更稳。
结语
Kimi Linear 我觉得是这个月最值得读的一份开源报告,不是因为数字漂亮,而是因为它把「线性注意力能不能真的用」这个问题往前推了一步,而且把工程实现一起交了。
但我不认为现在就该宣布「全注意力要退役」。MiniMax 从 7:1 退回全注意力的先例还在,官方自己承认外部复现未完成,而混合结构本身就说明纯线性走不通。更准确的判断是:混合架构正在成为长上下文模型的标准形态,全注意力从「唯一选择」变成了「兜底的那几层」。
真正值得关注的时间点是第三方复现出来的那一天。那时候才能知道,1.4 万亿 token、3:1 配比、KDA 这三个东西,哪个才是收益的主要来源。
参考资料
- Kimi Linear 技术报告(Hugging Face) - 模型卡与权重、KDA 内核、vLLM 集成
- Moonshot AI 发布 Kimi Linear - 三项核心技术的中文概述与官方数据转述
- KDA 机制与 vLLM 工程实现解析 - 状态更新公式推导、Chunk-wise 并行、KVCache Group 细节
- Linear Attention 与状态空间模型综述 - Delta 规则的数学来源、容量上限的说明、混合架构对照
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。