
一句话总结:通用榜测的是通用能力,你的业务任务是特定的,两者不是一回事。这篇给一套 60 行可跑的评测框架(确定性判分、按 tag 分组统计、失败明细可回溯)、任务从哪收集、四层难度怎么配比,以及「越调越窄」这个最隐蔽的坑怎么防。
上一篇讲完三层上下文,留了个尾巴:怎么判断 Agent 干得好不好。
这不是个形式问题。没有验收标准,你就没法迭代,因为每次改动之后你只能凭感觉说「这次好像好点」。而感觉在 AI 项目里格外不可靠——模型的输出很长、很有条理、看起来都对,你很难靠读几段就判断它是不是真的更准了。
为什么公开榜单不能直接用
有人会说,直接跑 MMLU、SWE-bench 不就完了。
三个原因。
任务不对。 SWE-bench 测的是修 GitHub issue,你的 Agent 干的是查报表、核对数据、生成周报。这两件事在能力上不重叠——一个模型能在 SWE-bench 上刷到 70%,同时把你公司「GMV 不含退款」这条规则搞错,因为后者不在任何公开语料里。
数据污染。 公开榜的题目早就进了训练集,分数虚高。你自己出的题不会。
没有回归能力。 换了模型或者改了 prompt,榜单分数可能从 70 涨到 72,但你怎么知道你的具体任务没退化?公开榜给不了这个答案。
所以得自己建。好消息是这件事比想象中轻:20 个任务、一个下午,比接一个评测平台有用得多。想知道一个跑起来的 Agent 到底哪一步出了问题,还可以配合可观测性那篇的日志结构一起用。
前置条件
Python 3.9+(标准库,json + re 就够)
一份能跑通的任务清单(下面讲怎么收集)
不需要 LangSMITh、不需要 Promptflow。第一版用脚本加 JSON 文件就能跑。
任务从哪来
三个来源,按质量排。
第一优先:真实工单和聊天记录。 过去三个月你的团队实际问过的问题,尤其是那些「问了两遍才说清楚」的和「答错了被发现的」。这些是天然的评测题,因为它们是真实需求,而且你已经知道正确答案是什么。
第二优先:你踩过的坑。 上次 Agent 把「分」当成「元」、把退款算进 GMV、把测试账号算进月活。每一个错误都该变成一个用例,永久留在集子里。这类题的通过率提升最直接对应真实体验改善。
第三优先:编造的边界题。 空数据、超长输入、矛盾指令、恶意注入。这类题不需要真实来源,但能拦住大部分低级事故。
不要用:从网上抄的「100 道 AI 测试题」。那些题没有你的业务语义,测出来只能说明模型通识能力,和你要判断的事无关。
20 个任务的配比
数量少不是问题,结构失衡才是。我用的配比:
| 层级 | 数量 | 特征 | 判分方式 |
|---|---|---|---|
| 简单 | 6 | 单步、答案唯一 | 精确匹配 |
| 中等 | 8 | 多步、需要读上下文 | 正则 / 结构校验 |
| 复杂 | 4 | 跨系统、需要判断 | 关键要素齐全 |
| 边界 | 2 | 空数据 / 矛盾指令 | 应该拒绝或澄清 |
简单题的作用是快速发现回归——每次改完先跑这 6 个,5 秒内就知道有没有崩。
复杂题和边界题通过率天然低,别把它当 KPI。它们的作用是暴露「模型在什么情况下会自信地胡说」,这类信息比分数值钱。
判分:优先确定性,慎用模型裁判
判分方式是整个评测里最容易走错的一步。
我见过太多团队直接上「让 GPT 打分」,理由是省事。它确实省事,但有三个问题:
不稳定。 同一个输出,跑两次可能给不同分数。这让回归测试失去意义——你分不清是模型变了还是裁判变了。
有偏好。 模型裁判普遍偏爱长回答、结构化的回答、语气自信的回答。一个啰嗦但错误答案,可能比一句准确的短答得分更高。
不可回归。 裁判本身会随版本更新变化,你的历史分数没有可比性。
所以顺序应该是:精确匹配 > 正则/结构校验 > 关键要素齐全 > 模型裁判。只有当前三种都做不到时,才用裁判,而且必须固定裁判模型版本、固定评分提示词。
一个 60 行的框架
下面这套我跑过,共 5 个用例、4 通过 1 失败,输出就是后面贴的那样。
import json, re
from dataclasses import dataclass, field

@dataclass
class Case:
    cid: str
    task: str
    checker: str          # exact / regex / json_keys
    expect: object
    tags: list = field(default_factory=list)

def check(case, output):
    """确定性判分:三种,全部无网络依赖"""
    if case.checker == "exact":
        return output.strip() == str(case.expect).strip()
    if case.checker == "regex":
        return re.search(case.expect, output) is not None
    if case.checker == "json_keys":
        try:
            got = json.loads(output)
        except json.JSONDecodeError:
            return False
        return all(k in got for k in case.expect)
    raise ValueError(case.checker)

def run(agent_fn, cases):
    rows = []
    for c in cases:
        try:
            out = agent_fn(c.task)
            ok = check(c, out)
            err = ""
        except Exception as e:
            out, ok, err = "", False, type(e).__name__
        rows.append((c, out, ok, err))
    return rows

def report(rows):
    total = len(rows)
    passed = sum(1 for _, _, ok, _ in rows if ok)
    print(f"总通过 {passed}/{total} = {passed/total:.0%}")
    by_tag = {}
    for c, _, ok, _ in rows:
        for t in (c.tags or ["untagged"]):
            by_tag.setdefault(t, [0, 0])
            by_tag[t][1] += 1
            by_tag[t][0] += int(ok)
    for t, (p, n) in sorted(by_tag.items()):
        print(f"  {t:<10} {p}/{n}  {p/n:.0%}")
    print("\n失败明细:")
    for c, out, ok, err in rows:
        if not ok:
            print(f"  [{c.cid}] {c.task[:24]} | 期望 {c.expect!r} | 得到 {out[:30]!r} {err}")
配五个用例,覆盖金额换算、统计、格式、口径这几类:
cases = [
    Case("c1", "把 12800 分换算成元", "exact", "128.00", ["金额"]),
    Case("c2", "统计 2026Q3 的 GMV", "regex", r"^\d+(\.\d{2})?$", ["统计"]),
    Case("c3", "返回订单的 JSON 摘要", "json_keys",
         ["order_id", "amount", "status"], ["格式"]),
    Case("c4", "退款订单算不算 GMV", "regex", r"不算|排除|不计入", ["口径"]),
    Case("c5", "查上月月活", "regex", r"^\d+$", ["统计"]),
]
用一个假的 agent 函数跑一遍,输出:
总通过 4/5 = 80%
  口径         1/1  100%
  格式         1/1  100%
  统计         1/2  50%
  金额         1/1  100%

失败明细:
  [c2] 统计 2026Q3 的 GMV | 期望 '^\d+(\.\d{2})?$' | 得到 '约 3200 万'
这个失败正说明判分的价值。模型答的「约 3200 万」在人类看来是对的,但它的格式不可编程——你没法拿它去填表、算环比、做图。这时候有两种处理:要么改 prompt 要求只输出数字,要么放宽判分标准。
我的选择是改 prompt,不放宽标准。 因为在真实场景里,下游系统要的就是能算的数。判分标准一旦为「模型答得也不容易」而让步,评测就失去了判定能力。
最隐蔽的坑:越调越窄
这个坑值得单独讲,因为它会在你毫不知情的时候发生。
现象是:你天天跑评测集,分数从 60% 涨到 95%,但你团队的体感是「好像还是不太行」。原因是你把 prompt 和上下文改成了只对这 20 个任务有效——模型学会了在这些具体问题上表现好,而不是学会了这类问题的方法。
三个防法。
留出集。 20 个题里拿出 5 个,只在阶段评审时跑,平时绝不看、绝不针对性优化。这 5 个的分数才是真实水平。
定期换题。 每两个月往集子里换掉 3-4 个老题,换成当季真实工单。老题留着作为稳定性参考,但不参与调优决策。
看失败分布,不只看通过率。 如果所有失败都集中在同一类任务上,说明那类任务真的难;如果失败在不同类型之间随机跳,说明你的 Agent 输出不稳定,这个比分数低更麻烦。
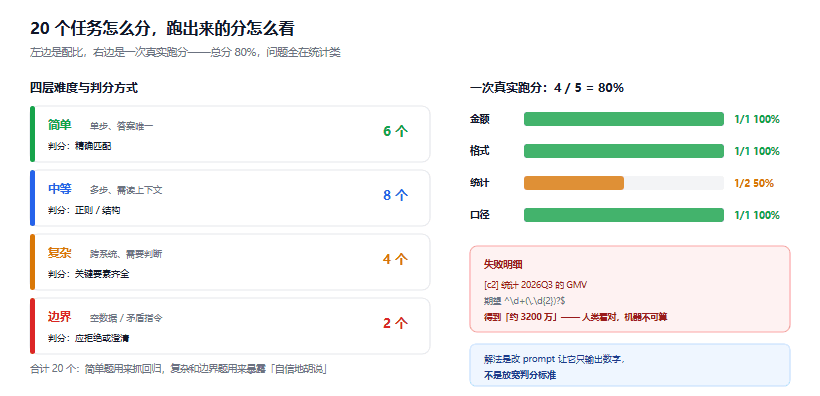
图 1:左边是四层难度与对应判分方式,右边是一次真实跑分——总分 80%,但统计类只有 50%
坑清单
1. 用例里混进了带时间的期望值。
写「本月 GMV 应该是 3200 万」,这个月过了就失效了。期望值要么用相对判断(如「大于 0 且小于 1 亿」),要么在用例里显式带时间参数。我第一版就因为写死日期,一个月后整个集子全红。
2. 判分函数自己没测过。
你的 check() 有 bug,就会一直告诉你「通过」。花十分钟写几个反例验证:正确输出该过、错误输出该挂、异常输出不该崩。判分器错了,整个评测就是安慰剂。
3. 把所有异常都当失败,看不出区别。
超时、返回空、格式错、答错,这是四种不同的问题,改法完全不同。上面代码里 err 字段就是干这个的,一定要打出来。
4. 只统计总通过率,不分 tag。
总通过率 80% 什么信息都没有。按金额/统计/口径/格式分组之后,你会立刻看到是「钱算错了」还是「话说得不对」,这两件事的修法差得很远。
5. 拿评测分数当上线门槛,但没人看失败明细。
分数是给决策用的,明细是给改进用的。只看分数的评测,三个月后一定没人再跑了。
收尾
这套东西加起来不到 100 行,一个下午能搭完。它的价值不在于给你一个分数,而在于让「Agent 变好了」这件事变成一个可验证的判断,而不是感觉。
三篇到这里是个完整的链条:先知道为什么企业 AI 落地难(数据说 84% 卡住),再补上缺的上下文,然后用评测把改进变成可验证的。缺任何一环,另外两环都会失效——没有上下文,评测题只能测通识;没有评测,上下文改得对不对你永远不知道。
如果只做一件事,我建议先做评测。理由很实际:它最便宜,而且能立刻暴露你原来没注意到的问题。我第一批 5 个用例跑完,才发现模型在金额单位上一直错得很稳定——如果不是评测,这个错误会在财务报表里躺三个月。
参考资料
- Creating AI value with enterprise context(MIT Technology Review Insights) - 上下文缺失导致 ROI 低的数据来源
- SWE-bench 官方说明 - 公开榜的评测方法与数据污染讨论
- Model Context Protocol 官方文档 - 如果要把评测接入 MCP 工具链
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。