
一句话总结:线性注意力省掉的不是计算,是「必须记住全部历史」这个前提——把注意力查表变成对一个固定大小状态的读和写,显存从随长度线性增长变成常数;代价是容量有上限、旧信息会被覆盖。本文用 120 行 NumPy 把递推、delta 覆写、逐通道遗忘门、块内并行四个版本全部实现并跑过,每一步都给了真实输出。
上周写 Kimi Linear 时留了一句没展开:KV cache 减 75% 是结构决定的。这篇把「结构」两个字拆开,用能跑的代码讲清楚。
不涉及训练,只讲推理时那个状态是怎么算的。看懂之后,你再看任何线性注意力或状态空间模型的论文,公式部分就不会卡住了。
前置条件
Python 3.9+
numpy(本文实测环境 2.5.4)
不需要 GPU、不需要 PyTorch。所有代码在 CPU 上跑,序列长度用 6 是为了方便打印,换成 100 万只是算得慢一点,逻辑不变。
第一步:先说清楚全注意力贵在哪
标准自注意力对每个位置 t,算出它对所有位置的注意力权重:
Attention(Q, K, V) = softmax(Q·Kᵀ / √d) · V麻烦在于 Q·Kᵀ 是个 n×n 矩阵。n 是序列长度,n = 100 万时这个矩阵有 1 万亿个元素。虽然实践中没人真的把 n×n 全算出来(flash attention 用分块避免物化),但自回归生成时必须缓存历史的 K 和 V,因为每生成一个新 Token 都要和前面所有 token 算一遍。
这个缓存就是 KV cache,大小是 长度 × 层数 × 2 × d。它是线性增长的,但基数大,所以到了长上下文就吃光显存。
具体感受一下。单层、dk = 4、FP32、只算 K 和 V:
| 上下文长度 | 全注意力缓存 | 线性注意力状态 |
|---|---|---|
| 8,192 | 0.25 MB | 0.000046 MB |
| 131,072 | 4.00 MB | 0.000046 MB |
| 1,048,576 | 32.00 MB | 0.000046 MB |
右边那一列是常数,因为它根本不随长度变。这是同一维度下(dk=4, dv=3)的对比,放大到真实的 d=128 也是同一个规律:左边继续涨,右边还是那个数。
第二步:把 softmax 拿掉,矩阵乘法就能换序
线性注意力的全部秘密在一个代数事实:矩阵乘法满足结合律。
原来的顺序是先算 Q·Kᵀ(n×n),再乘 V。如果去掉 softmax,表达式就变成:
(φ(Q) · φ(K)ᵀ) · V = φ(Q) · (φ(K)ᵀ · V)右边括号里那个 φ(K)ᵀ · V 的形状是 dk × dv,跟序列长度完全无关。也就是说,可以先把所有 K 和 V 压成一个固定大小的矩阵,之后每次查询只需要用 Q 去乘它。
这个 dk × dv 的矩阵,就是「状态」。
代价也很清楚:softmax 不只是归一化,它带来的是「查询能动态选择关注谁」的能力。去掉它之后,注意力权重退化成内积,模型失去了根据上下文调整关注点的机制。后面所有的改进(门控、delta 规则)本质上都在想办法把这个能力部分补回来。
第三步:最朴素的实现,两种写法验证
先写逐 token 递推版,这是最直观的形式:
import numpy as np

def linear_attn_recur(Q, K, V):
    """逐 token 递推:每读一个 token 就更新状态,再读出来"""
    T, dk = K.shape
    dv = V.shape[1]
    S = np.zeros((dk, dv))          # 状态,与长度无关
    outs = []
    for t in range(T):
        S = S + np.outer(K[t], V[t])   # 写入:k 和 v 的外积累加
        outs.append(S.T @ Q[t])        # 读出:用 q 去查状态
    return np.array(outs)
再写一个等价的矩阵版本,利用因果性做前缀和:
def linear_attn_cumsum(Q, K, V):
    KV = np.einsum('ti,tj->tij', K, V)   # [T, dk, dv]
    S = np.cumsum(KV, axis=0)            # 前缀和 = 每个位置的状态
    return np.einsum('tkv,tk->tv', S, Q)
跑一遍对比(T=6, dk=4, dv=3,随机数据):
递推 vs cumsum 最大误差: 8.88e-168.88e-16 是双精度浮点的舍入误差量级,可以认为完全一致。这个验证很重要:它说明「逐 token 递推」和「前缀和并行」是同一个数学对象的两种算法。前者好理解,后者好在 GPU 上并行。
第四步:只累加会发生什么
上面那版有个隐藏问题。S = S + outer(k, v) 只加不减,同一个 key 反复写入时,值会一直叠加。
用一组手算就能看到后果:让 key 固定为 [1,0,0,0],先写 v = [5,0,0],再写 v = [9,0,0]。
K1 = np.array([1.0, 0, 0, 0])
S = np.zeros((4, 3))
for v in (np.array([5.0, 0, 0]), np.array([9.0, 0, 0])):
    S = S + np.outer(K1, v)
print((S.T @ K1).round(4))
输出:
[14. 0. 0.]读回来是 14,也就是 5 + 9。同一个位置的旧值没有被替换,只是叠在了一起。
模型里的后果是:事实更新时(比如「预算从 500 万调到 800 万」),状态里同时存着新旧两个数字,读出来是个混合体。这就是早期线性模型「记得住大意、记不准细节」的根源。
第五步:delta 规则,写入误差而不是数值
解法叫 Delta 规则,思路是:写入之前先看看这个位置现在是什么,只写差值。
def linear_attn_delta(Q, K, V, beta=1.0):
    S = np.zeros((K.shape[1], V.shape[1]))
    outs = []
    for t in range(len(Q)):
        err = V[t] - S.T @ K[t]              # 当前状态在这里读出多少
        S = S + beta * np.outer(K[t], err)   # 只写入「目标值 - 现值」
        outs.append(S.T @ Q[t])
    return np.array(outs)
同样跑那个例子:
delta 覆写后读出: [9. 0. 0.]      ← 旧值被替换
纯累加后读出:     [14. 0. 0.]     ← 旧值叠加进来
9 而不是 14,说明覆写成功。这就是 delta 这个名字的由来:写的是变化量(delta),不是绝对值。
放到公式里看更清楚。原来的纯累加是 S_t = S_{t-1} + k_t·v_tᵀ,delta 版是:
S_t = (I - β·k_t·k_tᵀ)·S_{t-1} + β·k_t·v_tᵀ那个 (I - β·k·kᵀ) 就是「先沿 k 方向擦掉旧的,再写新的」。β 控制擦除强度,β = 1 且 k 是单位向量时,写完读回来严格等于 v。
第六步:KDA 把遗忘门从一个数变成一串数
有了覆写还不够。状态容量固定,塞满了怎么办?得能主动遗忘。
最早的做法是加一个标量衰减 α:
S_t = α·S_{t-1} + β·k_t·(v_t - S_{t-1}ᵀ·k_t)ᵀα 是一个数,所有 key 通道一起按同一个速度衰减。问题在于真实文本里信息密度是不均匀的:有些特征需要长期保留(比如产品名),有些很快就该忘(比如「你好」)。
KDA(Kimi Delta Attention)把 α 从标量升成 dk 维向量,每个 key 通道一个遗忘率:
def kda(Q, K, V, alpha, beta=1.0):
    """alpha: [T, dk],每个时间步、每个 key 通道独立的遗忘率"""
    T, dk = K.shape
    S = np.zeros((dk, V.shape[1]))
    outs = []
    for t in range(T):
        S = S * alpha[t][:, None]        # 逐通道衰减(关键的一行)
        err = V[t] - S.T @ K[t]
        S = S + beta * np.outer(K[t], err)
        outs.append(S.T @ Q[t])
    return np.array(outs), S
注意 alpha[t][:, None] 这个 reshape:alpha[t] 是长度 dk 的向量,转成 [dk, 1] 之后才能和 [dk, dv] 的状态逐行相乘,实现「每一行(也就是每一个 key 通道)用自己那个衰减率」。
实测(T=6, dk=4, dv=3, α 全取 0.9):
KDA 输出 (6, 3) 状态 (4, 3) | 含 NaN: False形状正常,没有数值爆炸。真实的 α 不是常数,由输入经过一个小线性层加 sigmoid 算出来,这样模型自己决定哪些通道该忘得快。
第七步:块内并行,这是能上 GPU 的关键
到这里所有版本都是逐 token 循环。Python 里循环 100 万次要跑几分钟,GPU 又最讨厌顺序依赖,所以必须改成并行。
办法是把序列切成块(chunk),块内用矩阵乘法一次算完,块与块之间只传状态:
def linear_attn_chunkwise(Q, K, V, C=2):
    outs = []
    S = np.zeros((K.shape[1], V.shape[1]))
    for start in range(0, len(Q), C):
        q, k, v = Q[start:start+C], K[start:start+C], V[start:start+C]
        n = len(q)
        # 块内:只算块内之前的 key,用下三角 mask
        mask = np.tril(np.ones((n, n)))
        intra = (mask * (q @ k.T)) @ v
        # 块外:用进入本块时的状态
        inter = q @ S
        outs.append(intra + inter)
        S = S + k.T @ v        # 块结束,更新状态
    return np.vstack(outs)
验证它和逐 token 递推是否等价:
chunk-wise(块=2)vs 递推最大误差: 1.33e-15也是浮点误差级别,等价。
这个改写是整个工程落地的命门。块大小 C 决定了并行度:C 越大,块内矩阵乘法越大、GPU 越饱和,但块内那部分退化成近似全注意力(要算 C×C 的 mask 矩阵),显存优势被削弱。Kimi Linear 选的是 32,这个数不是随便定的。
顺带说,KDA 带门控之后这个改写没那么直白,因为门控让状态更新变成非线性。公开的解法是把它重写成仿射变换 S_t = S_{t-1}·T_t + H_t,这样块内就能用下三角线性方程组求解。这也是为什么 KDA 的工程实现比数学描述复杂得多。
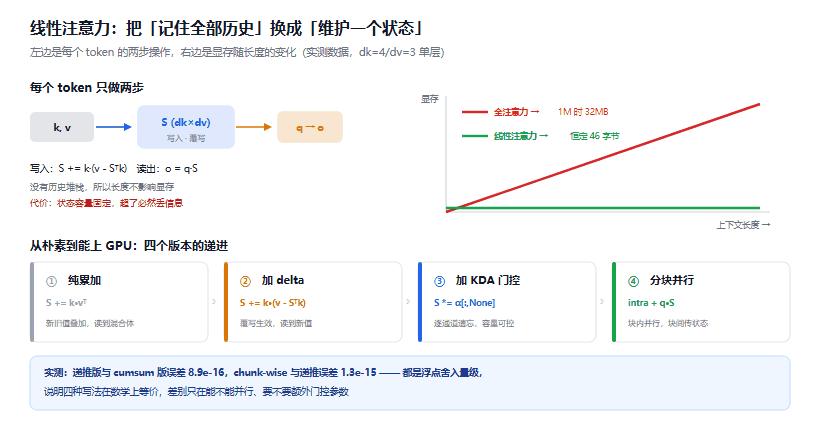
图 1:左边是全注意力的缓存随长度线性涨,右边是线性注意力只读写一个固定状态;下方一列是四个实现版本的递进
坑清单
按我自己踩到的顺序排,第一条最容易中。
1. einsum 的维度标注搞混,报广播错误。
写 np.einsum('tij,tj->ti', S, Q) 时,S 是 [T, dk, dv]、Q 是 [T, dk],j 在两边指的是不同维度,直接报 operands could not be broadcast。改成 'tkv,tk->tv' 才对。教训是 einsum 的下标一定和实际形状对应着写,别图省事复用字母。
2. 忘了 [:, None],逐通道衰减变成整体缩放。
S * alpha[t] 会尝试广播 [dk, dv] * [dk],numpy 默认按最末一维对齐,实际变成「按 dv 维乘」,语义完全错了还不报错。必须显式 alpha[t][:, None] 变成 [dk, 1]。
3. 以为非因果版本能直接用。
(Kᵀ·V) 这种矩阵形式不带因果掩码,会把未来 token 的信息算进去。训练时如果直接用它,模型在训练阶段就能偷看答案,loss 会异常低,上线后崩。因果必须靠前缀和或分块 mask 实现。
4. 用纯累加版验证,误以为 delta 没用。
如果只测「不同 key 写不同值」,纯累加和 delta 的结果一样,看不出差别。必须专门构造「同一个 key 写两次」的用例,才能暴露覆写是否生效。我第一版验证就漏了这个,白跑一轮。
5. 拿 dk×dv 的玩具尺寸估算真实显存,差了三个数量级。
dk=4、dv=3 时状态只有 46 字节,看着像白送。真实模型 d=128、32 个头,状态是 128 × 128 × 4 字节 × 32 头 ≈ 2MB 每个请求每层,几十层叠起来也是几百 MB。省是省,但不是零。
收尾
这 120 行的价值不在于能替代生产实现,而在于把「线性注意力到底省了什么」这件事变得可验证。我跑完最大的收获是两点:
一是省的东西很具体:省掉的是「必须保留全部历史」这个约束,换来一个常数大小的状态。这不是压缩,是换了一种记忆方式。
二是代价也很具体:容量固定意味着必然丢信息,覆写只是让丢得更聪明。所以所有这类模型都是混合结构,留几层全注意力做精确检索。谁要是说「纯线性注意力全面超越全注意力」,那基本可以判断他没跑过长上下文检索任务。
想继续往下走,两条路。一条是往上:看 Mamba-2 和 Gated DeltaNet 的论文,对比门控形式的不同。一条是往横:去 Kimi Linear 的仓库读 vLLM 集成那部分,看状态对齐在工程上到底怎么处理。想知道这些改动在真实吞吐上值多少钱,就得自己压一遍,压测方法那篇给了完整的分位测法。
参考资料
- Kimi Linear 技术报告(Hugging Face) - KDA 的原始定义、3:1 层配比、开源内核
- Linear Attention 与状态空间模型综述 - delta 规则的数学推导与容量上限说明
- KDA 机制与 vLLM 工程实现 - 状态更新公式、chunk-wise 并行的代数结构
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。