
一句话总结:文档解析工具不是「谁分数高选谁」,而是四类方案各自解决不同层的问题——文本层提取、版面分析、视觉模型、云端 API。本文用一份真造的双栏带表 PDF 跑了一遍文本层提取,直观看到结构是怎么丢的,再给出三条选型判断线。
先说清楚这篇的实证范围
我本机只有一张 6GB 的 RTX 2060,跑不了几个主流解析工具(MinerU、Docling、Marker 都要下载 1-3GB 模型)。所以这篇的分工是:
真跑过的:pypdf 在一份我构造的双栏带表格 PDF 上的提取效果。这一档最能说明「为什么需要更重的工具」。
没真跑的:MinerU、Docling、Marker、小米 OCR-0。这部分数据来自官方文档、GitHub issue 和社区反馈,文中会标注来源。
我不把没跑过的写成跑过。如果你要拿这篇做采购决策,请以自己样本上的实测为准。
实验:一份看起来简单的 PDF,结构是怎么丢的
我用 reportlab 造了一页 A4,内容是真实的财务摘要形态:
- 一个标题
- 双栏布局:左栏四行正文 + 一个 3×3 表格,右栏一段公式说明
- 底部一行小字注明来源
页面长这样(简化):
┌─────────────────────────────────────────┐
│ Q3 Financial Summary                    │
│                                         │
│ Revenue grew 23% ...    │ Margin formula  │
│ driven mainly by ...    │                 │
│ Gross margin held ...   │ M = (R - C)/R   │
│ below the 73.2% ...     │                 │
│                         │ Where R is net  │
│ ┌──────┬─────┬─────┐    │ revenue...      │
│ │ Item │2025 │2026 │    │                 │
│ ├──────┼─────┼─────┤    │                 │
│ │ Rev  │8745 │10752│    │                 │
│ │Gross │6262 │7698 │    │                 │
│ └──────┴─────┴─────┘    │                 │
│ Source: internal ...                    │
└─────────────────────────────────────────┘
然后跑 pypdf:
from pypdf import PdfReader
r = PdfReader("sample.pdf")
print(r.pages[0].extract_text())
输出是(完整,未删改):
Q3 Financial Summary
Revenue grew 23% quarter over quarter,
driven mainly by enterprise renewals.
Gross margin held at 71.6%, slightly
below the 73.2% target set in Q2.
Item
2025
2026
Revenue
8,745
10,752
Gross
6,262
7,698
Margin formula used in this report:
M = (R - C) / R x 100
Where R is net revenue and C is
cost of goods sold, both in CNY.
Source: internal finance system, as of 2026-10-31
396 个字符,一个字都没丢。
但你仔细看表格那部分:Item 2025 2026 Revenue 8,745 10,752 Gross 6,262 7,698,九个单元格变成了九行。
问题就在这。人能猜出 8,745 是「Revenue 在 2025 年的值」,但这是靠常识补的,不是文本里带的。如果表格是「Q1 / Q2 / Q3 / Q4」和「A 产品 / B 产品」,你还能猜出哪个数字对应哪个交叉点吗?
再往下是公式:原文是 M = (R - C) / R × 100,分式结构被压成了线性文本。如果这是一个真正的分式(分子 R-C、分母 R),提取后就分不清哪个除哪个。
这就是本文的核心结论:文本层提取给你的是字符流,不是文档结构。行列关系、分栏顺序、公式层级,这三样全在提取里丢了,而它们恰恰是后续所有处理的前提。
顺手说,如果这份 PDF 是扫描件(没有文字层),pypdf 提取出来就是空字符串。这时候连字符流都没有。
四类方案的分界
知道结构为什么会丢,就能理解四类方案各自在补什么。
第一类:文本层提取。 代表是 pypdf、pdftotext、PyMuPDF。直接读 PDF 里的文字对象,速度极快(一页几毫秒),不需要模型,不占显存。边界很清楚:只适合「纯文本、单栏、无表格公式」的文档,比如小说、公告、纯文字合同。遇到表格就废。
第二类:版面分析 + 文本层。 代表是 MinerU、Docling、Marker。先用一个轻量模型检测版面元素(标题、段落、表格、图片、公式的位置),再按区域分别处理,然后拼成 Markdown。这一类的关键能力是「还原结构」。
代价是要下载模型。MinerU 的 pipeline 版大概几百 MB 到 1GB 级,跑起来 CPU 也能用但慢,GPU 快很多。在我这张 6GB 卡上,理论上能跑,但我没实测。
第三类:视觉语言模型直接解析。 代表是小米 OCR-0、GOT-OCR、各种 OCR-VLM。把整页当图片丢给模型,直接输出 Markdown。它的优势是不依赖 PDF 的文字层——扫描件、翻拍件、手写件一样能处理。这也是小米那个模型在 Real5 场景(扫描、弯曲、翻拍、光照、倾斜)上拿第一的原因:它面对的本来就是「图像」而不是「文本」。
代价是模型更大(虽然小米只有 0.8B,但比版面分析模型重),而且输出稳定性依赖模型质量。
第四类:云端 API。 阿里云、腾讯云、百度智能云的文档解析接口。不用部署,按页计费,精度通常不错,但数据要出内网,成本随量线性增长。
三条选型判断线
不用比分数,先问三个问题。
第一条:你的文档有没有文字层?
有文字层、且版式简单(单栏、少表格),第一类就够,别上模型。判据很简单:复制 PDF 里的文字,能粘贴出来就说明有文字层。
没有文字层(扫描件、拍照件),直接跳到第三类。第一类和第二类在这上面都无能为力——版面分析模型能看到布局,但读不出字。
第二条:表格和公式占比多少?
如果超过 10% 的页面含表格或公式,第一类直接排除。第二类和第三类都能处理,区别在于:第二类对印刷规整的文档更稳,第三类对扭曲、翻拍、手写更稳。
第三条:数据能不能出内网?
不能出,排除第四类。这一条经常被忽略,但它是硬约束——很多公司的合规红线就在这。出得去,第四类在「不想维护」的场景下是最省事的。
三条线串起来就是决策路径:
有文字层? ── 否 ──→ 视觉模型(第三类)
   │
   是
   ↓
表格/公式多? ── 否 ──→ 文本层提取(第一类)
   │
   是
   ↓
能出内网? ── 能 ──→ 云端 API(第四类,按量付费)
   │
  不能
   ↓
版面分析(第二类)或 本地视觉模型(第三类)
各工具的实际边界(非实测,标来源)
| 工具 | 类型 | 官方定位 | 已知限制 |
|---|---|---|---|
| pypdf / PyMuPDF | 文本层 | 快速取文字 | 无结构、无扫描件支持;本文实测 |
| Docling | 版面分析 | IBM 出品,输出 Markdown/JSON | 首次运行要下模型;中文古籍弱 |
| MinerU | 版面分析 | 国产,中文文档友好 | 依赖较多;GPU 更顺 |
| Marker | 版面分析 | 转 Markdown 质量高 | 商业使用需看许可条款 |
| Xiaomi-OCR-0 | 视觉模型 | 0.8B 三合一,Apache 2.0 | 官方称 Ollama 路径精度未完全对齐 |
| GOT-OCR2 | 视觉模型 | 通用 OCR | 参数量比小米大 |
| 云厂商 API | 云端 | 免维护、按页计费 | 数据出内网;单价随量放大 |
这张表里的「已知限制」是社区和官方文档里提到最多的点,不是我跑出来的结论。
有一处值得单独说:小米 OCR-0 的官方说明里明确写了,Ollama 路径的对齐检查只覆盖 7 个样例(Apple Silicon + Ollama 0.35.0),跑分不适用于该路径,社区做的 GGUF 量化精度也没有官方评估。所以如果你要用它处理发票合同这类场景,别直接用社区量化包上生产。
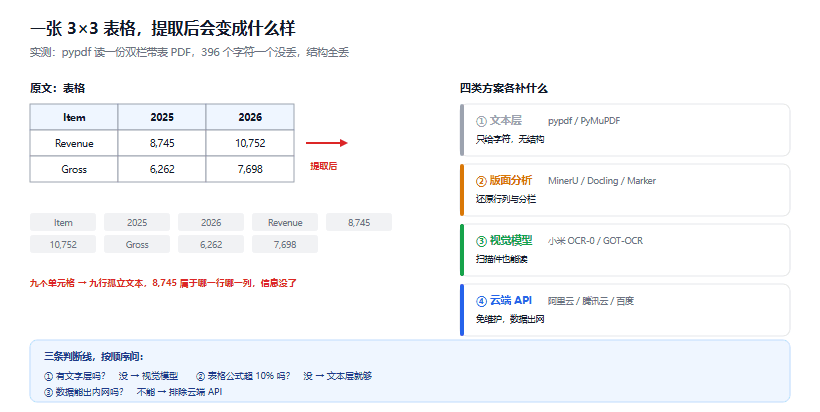
图 1:左边是 pypdf 提取前后,表格行列关系如何变成九行孤立文本;右边是四类方案各补什么
一个反直觉的建议
很多人选工具的顺序是:看榜单 → 挑最高的 → 部署。我觉得应该反过来。
先用你的真实样本来定义验收标准,再选工具。
具体做法:从你的历史文档里抽 20 份,覆盖「最容易出错的形态」——跨页表格、合并单元格、双栏、公式、印章遮挡、手写批注。然后定一个简单的判分标准,比如「表格还原后行列数一致」「关键字段抽取准确率 ≥ 95%」。
有了这个,你跑任何一个工具半小时就能得出答案。没有这个,你看一百篇横评也没用,因为别人的「95 分」和你的样本毫无关系。
这套思路和Agent 评测那篇是一致的:验收标准比工具重要。工具每年都在换代,验收标准才是资产。
五个问题
pypdf 提取出来的文字能用吗?
纯文本场景能用,而且是最优解——几毫秒一页,不占资源。但要做 RAG、要抽取字段、要还原表格,就不够。
MinerU 和 Docling 怎么选?
中文文档多的选 MinerU,它对中文版式和字体处理更好;要标准化输出(Markdown + JSON)给下游系统用的选 Docling。两者都在快速迭代,建议以自己样本上的结果为准。
视觉模型会不会取代版面分析?
短期不会。版面分析在印刷规整文档上更稳、更轻、更快;视觉模型的优势在非规整场景(翻拍、手写、古籍)。实际项目里两者经常搭配用。
云端 API 什么时候值得?
文档量小、偶尔用、不想维护,云端最省事。但一旦量大(月处理十万页以上),成本和数据合规都会成为问题。
小米 OCR-0 能直接替代我现在的 PaddleOCR 吗?
常规文档可以试,它的输出直接是 Markdown/JSON,省掉后处理(上一篇拆过它的数据引擎和消融)。但 PaddleOCR 配套成熟、在线服务方案多,如果你现有流程跑得顺,换的收益不一定覆盖迁移成本。
结语
这篇我做了取舍:宁可只跑一档、把结论说清楚,也不假装跑过四个工具然后给一张「综合评分表」。那种表格看起来专业,实际是把别人的数据重新排列一遍,对选型没有帮助。
真正有用的是那个实验。它让你亲眼看到「那九个单元格为什么不能直接用」——这不是理论,是你把 PDF 丢给脚本后马上会遇到的问题。
如果你的文档现在还是靠人工复制粘贴,第一件该做的事不是买工具,是先统计:多少页有表格、多少是扫描件、多少是双栏。这三个数字出来,方案基本就定了。
参考资料
- pypdf 官方文档 - 文本提取 API 与已知限制
- Docling(IBM)项目主页 - 版面分析方案与输出格式
- MinerU 项目主页 - 中文文档解析的部署与依赖说明
- Xiaomi-OCR-0 模型卡 - 三条部署路径与精度对齐说明
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。