
一句话总结:协议逆向不是「破解加密」,它大部分时候是「看懂参数怎么拼、签名怎么算」。这篇用标准库搭了一个带签名的接口,完整跑了一遍逆推:两条抓包样本、四种候选算法、一次字典攻击命中 secret、随后重放成功。全程在自建服务上做。
站里的逆向文章一直偏二进制:PE 结构、x64dbg、加壳、Ghidra、Frida。这些都在解决「程序内部怎么跑」。
但还有另一半:程序跟服务器说什么。这部分不走汇编,走 HTTP,逆向的方法完全不同。而且它更常见——你想做个第三方客户端、想批量查自己的数据、想搞清某个 App 为什么这么耗流量,遇到的都是这个问题。
边界先说清楚
这篇所有演示都在我自己起的本地服务上做(127.0.0.1:18099),密钥是我自己写的,接口是我自己写的。
对第三方服务做同样的事,合不合法取决于三件事:对方用户协议怎么写的、你访问的是不是自己的数据、有没有绕过技术保护措施。这三条边界你得自己判断,我不替你判断。
技术本身是中性的,下面讲的每一招,用在自建服务上是调试,用在没授权的地方是另一回事。
前置条件
Python 3.9+(标准库:hashlib、uRLlib、http.server)
mitmproxy(手机 App 抓包用,可选)
一个你能完全控制的测试服务(下面会给完整代码)
不需要逆向基础,不需要汇编。这篇的门槛是「会写 for 循环」和「有耐心试」。
第一步:抓包,先看清请求长什么样
抓包工具的选择在另一篇里讲过(三件套的分工),这里只说协议逆向要看什么。
抓到一个请求后,按这个顺序看五样东西:
- URL 路径:
/API/v2/order/list这种,路径本身能看出资源关系 - 查询参数和 body:哪些是业务参数(uid、page、time),哪些是技术参数(sign、timestamp、nonce、Token)
- 请求头:User-Agent、Referer、自定义头(
X-Sign、X-App-Id这类) - 响应结构:
{code, data, msg}还是直接返回数组 - 重复请求的差异:同一个操作连点两次,哪些字段变了
第五点最关键。变化的字段往往就是签名和时间戳,固定不变的才是业务参数。这个方法能帮你在一分钟内把「哪些要复现、哪些随便填」分开。
第二步:判断到底有没有签名
不是所有接口都有签名。三个信号说明有:
信号一:参数看起来是随机串。 长度固定 32 位(md5)或 40 位(sha1)或 64 位(sha256)的十六进制串,基本就是哈希。
信号二:改任意一个参数,它就变。 把 page=2 改成 page=3 重新发,如果签名跟着变,说明签名覆盖了参数。
信号三:漏了它服务端直接拒绝。 删掉那个字段,返回 403 或 {"code":400,"msg":"invalid sign"}。
三个都中,就是标准签名。只有一个中,可能是 token 或者 trace id,不用当签名处理。
第三步:四种常见签名形态
按出现频率排:
形态一:MD5(参数排序拼接 + secret)。 最常见。把所有参数按 key 字典序排序,拼成 k1=v1&k2=v2,末尾接一个固定密钥,取 md5。
形态二:HMAC-SHA256(body, secret)。 更现代的做法,对 body 原文做 HMAC。和形态一的区别在于:它对整个 body 算,不拆参数。
形态三:MD5(参数 + timestamp + secret)。 在形态一基础上加时间戳,服务端校验时间窗口(通常 5 分钟内)。这种签名无法长期复用,必须实时算。
形态四:自研混淆。 参数名加前缀、值做 base64、签名结果再拼接截断。这种没见过源码只能靠试。
大部分国内 App 是形态一和形态三。少数金融类会用形态二加证书绑定。
第四步:完整跑一遍逆推
下面是真实跑通的代码和输出,不是伪代码。
先起一个带签名的服务(服务端签名算法我不告诉客户端,这就是要逆的东西):
import hashlib, urllib.parse, threading, json
from http.server import BaseHTTPRequestHandler, HTTPServer

SECRET = "s3cr3t_demo_key"

def sign(params, secret):
    """参数按 key 排序拼成 k=v&k=v,末尾接 secret,取 md5"""
    s = "&".join(f"{k}={params[k]}" for k in sorted(params))
    return hashlib.md5((s + secret).encode()).hexdigest()

class H(BaseHTTPRequestHandler):
    def do_GET(self):
        q = urllib.parse.urlparse(self.path).query
        params = dict(urllib.parse.parse_qsl(q))
        got = params.pop("sign", "")
        if got != sign(params, SECRET):
            self.send_response(403); self.end_headers()
            self.wfile.write(b'{"ok":false,"msg":"bad sign"}'); return
        self.send_response(200); self.end_headers()
        self.wfile.write(json.dumps({"ok": True, "data": params}).encode())
先验证签名确实在起作用:
# 正确签名
call({"uid": "10086", "page": "2"})
# → (200, '{"ok": true, "data": {"uid": "10086", "page": "2"}}')

# 篡改参数但复用旧签名
call({"uid": "10087", "page": "2"}, s=sign({"uid": "10086", "page": "2"}, SECRET))
# → (403, '{"ok":false,"msg":"bad sign"}')
第二步,假装我们只有抓包记录,不知道算法:
抓包样本:
  参数 {'uid': '10086', 'page': '2'} → sign 39595e2ab05c549d1a3da33cfe22b746
  参数 {'uid': '10086', 'page': '5'} → sign 1691a8295a35a8d8385434b3efd54d32
第三步,试候选算法。先试最朴素的「排序拼接直接 md5」:
def guess_no_secret(p):
    return hashlib.md5("&".join(f"{k}={p[k]}" for k in sorted(p)).encode()).hexdigest()
结果:
md5(排序拼接) → 8834f05c4c14029467aa87f5d09c3728 | 匹配: False不匹配。说明末尾还接了东西。于是试「拼接 + secret」,但我们不知道 secret 是什么。
这时候用字典攻击:拿常见字符串一个个试。
for cand in ["s3cr3t_demo_key", "test", "123456"]:
    if guess_with_secret(p0, cand) == s0:
        print("secret 命中:", cand)
输出:
md5(拼接 + secret) → secret 命中: s3cr3t_demo_key第四步,验证还原出来的算法:
new_params = {"uid": "20001", "page": "9"}
recovered = guess_with_secret(new_params, "s3cr3t_demo_key")
call(new_params, s=recovered)
# → (200, '{"ok": true, "data": {"uid": "20001", "page": "9"}}')
200 了。算法还原成功。
第五步:这个实验说明了什么,以及没说明什么
说明的:签名能不能被还原,主要取决于密钥强度,和算法复杂度关系不大。
上面那个 secret 是我随手起的 14 位字符串,字典里一排就中。真实场景里,如果 secret 是硬编码在客户端里的随机 32 位串,字典打不中,你就得去客户端里找它——那就从协议逆向转成了二进制逆向,得动 FrIDA 或者反编译。
没说明的:这个演示跳过了最难的一步,也就是「拿到 secret」。
真实项目里,逆向的难度分布是这样的:
- 抓包和判断有没有签名:半小时
- 试出参数拼接格式(排序还是原始顺序、要不要 URL 编码、空值参不参与):几小时到几天
- 找到 secret:可能五分钟(源码泄露、硬编码),也可能永远找不到(服务端下发、动态密钥)
第三项是分水岭。secret 在客户端里能捞出来,整个链路就通了;secret 是服务端下发且加了证书绑定,那就基本到头了。
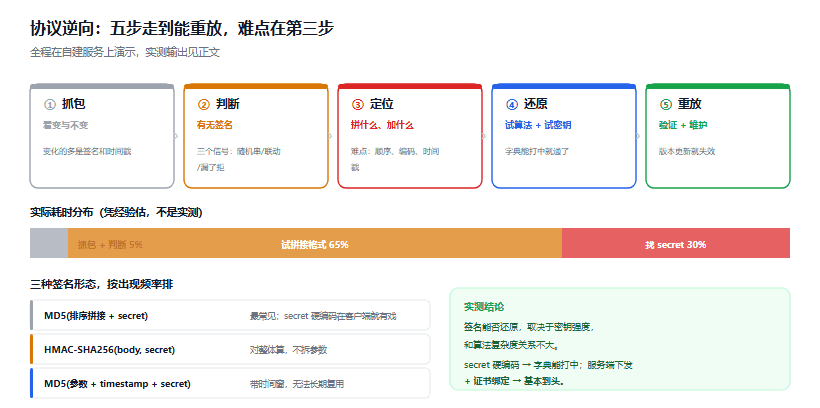
图 1:上半是五步链路,下半是三种签名形态的判断方法
坑清单
按我踩过的顺序排。
1. 参数拼接顺序搞错,怎么试都不对。
有的接口按 key 字典序排,有的按参数出现顺序,有的只对非空参数排序。这三种拼出来的串完全不同,md5 结果自然不同。判断方法:构造两组参数,交换它们的顺序再发请求,如果签名不变说明是按字典序,如果变了说明按原始顺序。
2. URL 编码做了一半。
参数值里有中文、空格、+ 时,要不要先 urlencode 再参与签名?不同服务端实现不一样。有的用原始值,有的用编码后的值,有的编码两次。这是最容易卡住的地方,建议把所有可能组合都试一遍(4 种组合,一次脚本能跑完)。
3. 时间戳精度不一致。
有的接口时间戳是秒(10 位),有的是毫秒(13 位)。你按秒算,服务端按毫秒校验,签名永远不对。看抓包里的 timestamp 字段位数就知道了。
4. 忽略了隐藏参数。
抓包工具默认可能不显示某些头(比如 X-Device-Id),而它参与了签名。排查方法:故意漏掉一个头再请求,看返回的是「签名错」还是「缺参数」——如果报签名错,说明这个头被算进去了。
5. 以为还原一次就一劳永逸。
签名算法会随版本变。你今天逆出来的规则,下个月 App 更新可能就失效了。这是这类工作的固有成本,做之前要算进去。
收尾
协议逆向这件事,技术门槛比二进制逆向低得多,但耐心门槛更高——它大部分时间是「试组合」而不是「看汇编」。
我的经验是:先用两三个样本把「变与不变」摸清楚,再系统性地排列组合试算法,别一上来就猜。
再说一次边界。上面这套流程,用在你自己负责的服务上是接口调试,用在你自己的账号数据上是自动化,用在别人的服务上绕过对方的访问控制就是另一回事了。判断标准不在技术这边。
如果想继续深入,两个方向:一个是往客户端走(secret 藏在 so 里怎么办,接 Frida 那篇),一个是往服务端走(怎么设计一个不容易被还原的签名方案,这属于安全建设的视角)。
参考资料
- 抓包三件套怎么分工 - Wireshark、Fiddler、MITmproxy 各自适合什么场景
- mitmproxy 官方文档 - 脚本化拦截与改写流量的 API
- Frida 动态注入入门 - secret 藏在 native 层时的下一步
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。