
一句话总结:小米开源的 Xiaomi-OCR-0 只有 0.8 亿参数,却在真实拍摄场景的文档解析基准上拿了第一,理解能力还超过 8B 的 MiniCPM-V-4.5。它最有价值的不是分数,而是训练里那个反直觉的发现:从 0.8B 扩到 4B,解析只涨 0.15 分,理解涨 4.9 分。这说明文档解析的天花板在数据质量,不在参数量。
昨天小米官宣开源 Xiaomi-OCR-0,一个 0.8B 的文档理解模型。
中文科技媒体的标题基本是「小尺寸全能王」「越级超越 8B」。这类标题我不太喜欢,因为它把结论说成了「小模型打赢大模型」,容易让人误解成「参数没用」。
真正值得看的不是谁打赢谁,而是这份技术报告里的一条消融实验。它把「什么因素决定这个任务的上限」这个问题回答得很清楚。
先说清楚它是什么
| 项 | 值 |
|---|---|
| 参数 | 0.8B |
| 基座 | Qwen3.5-0.8B-Base |
| 许可证 | Apache 2.0 |
| 能力 | 文档解析、关键信息抽取、OCR 视觉问答三合一 |
| 输出格式 | Markdown、LaTeX、JSON(表格用 OTSL 表示再转 HTML) |
| 开源内容 | 权重、推理代码、浏览器 Demo、MCP 服务、Agent Skill |
| 部署路径 | SGLang / vLLM / Ollama(BF16 GGUF 约 1.8GB) |
时间线有个细节值得注意:权重其实 9 月 30 日就随技术报告放出来了,Hugging Face 仓库 9 月 29 日创建,到官宣时下载量已过 1.5 万。10 月 30 日这场官宣更像是补声量。
三合一这个定位是它和传统 OCR 的分界线。传统 OCR 只做文字转写,表格拆不开行列、公式输出乱码;而通用多模态模型虽然能理解,但几十亿参数塞不进手机。小米切的正是中间这块:够小能上端,够专能把结构还原对。
分数与口径
官方对比表(Real5-OmniDocBench,模拟扫描、纸张弯曲、屏幕翻拍、光照变化、倾斜拍摄五种真实采集):
| 模型 | 参数 | Real5-OmniDocBench | OmniDocBench v1.6 |
|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 95.24 | 96.83 |
| TeleOCR | 1.2B | 未报告 | 96.87 |
| OvisOCR2 | 0.8B | 92.29 | 96.58 |
| PaddleOCR-VL-1.6 | 0.9B | 93.19 | 96.33 |
| MinerU2.5-Pro | 1.2B | 88.94 | 95.75 |
| GLM-OCR | 0.9B | 90.32 | 95.22 |
两个基准的说法要分清:
Real5-OmniDocBench 第一,这个是真第一,在对比表里最高。
OmniDocBench v1.6 是第二,96.83 分,比榜首的 TeleOCR(1.2B)差 0.04 分。1B 以下参数里排第一。
注意这两句话经常被混着说成「登顶」。严格讲是「真实采集场景第一、综合榜第二、小参数档第一」。
其他分项:公式识别 UniMER-Test 97.84、表格结构 PubTabNet TEDS 92.27、古籍书法 Chronicles-OCR 73 分(闭源的 Seed 2.0 Pro 是 72 分,同档)。
理解能力这块是五项视觉问答均分 83.2:
| 模型 | 参数 | 五项 VQA 均分 |
|---|---|---|
| Qwen3.5-4B | 4B | 84.9 |
| Xiaomi-OCR-0 | 0.8B | 83.2 |
| MiniCPM-V-4.5 | 8B | 82.6 |
| Qwen3.5-2B | 2B | 80.9 |
| TextHawk2 | 7B | 78.5 |
| Qwen3.5-0.8B(基座) | 0.8B | 72.9 |
从基座 72.9 提到 83.2,涨了 10.3 分,这是训练配方带来的增益。参数只有 Qwen3.5-4B 的五分之一,均分差 1.7 分。
那个反直觉的消融
到重点了。
技术报告里有两条训练发现,我认为比所有分数都值钱。
第一条:先练解析,再加理解,理解会反过来帮解析。
一般认知是「不同任务会抢容量」,加理解数据会稀释解析能力。报告的数据相反:模型在解析基础上比较扎实之后,再引入 OCR 视觉理解监督,解析指标中期涨 0.639 分、后期涨 0.0749 分。
也就是说,让模型学会「读懂文档在说什么」,反而让它「把文档转写对」的能力也提升了。增益会衰减(0.639 → 0.075),但方向是正的。
第二条:扩参数对解析几乎无用,对理解有用。
从 0.8B 扩到 4B,理解任务涨约 4.9 分(88.1 对 83.2),解析任务只涨 0.15 分(96.9745 对 96.8277)。
这条把两类任务的性质分开了:
- 解析是「手艺」:把像素映射成结构化文本,靠的是数据质量和训练方法,参数够用就行。
- 理解是「认知」:要跨区域关联、要算数、要推理,吃参数。
0.15 分意味着什么?意味着你把参数扩五倍,解析能力提升不到千分之二。这个任务的天花板根本不在模型容量上。
我读到这里的第一反应是:那 1.2B 的 TeleOCR 拿 96.87 也不奇怪,因为它大概率也是靠数据堆上去的。这条赛道的竞争早就不是「谁的模型大」,而是「谁能造出更干净的数据」。
数据怎么造的
既然胜负在数据,那就得看数据引擎。三个部件。
异构专家共识(ETC)。 专家池里放了 8 个 OCR 模型:PaddleOCR-VL-1.6、MinerU2.5-Pro、GLM-OCR、dots.mocr、HunyuanOCR-1.5、TeleOCR、OvisOCR2、Qianfan-OCR。按池内一致度给候选标注排序,只取三名专家达成共识的子集进训练集,拿不准的送去下一环节。
这个思路很实用:单个模型的错误有偏,多个异构模型的交集错误率会低很多。代价是覆盖率——三方一致的样本比例不会高,剩下的得靠别的办法。
渲染回图比对。 表格和公式是 OCR 里最容易错的结构。做法是把候选的解析结果重新渲染成图像,和原始文档的对应区域做像素级和结构级比对,发现行列错位、符号缺失就定向修。
这道校验很聪明。它把「判断解析对不对」这个模糊问题变成了「两张图长得像不像」这个可计算问题,能自动化。
多因子挖掘与定向合成。 按专家一致度、模型自一致性、语义聚类、已验证的失败模式选样;合成数据分两路,一路补覆盖缺口(结构、风格、字形、领域),一路针对训练中反复出现的错误定向生成。
三个部件加起来,构成了它宣称的「高信噪比数据引擎」。
一个必须标出的口径冲突
关于训练样本量,我看到两个数。
技术报告的英文摘要写的是「approximately 70M-sample OCR-centric corpus」,也就是约 7000 万条。中文发布稿和多家转述写的是「累计使用约 1.7 亿条」。
差了 2.4 倍。
我没找到官方解释这个差异。可能是统计口径不同(比如 7000 万条文档 vs 1.7 亿个训练样本),也可能是其中一方笔误。看到这个数字时不要当确定值用,我倾向以技术报告为准,但保留疑问。
这类冲突在模型发布里很常见,凡是「训练用了多少数据」这类自报数字,都建议回到论文原文核对。
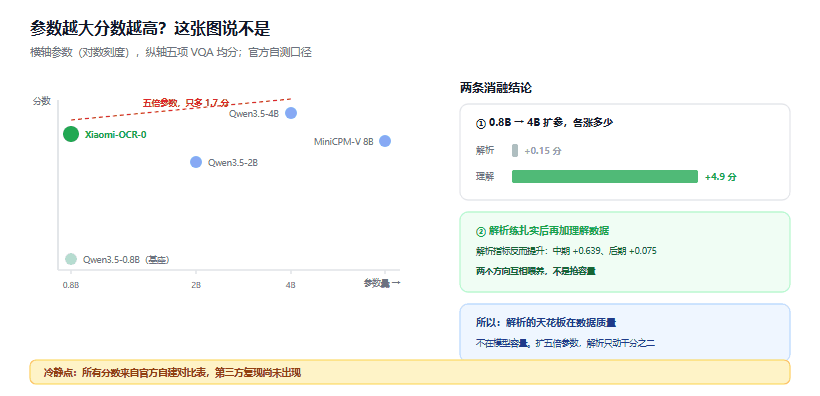
图 1:左边是各模型参数与分数的分布,右边是两条消融——扩参对解析几乎无用,数据质量才是天花板
冷思考:参数效率叙事要打折看
媒体最爱讲「0.8B 超过 8B」,这个说法技术上没错,但读的时候要注意两点。
第一,绝对能力还是弱。 83.2 分对 84.9 分,虽然参数差五倍,但你要是只想要最强,还是选大的。参数效率高不等于能力最强,它是「每单位参数换多少能力」这个指标好。
第二,榜单是官方自建对比表。 所有分数来自小米自己的评测,第三方复现还没看到。对比模型有没有被公平调过 prompt、有没有用最优配置,这些细节公开材料里没有。
我的判断是:这份成绩单在同档模型里可信度较高(因为对比对象都是公开的开源 OCR 模型,跑分方法相对标准),但「越级超过 8B」这个说法只适用于特定的五项 VQA 均分,不能推广成「0.8B 全面等于 8B」。真要在自己的样本上比,压测方法那套分位统计更靠谱。
部署上三个要注意的点
官方的三条路径:SGLang、vLLM、Ollama。
Ollama 那条要特别小心。官方说明里写得很明确:对齐检查只覆盖 Apple Silicon + Ollama 0.35.0 下的 7 个样例,Token 数全部对齐、5/7 原始输出完全一致,剩下两个是公式差异。这个检查覆盖不了整体精度,跑分也不适用于 Ollama 路径。
社区已经有 prithivMLmods、xzl01 做的 GGUF 量化(Q4_K_M、Q8_0 等),但官方明确说这些转换的精度没有评估过。
所以如果你要用它处理发票、合同这类「错一个数字就出事」的场景,建议先用官方的 BF16 跑一遍基准,确认精度之后再考虑量化,本机部署那篇里的量化权衡可以对照着看。1.8GB 的模型,多花这点显存不值得省。
另外「区域模式」需要额外装 PaddlePaddle、PaddleX 和 PP-DocLayoutV3。它适合印刷规整的文档并行提速;场景文字、手写、古籍、不规则版式必须整页解析,切错区域边界会丢上下文。
五个问题
和我之前用的 PaddleOCR 比怎么样?
本任务上分数更高(96.33 对 96.83,差距不大),但 PaddleOCR 配套成熟、部署方案多、中文场景调优久。如果现有流程跑得动,没必要换;要从零搭,这个更省事。
能替代云端 OCR API 吗?
常规文档可以。它输出的 Markdown/LaTeX/JSON 直接能进下游流程,不用再做后处理。但极端场景(严重弯曲、低质翻拍、罕见字体)建议先在自己的样本上验一遍,别直接上生产。
0.8B 真能在手机跑吗?
部分能力已经在小米手机的超级小爱里跑起来了(取餐码、账单记账、发票识别)。但那是端侧专门优化的版本,和你拿开源权重在自己机器上跑不是一回事。
为什么只有 0.8B 还能超过 8B?
因为任务是专用的。通用多模态模型要同时会看图、会推理、会闲聊,容量被摊薄了;这个模型只做一件事,而且训练数据的信噪比做得极高。这不是「小模型更强」,是「专才在专事上强」。
要不要跟进?
如果你在做文档处理、票据识别、知识库构建,值得试。Apache 2.0 无门槛,1.8GB 装得下,跑一遍自己的样本就知道能不能用。投入产出比很高。下一篇我会把它和另外三个文档解析工具放在一起实测,看真跑起来差多少。
结语
这份工作最有意思的地方不是 95.24 分,而是它证明了在特定任务上,数据工程的收益可以远大于参数扩张:解析涨 0.15 分要五倍参数,而把数据做干净能让 0.8B 达到 96.83。
这对做应用的人是个好消息。你不用等更强的模型,把数据整理好就能拿到接近上限的效果。
但对做模型的人是个坏消息:这意味着在垂直赛道上,壁垒不是算力,是数据管道。而数据管道是苦活,谁都能做,就是慢。
顺带说一句,OCR 这条线今年有点热闹。月初还有另一个国产开源模型 OXR 用 1.3B 在 OmniDocBench、olmOCR-Bench、DocPaRSIngBench 三个榜上都拿了第一,主打 13 类文档元素解析,单张 RTX PRO 6000 解析 100 页只要 101 秒。两个模型的方法论不完全一样(OXR 用的是递归自我改进范式),但方向一致:把垂直任务的精度压到能替代云端 API 的水平。
这条赛道接下来拼的应该是长尾场景,比如手写、古籍、多语种混排。谁的数据引擎能覆盖这些,谁就赢下一个身位。
参考资料
- Xiaomi-OCR-0 模型卡(Hugging Face) - 权重、许可与官方评测数据
- Xiaomi-OCR-0 代码与部署说明(GitHub) - SGLang/vLLM/Ollama 三条路径与区域模式依赖
- 小米开源 0.8B 参数 OCR 小模型 - IT之家报道,含训练三阶段与基准对比
- 小尺寸全能王:小米开源 0.8B OCR 模型 - 官方发布稿,含数据引擎与落地场景细节
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。