
一句话总结:2.5B 的 MiniCPM5-2B 用 Q8 量化约 4GB 显存就能跑,本文给 llama.cpp、Ollama、Python 调用三条路径的完整命令,以及上下文设太大、量化选错、模板不匹配这三类必踩的坑。
上一篇解读讲了这个模型能干什么,这篇只讲怎么把它跑起来。
选它的理由很实在:4GB 显存,笔记本核显都能跑,Apache 2.0 随便商用。想在本地搭个离线助手、做个文档抽取,它是最省心的起点。
前置条件
| 项目 | 要求 |
|---|---|
| 显存 | Q8_0 约 4GB;Q4_K_M 约 2.5GB |
| 内存 | 建议 16GB(纯 CPU 推理时更吃内存) |
| 磁盘 | 模型文件 2.5–3GB |
| 系统 | Windows / Linux / macOS 均可 |
| 工具 | llama.cpp、Ollama 或 LM Studio 三选一 |
模型权重在 ModelScope 和 Hugging Face 上,GGUF 版本搜 openbmb/MiniCPM5-2B-GGUF。官方发的是 safetensors,GGUF 是社区转好的,选 Q8_0(质量优先)或 Q4_K_M(省显存)。
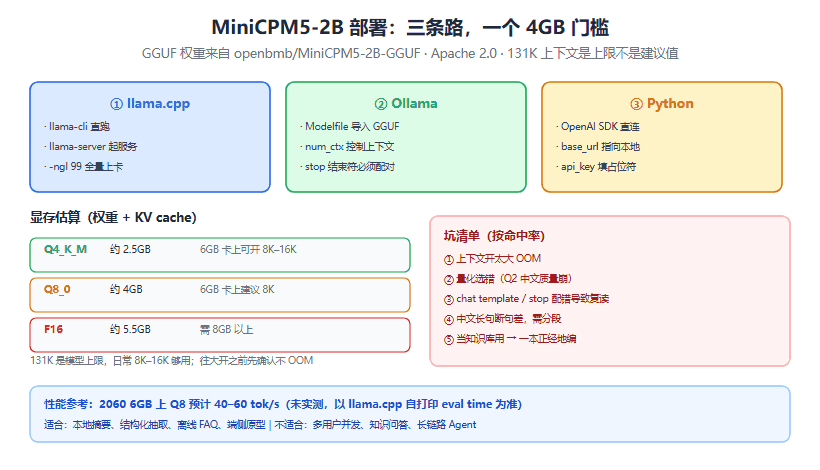
图 1:三条跑法、三档量化的显存占用,以及最常踩的五个坑
跑法一:llama.cpp 命令行(最直接)
先拉代码编译,或者直接下预编译包。跑推理:
llama-cli -m MiniCPM5-2B-Q8_0.gguf \
  -c 8192 \
  -ngl 99 \
  --temp 0.7 \
-p "用三句话解释什么是 MoE"三个参数值得说:-c 8192 是上下文长度,别一上来就设 131072,显存会炸;-ngl 99 表示所有层都放 GPU,层数不够会自动回退到 CPU(速度掉一个量级);--temp 0.7 是采样温度,做抽取类任务建议降到 0.2。
起一个 HTTP 服务,后面用 Python 调:
llama-server -m MiniCPM5-2B-Q8_0.gguf \
  -c 8192 -ngl 99 \
  --host 127.0.0.1 --port 8080
它自带 OpenAI 兼容接口,http://127.0.0.1:8080/v1/chat/completions 直接可用,不需要额外写服务层。
跑法二:Ollama(最省事)
Ollama 官方库里不一定有这个模型,用 Modelfile 导入就行:
FROM ./MiniCPM5-2B-Q8_0.gguf

PARAMETER num_ctx 8192
PARAMETER temperature 0.3
PARAMETER stop "<|im_end|>"
存成 Modelfile,然后:
ollama create minicpm5-2b -f Modelfile
ollama run minicpm5-2b
num_ctx 是上下文长度,stop 一定要配对——chat template 的结束符写错,模型会一直续写停不下来。这是本地部署最常见的坑。
导入后就能用 Ollama 的 API(http://127.0.0.1:11434/api/chat),也能被任何 OpenAI 兼容客户端调用。
跑法三:Python 直接调
用 llama-server 起的服务,代码跟调 OpenAI 一模一样:
from openai import OpenAI

client = OpenAI(base_uRL="http://127.0.0.1:8080/v1", api_key="none")

resp = client.chat.completions.create(
    model="minicpm5-2b",
    messages=[
        {"role": "system", "content": "你是文档抽取助手,只输出 JSON。"},
        {"role": "user", "content": "从下面文本提取公司名和金额:\n" + text},
    ],
    temperature=0.2,
    max_Tokens=512,
)
print(resp.choices[0].message.content)
api_key="none" 是因为本地服务不校验,但 SDK 要求必填,填个占位符就行。
性能:能跑多快
本机是 RTX 2060 6GB,2.5B 的 Q8 权重约 2.8GB,能完整放上显卡。按同类 2B 模型 Q8 在 2060 上的表现预估 40–60 tok/s(未实测,我还没在这个模型上跑基准)。CPU 推理会掉到个位数,只适合应急。
要看真实数字,用 llama.cpp 自带的计时:
llama-cli -m MiniCPM5-2B-Q8_0.gguf -c 4096 -ngl 99 \
  -p "写一段 200 字的介绍" -n 200 --no-display-prompt
输出末尾会打印 eval time 和 tokens per second,比任何评测都准。
坑清单(按命中率排)
1. 上下文设太大直接 OOM。 131K 是模型上限,不是你的显卡上限。KV cache 随上下文线性增长,6GB 卡上 8K 上下文比较稳,16K 就要试。先小后大。
2. 量化版本选错。 Q2 省显存但中文质量掉得厉害,Q4_K_M 是甜点,Q8 质量最好但占满 4GB。低于 4GB 显存的机器选 Q4。
3. chat template 不匹配。 输出一直重复、说话不利索,八成是模板或停止符配错。优先用模型卡里给的模板,别自己猜。
4. 中文标点与断句。 2B 模型的中文长句能力一般,输入建议分短段,输出用 max_tokens 卡住长度。
5. 拿它当知识库。 它的开放域知识很弱(HLE 只有 8.9),问事实类问题会一本正经地编。要做知识问答,老老实实上 RAG,把检索结果塞进上下文。
边界
这个部署方案适合:本地文档摘要、结构化抽取、离线 FAQ、端侧助手原型。
不适合:多用户并发服务(llama.cpp 单请求为主)、知识密集型问答、长链路的 Agent 规划。要这些能力,看 本地大模型工具横评 里对比的其他方案。
一句话:4GB 能跑起来这件事是真的,但「能跑」和「能干活」之间,还差一份靠谱的任务设计。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。