
一句话总结:上一篇把 MCP Server 跑起来了,这篇讲怎么设计它的能力边界——三种原语各归其位,工具标注决定客户端的审批松紧,附一个三原语齐全的完整 Server 代码。
Server 跑通只是入门。我见过不少人卡在下一步:工具越加越多,模型开始选错;静态数据也包成工具,每次对话先白烧一轮工具调用;该用户点的按钮做成了工具,模型压根不理会。这些都是原语用错位置的症状。
这篇就把设计层面讲透。读完你能回答三个问题:一个新能力该做成哪种原语、工具的 annotations 该怎么标、三种原语在一个真实 Server 里怎么分工。
先记住一个判断标准:谁在驱动
遇到「我要加一个能力」,先别急着写代码,问一句:谁在驱动这件事。
- 模型自己判断该用 → 做成 Tools
- 应用主动把数据挂进上下文 → 做成 Resources
- 用户手动触发 → 做成 Prompts
MCP 社区里有句流传挺广的总结:The model? A tool. The application? A resource. The user? A prompt. 三种原语对应三个不同的发起方,协议方法也不一样:tools/call、resources/read、prompts/get。驱动方搞对了,Server 用起来就顺;搞错了,每种错法都有对应的难堪。
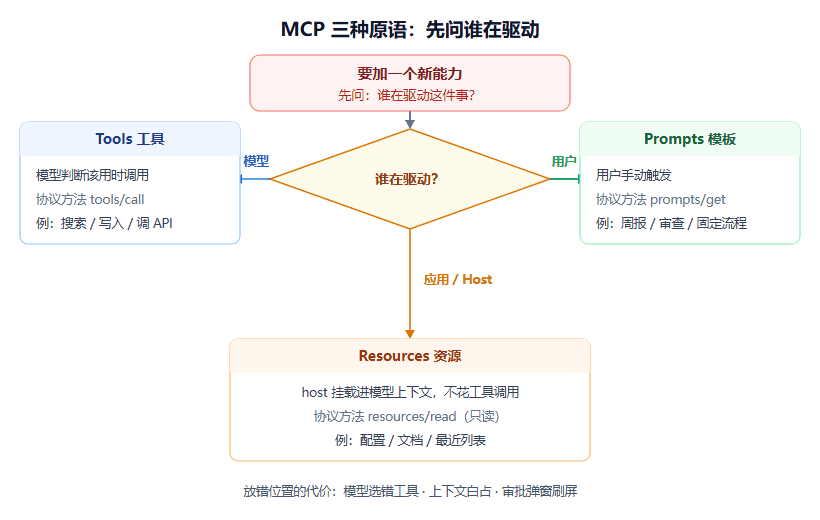
图 1:三种原语的判断流程。拿到一个新需求先问谁在驱动,模型、用户、应用分别对应 Tools、Prompts、Resources。
Tools:模型调用的函数
Tools 是三种原语里唯一「模型决定调不调」的,所以设计自由度最大,坑也最多。
描述是写给模型的产品文档
模型选工具,全靠 name、description 和 input schema 这三样。描述别写「查询数据」这种废话,要写清楚四件事:这个工具干什么、什么时候该用、参数怎么填、返回值长什么样。
举个对比。坏描述:「获取文章信息。」好描述:「按 ID 查一篇文章的详情,返回标题、分类和发布日期。需要先知道 ID,不知道时先用 list_articles 列出所有文章。」后者把调用路径都告诉模型了,模型自己就会串起来用。
我的习惯是把工具名写成动词开头(list_、get_、search_),一眼能看出是读还是写。参数能少则少,能带默认值就带上,能用枚举收窄就别开放——模型对着一枚举选项填参数的准确率,比自由文本高一大截。
annotations:四个暗示,决定客户端怎么审批
2025 年版规范给工具加了 annotations,四个布尔暗示,告诉客户端这个工具的「危险程度」:
| 字段 | 默认值 | 含义 | 客户端典型行为 |
|---|---|---|---|
| readOnlyHint | false | 只读,不修改状态 | 自动放行,不弹确认 |
| destructiveHint | true | 可能造成不可逆破坏 | 执行前要求用户确认 |
| idempotentHint | false | 重复调用无额外效果 | 可安全自动重试 |
| openWoRLdHint | true | 触及 Server 之外的外部系统 | 更严格审批 |
四个默认值全部偏安全,这是刻意设计:你不标,客户端就按最危险的方式对待你的工具。Claude Code 就是典型的分级审批——read-only 工具静默执行,写文件的问一次,碰外部服务的每次调用都问。标得准,用户少受打扰;标得马虎,用户被弹窗烦死,或者反过来,危险操作被静默放行。
两条纪律。第一,annotations 只是暗示不是权限,客户端可以忽略,安全不能全押在它上面,服务端该鉴权还是要鉴权。第二,标错比不标更糟——一个偶尔会写数据的工具标了 readOnlyHint,客户端就会跳过本该做的确认。宁可保守。
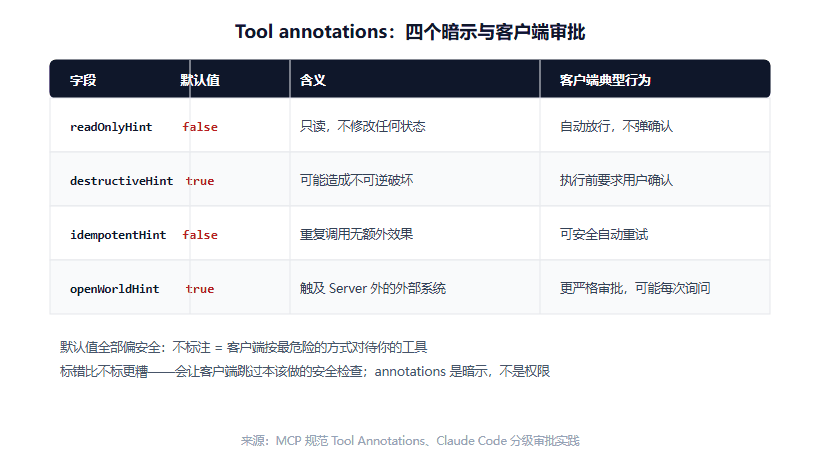
图 2:四个 annotation 字段、默认值与客户端的典型审批行为。默认值全部偏安全,不标注等于按最危险的方式对待。
结构化输出,别什么都塞文本
FastMCP 里返回类型注解就是 output schema:返回 list[dict]、Pydantic 模型,客户端拿到的是校验过的结构化结果,后续代码和模型处理都省事。只有给人看的说明性文字才用纯文本返回。
Resources:应用挂载的上下文
Resources 是只读的、URI 寻址的数据源,长得像网页时代的 GET 请求。配置、文档、最近文章列表这类「变化慢、谁都可能看」的数据,适合做成 resource。
它和工具的关键区别在上下文成本:resource 可以由 host 预加载,直接挂进模型上下文,不花一次工具调用决策;工具每调一次,模型都要先判断「该不该用、参数填什么」。所以静态数据包成工具是浪费——同样查一个配置表,resource 是宿主顺手挂上,工具是模型多绕一轮。
反过来,resources/read 是 GET 语义,绝对不能把会改状态的操作藏在 resource 后面。我见过有人把「删除文章」做成 resource URI,问就是「反正是个 HTTP 请求嘛」——这不是设计,是给未来的事故埋雷。
2026-07-28 规范给 resource 加了两个实用变化:tools/list、resources/list 这类列表响应带 ttlMs 和 cacheScope,客户端可以放心缓存;资源变更的长连接通知改走 subscriptions/listen 订阅。做数据频繁变动的 resource 时,这两点能省掉客户端不少无效轮询。
Prompts:用户触发的模板
Prompts 是服务端预置的提示词模板,由用户手动触发——在 Claude Code 里就是 slash command。适合固定工作流:周报、代码审查、按公司模板写文档。
最常见的误用是把 prompt 当工具使:「模型应该会自己调用这个 prompt 吧?」不会。prompt 的触发方设计上就是用户,模型对「supposed to invoke」的 prompt 基本不买账。该模型调用的,老老实实做成 tool。
设计 prompt 时把可变部分抽成参数,模板本身打磨好。它本质上是把你反复手打的提示词沉淀成产品功能,这个思路值得每家有沉淀的团队试试。
一张对照表,加上三个常见误用
| 原语 | 驱动方 | 协议方法 | 典型场景 |
|---|---|---|---|
| Tools | 模型 | tools/call | 搜索、写入、调外部 API |
| Resources | 应用/Host | resources/read | 配置、文档、只读数据 |
| Prompts | 用户 | prompts/get | 周报、审查、固定工作流 |
误用清单,按我见到的频率排:
- 用 resource 藏写操作。GET 语义干 mutate 的活,客户端缓存和预加载都会跟着遭殃。
- 用 tool 包静态数据。每次调用白烧一轮工具决策,context 也越滚越大。
- 用 prompt 冒充 tool。等着模型自己触发,等到天荒地老。
一个三原语齐全的 Server
还是用博客后台的例子,这次把三种原语都摆上:
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("blog-mcp")

# 1. Tool:模型驱动的搜索,标好 annotations
@mcp.tool(annotations={"readOnlyHint": True, "openWorldHint": False})
def search_articles(keyword: str, liMIT: int = 10) -> list[dict]:
    """按关键词搜索文章。keyword 传标题或分类里的词;不知道有什么词时可先留空调 list_articles。"""
    rows = [a for a in ARTICLES if keyword in a["title"] or keyword in a["category"]]
    return rows[:limit]

# 2. Resource:应用挂载的只读数据,URI 寻址
@mcp.resource("articles://recent")
def recent_articles() -> str:
    """最近发布的文章列表(JSON 文本)。"""
    import json
    return json.dumps(ARTICLES[-10:], ensure_ascii=False)

# 3. Prompt:用户触发的模板,可变部分是参数
@mcp.prompt()
def weekly_report(week: str) -> str:
    """生成内容运营周报的提示词模板。week 传周次,例如 2026-W42。"""
    return f"请根据 articles://recent 里的文章数据,写 {week} 的内容运营周报,包含发布数量、分类分布和下周选题建议。"
annotations 参数在较新版本的 FastMCP 里可以直接传给装饰器;如果你的版本不认这个参数,改用 add_tool 注册,或者翻一下你装的那版 SDK 文档——这块各版本封装不完全一致,我没逐个版本核对过。
跑起来后用 Inspector 验证:Tools 面板能看到 search_articles 且带着只读标记,Resources 面板能列出 articles://recent 并读到 JSON,Prompts 面板填个 week=2026-W42 能预览生成的模板。三块都亮,分工就到位了。
FAQ
Q1:同一个能力,能同时做成 tool 和 resource 吗?
能,但要克制。典型合法场景是「读」:搜索做成 tool 给模型用,完整列表做成 resource 给 host 预加载。写操作只留 tool 一条路,别开分身。
Q2:Resources 支持写入吗?
不支持。resources/read 是只读的,写入一律走 tool。别跟协议对着干。
Q3:Prompt 返回的 messages 是什么结构?
role 加 content 的消息列表,和对话消息同构。上面例子里返回字符串,FastMCP 会包成一条 user 消息;要拼多轮对话就显式返回消息列表。各客户端对 prompt 的渲染细节有差异,这点我没全部实测,以你用的客户端为准。
Q4:annotations 不标会怎样?
客户端按默认值当成最危险的工具:可能不可逆、不可重试、触及外部世界。表现就是确认弹窗变多。标全、标准,用户体验直接上一个档。
Q5:工具太多,模型选不准怎么办?
三个办法。控制数量,个人 Server 十个以内;描述去重,两个工具描述雷同,模型必错一次;把静态数据拆去 resource,别让工具列表里混一堆「查询固定数据」的玩意儿。Claude Code 后来做的 Tool Search 也是治这个病——工具多到一定规模,让客户端按需检索工具列表,而不是全量塞上下文。
结语
三种原语的分工,说到底是对「控制权」的尊重:模型的判断归 tools,宿主的上下文归 resources,用户的意图归 prompts。写 Server 时每加一个能力,先问谁在驱动,这一句话能避开大部分设计事故。
下一篇回到数据层,讲 RAG 实战:几百行代码搭一个自己的知识库问答,resource 和 tool 会在里面再次出场。
- 描述是写给模型的产品文档
- annotations:四个暗示,决定客户端怎么审批
- 结构化输出,别什么都塞文本
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。