
一句话总结:Agent Skill 就是装在文件夹里的一套工作手册,核心设计是三层加载:平时只占 100 token 的元数据,任务对上了才读正文,附件到了真需要才打开。我扫了本机 82 个 Skill,中位数正文 8,550 字节,如果全塞进上下文约 24 万 token,几乎没有模型装得下;靠分层加载,实际只用 1.3 万。
一、Agent 缺的不是能力,是知识
现在的大模型不缺通用能力。你让它写代码、读文档、做分析,它都会。它缺的是"在你这儿该怎么干"。
比如你们公司写周报有固定格式,第五段必须写风险,风险要按影响面排序。这件事模型不知道,每次都要重讲一遍。再比如你们用的那个内部系统,接口有个奇怪的限制,必须先查缓存再提交,不然会重复入库。这种坑不写下来,每次都在踩。
过去的解法是写进 prompt。问题是 prompt 是会话级的,换个对话窗口就没了,团队里每个人都得抄一遍。
Skill 解决的就是这件事:把"怎么干"写成文件,放在固定位置,Agent 自己判断什么时候该用。
官方有个说法我觉得很准:给 Agent 建 Skill,就像给新员工写一份入职指南。
二、一个 Skill 就是一个目录
结构很简单,只有一个文件是必需的。
my-skill/
├── SKILL.md          # 必需:元数据 + 正文指令
├── scripts/          # 可选:可执行脚本
├── references/       # 可选:参考资料
└── assets/           # 可选:模板、素材
SKILL.md 开头必须是 YAML frontmatter,最少两个字段:
---
name: weekly-report
description: 按公司模板生成周报。当用户要求写周报、总结本周工作、或提到周报格式时使用。
---

# 周报生成

## 格式要求
...
name 是标识,description 才是关键。Agent 靠这句话决定要不要用你,所以它必须同时说清两件事:这个 Skill 做什么,以及什么时候用它。
这句话写不好,后面全白搭。
三、三层加载,这是整个设计的关键
Skill 最有价值的地方不是"能装知识",是"知道什么时候不装"。
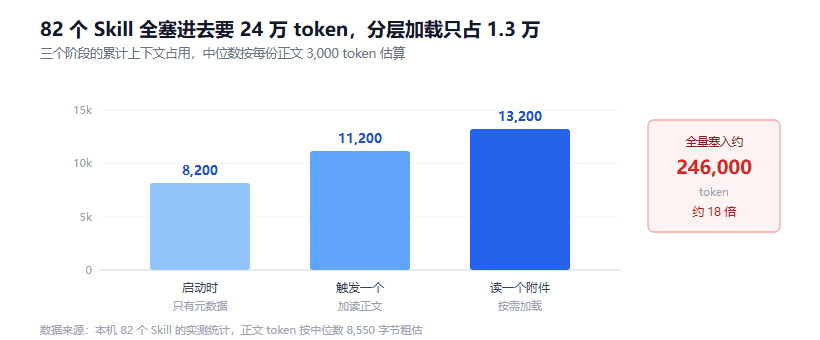
图 1:三个阶段分别加载什么。前两层是线性增长,第三层基本免费
第一层,元数据。 Agent 启动时,把所有已安装 Skill 的 name 和 description 读进系统提示。每个约 100 token。
第二层,正文。 当任务匹配上某个 Skill 的 description,Agent 才去读完整的 SKILL.md。官方建议控制在 5,000 token 以内。
第三层,附件。 脚本、参考资料、模板都在这一步。关键在于:脚本是执行,不是读取。 Agent 用 bash 跑一段代码,只有输出进上下文,代码本身不占地方。
这三层的成本差得很远。官方给的数字是每层约 100 token、5,000 token 以下、按需几乎为零。
四、我扫了本机的 82 个 Skill
空谈不如看数据。我把自己机器上 82 个 Skill 统计了一遍。
| 指标 | 数值 |
|---|---|
| 数量 | 82 个 |
| SKILL.md 最小 | 867 字节 |
| SKILL.md 中位数 | 8,550 字节 |
| SKILL.md 最大 | 73,062 字节 |
| 没有任何附件目录的 | 41 个,占一半 |
中位数 8,550 字节,中文大约 3,000 到 4,000 token,比官方建议的 5,000 上限略高但在合理范围。
另有一件事更值得看:一半的 Skill 目录里除了 SKILL.md 什么都没有。
这说明大多数人只用了前两层,把 Skill 当成"一段写得比较长的 prompt"来用。第三层——脚本和参考文件——基本没动。
而第三层恰恰是 Skill 区别于普通 prompt 的核心。一段需要确定性的操作,比如按固定规则校验格式、按固定模板拼接文件,交给脚本执行,结果稳定、不占上下文;写在正文里让模型照着做,每次结果都可能有细微差别。
五、和 MCP 的分工
这两件事经常被混为一谈,其实管的层面完全不同。
| MCP | Skill | |
|---|---|---|
| 给的是什么 | 能力接口 | 流程知识 |
| 形态 | 服务端,暴露工具 | 本地目录,文件 |
| 调用方 | 模型决定调哪个工具 | 模型读了照着做 |
| 上下文成本 | 每个工具的描述都常驻 | 100 token 的元数据常驻 |
| 适合 | 连数据库、调 API、读外部系统 | 怎么用这些能力、按什么规矩做 |
用一句话概括我的理解:MCP 解决"能不能做",Skill 解决"该怎么做"。
举个具体的。你要 Agent 查公司数据库,这是 MCP 的活:暴露一个查询工具,模型调用它拿到数据。
但"查之前先确认这个表有没有脱敏字段、金额单位是分还是元、导出超过一万行要分批"这三条规矩,是 Skill 的活:写在 SKILL.md 里,模型查之前会读。
两个东西一起用才完整。只有 MCP,Agent 有手但没有经验;只有 Skill,Agent 有经验但没有手。
站里之前写过从零写一个 MCP 服务器,那是"给一只手";这篇讲的是"给一套经验"。
六、和另外两个概念的边界
和 prompt 的区别。 prompt 是一次性的、会话级的。Skill 是持久的、可版本控制的、跨会话的。你把同一段指导写第三遍的时候,就该考虑做成 Skill 了。
和 subagent 的区别。 subagent 是另开一个上下文去干活,干完把结果交回来。Skill 不隔离上下文,它是给自己加知识。两个不冲突:一个 subagent 可以带若干个 Skill。
和 slash command 的区别。 command 是人主动触发的,输入 /xxx 才执行。Skill 是模型自己判断的,你说"帮我写周报",它自己去匹配。
七、为什么这个设计值得认真对待
回到那个 24 万 token 的数字。
如果把 82 个 Skill 的正文全部塞进上下文,按中位数算大约 24 万 token。这个量级超过绝大多数模型的窗口,勉强塞进去也会让每次对话都变得又慢又贵。
分层加载之后,实际占用是:82 个元数据约 8,200 token,触发一个 Skill 加 3,000,读一个参考文件再加 2,000。总共一万三。
同一个知识库,24 万和 1.3 万,差 18 倍。 这就是为什么这个设计重要。
官方说得很直白:因为不需要把整个 Skill 读进上下文,所以一个 Skill 能打包的上下文量实际上是无界的。你可以往里放几百页的参考文档,只要它们在被引用时才读取。
FAQ
Skill 一定要有脚本吗?
不用。只有 SKILL.md 也能用,我扫的 82 个里有一半就是纯文本。但只有正文的 Skill,本质是一段长 prompt,没用到这个格式的核心优势。
装了太多 Skill 会拖慢吗?
会占一点上下文。每个约 100 token,装 100 个就是一万,不算多但也不是零。装到用不上的 Skill 就删掉。
Skill 和知识库检索(RAG)什么关系?
RAG 是按相似度捞片段,捞到什么不一定。Skill 是按任务匹配整份手册,内容是你写死的、确定的。前者解决"事实在哪",后者解决"流程怎么走"。
description 写多长合适?
一到三句话。核心是两件事:做什么、什么时候用。我见过写成一整段的,模型照样能匹配,但那 100 token 就白花了。
Skill 能调用别的 Skill 吗?
可以互相引用,但别做成链条。三层嵌套之后模型很容易绕晕,出问题也难查。
结语
Skill 这个东西的价值不在"又一种 prompt 写法",在于它把上下文管理做成了一门结构化的手艺。
真正难的从来不是模型不够聪明,是你没法把所有背景一次说完。分层加载解决的就是这个。
给个可以马上动手的判断:翻一遍你的对话记录,找那件你重复解释过三次以上的事。那件事就是你的第一个 Skill。
参考资料
- Agent Skills 开放标准 - 格式规范与三层加载机制
- Anthropic 官方文档 - Agent Skills 概览
- Anthropic 工程博客 - Equipping agents for the real world with Agent Skills
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。