
一句话总结:内容站过去只有一条分发路径,被人搜到、点进来、看页面。现在多了两条:被 AI 摘要引用,和不产生任何流量的 API 调用。MCP 让第三条路有了新玩法,你不再只是被读取的文本,可以是一个被调用的工具。但不是所有内容都适合做成工具,判断标准就两条:结构化程度和查询频率。
一、分发这条路已经裂成三条
先把变化说清楚。
以前内容站只有一种活法:搜索引擎收录,用户搜关键词,点进来,看页面,看广告或者注册。价值传递是单向的,路径是清晰的。
现在变成三条并行:
第一条,还是搜索点击。 这条路在变窄,但没断。
第二条,AI 摘要引用。 用户不进来,答案里有你的名字。有曝光,没流量。
第三条,API 调用。 你的内容被某个产品抓走、切片、召回,拼进答案里。没有名字,没有链接,你甚至不知道被用了。这条我在搜索 API 降价那篇里算过账。
MCP 出现之后,第三条路多了一种可能:你不只是被读取,你可以被调用。
二、被读取和被调用,差别在哪
这两件事听着像,实际完全不同。
被读取,你是一堆文本。对方拿走什么、用多少、怎么拼接,你都不知道,也没有接口能控制。
被调用,你是一个有名字、有参数、有返回值的工具。AI 助手在需要某个数据时,会明确地把请求发给你,你返回结构化的结果。这个过程中,你的名字出现在调用记录里。
这个差别意味着什么?意味着在第三条路上,你第一次有了"身份"。
举个具体的。用户问助手"现在哪款国产 GPU 的单卡显存最大",如果只是抓取,助手会去读一堆文章然后拼答案。如果有一个 GPU 规格查询的 MCP 工具,助手会直接调它,拿到结构化结果,可能还会说一句数据来自哪里。
前一种情况你是素材,后一种情况你是信源。
三、判断标准只有两条
不是所有内容都适合做工具。我拿两条轴来判断。
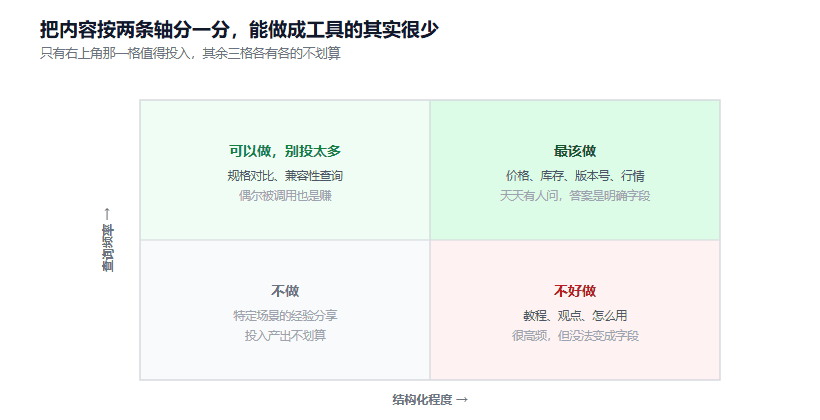
图 1:结构化程度和查询频率,决定了这件事值不值得做
横轴是结构化程度。 你的内容能不能被拆成"参数 → 值"这种形式。产品参数、价格表、规格对比、配置项,结构化程度高。教程、观点、经验分享,结构化程度低。
纵轴是查询频率。 用户会不会反复问同一类问题。价格、库存、版本号、兼容性,这类问题高频。某个特定场景的解决方案,低频。
四个象限的结论:
高结构 + 高频:最该做。 这是唯一的黄金区。用户天天问,答案又是明确的字段,这种内容做成工具收益最直接。
高结构 + 低频:可以做,但别投入太多。 做一个简单的查询接口放着,成本低,偶尔被调用也是赚。
低结构 + 高频:不好做。 "Python 怎么读文件"这种问题很高频,但你没法把它做成一个返回字段的工具。这类内容只能靠被引用,赚曝光。
低结构 + 低频:不做。 投入产出不划算。
四、一个最小例子
如果你的内容落进了黄金区,实现起来不难。
比如你有一批硬件的规格数据。做成 MCP 工具就是定义几个动作:按型号查规格、按条件筛型号、对比两个型号。
# 工具定义(伪代码,各家 SDK 大同小异)
{
  "name": "query_gpu_spec",
  "description": "按型号查询 GPU 的显存、功耗、算力参数",
  "input_schema": {
    "type": "object",
    "properties": {
      "model": {"type": "string", "description": "型号,如 H200、天垓300"}
    },
    "required": ["model"]
  }
}
关键不在代码,在两个地方。
一是 description 写得准不准。 AI 靠这段文字判断什么时候该调你。写"查询 GPU 信息"和写"按型号查询 GPU 的显存、功耗、FP8 算力,数据更新至 2026 年 11 月",被调用的概率差很多。
二是返回值的结构。 返回一段自然语言,助手还得再理解一遍;返回结构化字段,它直接能用。工具的价值就在于省掉那一步。
站里之前写过从零写一个 MCP 服务器,代码层面照那个做就行。
五、三个现实问题
一,做了可能没人调。 这是最大的风险。AI 助手会不会在合适的时候想到你,取决于它的工具选择逻辑,你控制不了。这和 App Store 里用户主动搜索完全不同。
我的判断是:现阶段做 MCP 的收益,远小于"做好被引用的内容"。前者是押注未来,后者是保住现在。
二,维护成本是持续的。 内容会更新,工具得跟着改。数据错了返回错的结果,比不返回更糟。一个静态页面写错了,读者能看出来;一个工具返回错了,助手会当真话用。
三,被替代的风险变高了。 如果你的工具只是把公开数据包装一下,别人做一个更好的就能替掉你。真正难替代的是独家数据,这一点和做内容是一样的。
六、除了 MCP,还有更简单的做法
说个可能更实际的:如果你只是想让内容被 AI 更好地读,不必做 MCP。
把结构化数据用 schema 标出来。 产品参数用表格、加 FAQ 结构化标记、给出更新时间。这些是 AI 抓取时最容易利用的形式,成本几乎为零。
把关键结论写在能被摘取的位置。 每段开头一句总结,比藏在第三段中间强。
给数据标来源和日期。 可核对的内容更容易被引用,因为它降低了引用方的风险。
这三件事的效果比做一个没人调的 MCP 服务更确定。站里 GEO 那篇讲的就是这套。
MCP 应该是这三件事做完之后的加分项,而不是替代品。
FAQ
个人小站做 MCP 有意义吗?
意义有限。MCP 的价值在于被高频调用,个人站的内容量和查询频率通常撑不起来。把精力放在被引用上更划算。
做 MCP 需要什么技术条件?
一个能跑 HTTP 服务的环境就够了。协议本身不复杂,难的是数据和描述的质量。
怎么知道有没有人调我的工具?
在服务端记日志。调用来源、参数、频率都能看到,这也是它比"被读取"强的地方:你至少知道发生了什么。
会不会被平台封杀?
目前 Google 在推 Connected Apps 这条路,明确欢迎第三方接入,短期不会。但规则随时可能变,别把全部身家押上去。
内容站的流量还有救吗?
分情况。有独家数据、有明确查询场景的,还有位置。纯信息搬运的,基本没戏。这个判断我在系列还是单篇那篇里也提过。
结语
MCP 是个好方向,但它不是内容站的救命稻草。
真正决定你在这三条路上能不能活的,还是那件老事:你有没有别人没有的东西。有的话,做不做 MCP 都能被找到;没有的话,做成什么形态都没人调。
给个具体动作:花半小时,把你站上的内容按"结构化程度"和"查询频率"分一遍。分完了你大概会看到,黄金区里的内容可能只有几篇。那就从这几篇开始,先把它们做成最容易被抓取的形式,再考虑要不要做成工具。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。