
一句话总结:同一个任务、同一批工具,MCP 接法 20 轮要用 6 万上下文 token,CLI 接法 8 千 4,Skills 接法 4 千 1。差距来自协议设计,不是实现水平。
OpenRouter 前几天实测了同一 GitHub 任务下 MCP、CLI、Skills 三种接入方式的上下文消耗,结论是 CLI 最省。我看到这条时正在给自己的工具链接第三个 MCP server,于是把这笔账自己算了一遍。
结论比他们的更极端一点。因为 MCP 的成本跟轮数成正比,任务越长,差距越大。
三种接入方式的上下文成本怎么算
差异的根源在工具描述放在哪里、什么时候发。
MCP 把工具 schema 写进系统提示。一次会话里接了 3 个 server、共 20 个工具,每个 schema 平均 150 token,就是 3000 token 的固定开销。这 3000 token 每一轮都要重新发一遍,因为模型每次生成都要看到可用工具列表。
CLI 只给一行命令摘要。模型要知道细节时执行 --help,输出进上下文,用完这一轮就过去了。摘要 12 token 一条,20 个工具 240 token,加上平均 3 次 help 查询。
Skills 是渐进披露:系统提示里只有技能名(8 token 一条),命中某个技能时才读它的文档(约 900 token),读完这一次就不再重复。
三者的差别可以写成公式:
MCP     每轮 = 工具数 × schema 大小
CLI     每轮 = 工具数 × 摘要大小 + help 查询
Skills  每轮 = 工具数 × 名字大小 + 技能文档(只读一次)
只有 MCP 那一行里没有"只读一次"这个选项。
实测:20 轮任务,MCP 6 万 token
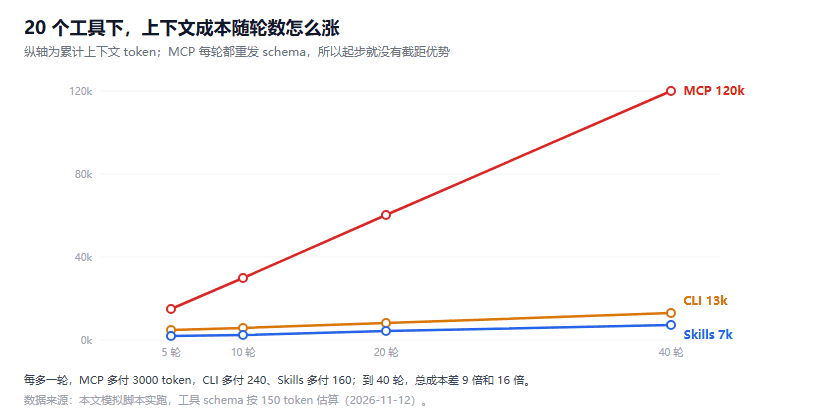
图 1:20 个工具下,MCP 每轮多付 3000 token,CLI 多付 240,Skills 多付 160
| 工具数 | MCP | CLI | Skills |
|---|---|---|---|
| 5 | 15,000 | 2,100 | 1,700 |
| 10 | 30,000 | 4,200 | 2,500 |
| 20 | 60,000 | 8,400 | 4,100 |
| 40 | 120,000 | 16,800 | 7,300 |
| 80 | 240,000 | 33,600 | 13,700 |
20 轮、20 个工具的情况下,MCP 6 万 token,CLI 8 千 4,Skills 4 千 1。MCP 是 CLI 的 7.1 倍。
按轮数看更明显:
轮数       MCP      CLI   Skills   倍数
   5     15000     4800     1700    3.1x
  10     30000     6000     2500    5.0x
  20     60000     8400     4100    7.1x
  40    120000    13200     7300    9.1x
倍数随轮数线性增长,因为 MCP 的成本是"轮数 × 固定开销",CLI 和 Skills 的成本里有很大一块是"一次性"。
这意味着:短任务用 MCP 差别不大,长任务用 MCP 会吃掉整个上下文预算。
按 20 万上下文算,6 万 token 的工具描述占掉 30%。如果再叠上代码库上下文和对话历史,很容易撞到上限,然后触发截断或者压缩——两种都会掉效果。
怎么自己算一遍这个账
下面这段是我用的,把自己的工具清单填进去就能出结果:
TOOLS = 20      # 一次会话里接了多少个工具
SCHEMA = 150    # 每个工具的完整 schema(名字+描述+参数 JSON)约多少 token
SUMMARY = 12    # 同样的工具,压成一行摘要要多少 token

def cost_mcp(turns):
    """MCP:工具 schema 写进系统提示,每轮重发"""
    return turns * TOOLS * SCHEMA

def cost_cli(turns):
    """CLI:只给命令摘要,细节靠 --help 按需查"""
    return turns * TOOLS * SUMMARY + TOOLS * 3 * 60

def cost_skill(turns):
    """Skills:只给名字,命中时读一次文档"""
    return turns * TOOLS * 8 + 1 * 900

print(f"{'轮数':>5}{'MCP':>10}{'CLI':>10}{'Skills':>10}{'倍数':>8}")
for t in (5, 10, 20, 40):
    m, c, s = cost_mcp(t), cost_cli(t), cost_skill(t)
    print(f"{t:>5}{m:>10}{c:>10}{s:>10}{m/c:>7.1f}x")
输出:
   轮数       MCP       CLI    Skills      倍数
    5     15000      4800      1700    3.1x
   10     30000      6000      2500    5.0x
   20     60000      8400      4100    7.1x
   40    120000     13200      7300    9.1x
三处可以改,改了结论会变:
SCHEMA 这个值。 我是按 150 估的。把你自己接入的工具的 schema 拉出来数一遍——json.dumps(tool_schema) 的字符数除以 4,中文再单独加。参数带嵌套对象的接口很容易到 400。
TOOLS 这个值。 它同时影响三种方式,但影响比例不同:MCP 是线性乘,Skills 因为有一块固定成本,工具越多差距越明显。工具数从 20 加到 80,MCP 和 CLI 的倍数从 7.1 涨到 7.1(线性放大),但 Skills 的绝对值涨得慢。
turns 的分布。 平均值骗人。如果 80% 的任务 3 轮就结束、20% 的任务跑 40 轮,加权之后的真实差距比"平均 10 轮"算出来的小得多。先统计自己 agent 的轮数分布,再决定值不值得改。
为什么 MCP 这么贵:schema 每轮都重发
这不怪实现,是协议决定的。
MCP 的设计目标之一是让客户端能自动发现工具:连上 server,客户端拿到 tools/list,把结果交给模型。模型看到的是完整 schema——工具名、描述、参数 JSON Schema、必填项、枚举值。
这份东西必须每轮都在上下文里,因为模型每次生成都要参考它决定调哪个工具。而大多数推理框架是无状态的,每轮重新组 prompt,所以 schema 每轮重发一次。
有几种优化手段,各有代价:
| 手段 | 省多少 | 代价 |
|---|---|---|
| 精简 description | 30–50% | 模型选错工具的概率上升 |
| 只暴露相关的 server | 按比例 | 需要预先判断哪些相关 |
| 用 Tool Search 按需加载 | 60–80% | 多一次检索调用,多一跳延迟 |
| 换成 CLI / Skills | 80%+ | 要改工具实现方式 |
第四种最彻底,但改造量最大。前三种是在 MCP 框架内的妥协。
缩窄工具集:最直接的上下文成本优化
20 轮任务,把工具从 20 个砍到 5 个:
| 配置 | MCP | CLI | Skills |
|---|---|---|---|
| 20 轮 × 20 工具 | 60,000 | 8,400 | 4,100 |
| 20 轮 × 5 工具 | 15,000 | 2,100 | 1,700 |
| 降幅 | -75% | -75% | -59% |
MCP 从 6 万降到 1 万 5,省 75%。这一步不需要改协议、不需要换框架,只需要在接 server 的时候不要"全接上"。
具体做法是按任务类型分组:做代码任务时只挂代码相关的 server,做文档任务时只挂文档相关的。代价是切换任务要重连,但比每轮多花 4 万 5 token 划算。
还有个反直觉的点:工具少,模型表现也会好。 20 个工具里如果有 5 个功能重叠,模型选错的概率会明显上升。省 token 和省错误是同一件事。
什么时候该用 MCP
MCP 不是没价值,它的价值在别处。
多客户端复用。 一个 server 写完,Claude、Cursor、自己的 agent 都能连。CLI 要给每个环境各写一套包装。
权限和审计。 MCP 有明确的调用边界,谁调了什么、参数是什么,都能记录。CLI 是执行外部进程,权限粒度粗。
结构化返回。 MCP 返回 JSON,字段有 schema 约束;CLI 返回文本,要解析。要解析就要处理解析失败,这层损耗我算过,几个点的准确率就没了。
所以选型的分界线是:短会话、多客户端、要审计 → MCP;长会话、单客户端、追求成本 → CLI 或 Skills。
我自己现在的做法是混着用:需要跨客户端复用的工具走 MCP,一次性的脚本走 CLI,复杂的流程知识写成 Skill。这样既保留复用,又不让上下文被 schema 吃掉。
这组数字的三个前提
说清楚免得误导。
第一,schema 大小是估的。 150 token 是中等复杂度工具的平均值。参数多的工具(比如带嵌套对象的配置接口)能到 400 token,简单的一行命令 40 token 就够。真实值要把自己的工具清单拉出来数一遍。
第二,没算模型实际使用工具的开销。 上面只是"描述工具"的成本,不含调用工具时传的参数和返回结果。真实任务里这部分往往比描述还大。
第三,轮数是关键变量。 我这个模拟跑 5 到 40 轮。如果你的 agent 平均只跑 3 轮,MCP 的额外开销可以忽略,不值得为它改造工具链。
顺带说,这类"固定开销 vs 有效工作"的拆分思路和内核融合那笔账是一个路子:先算清楚固定开销占多少,再决定优化值不值得做。那次算出来发射开销占 75%,所以融合有效;这次算出来工具描述占 30%,所以值得改,但没到必须改。
参考资料
- OpenRouter 实测 MCP / CLI / Skills 的上下文成本:OpenRouter 官方博客,2026-11
- Model Context Protocol 规范:tools:MCP 官方文档
- Anthropic:Code execution with MCP:Anthropic 工程博客
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。