
一句话总结:Factory 的 Droid 1.0 把「生成一段脚本批量调工具」设成默认模式,取代一次一轮的 ReAct 循环。两者差的不是往返次数,是上下文累积:ReAct 每轮把历史全带上,跑到第 20 步单轮就要喂 4,220 token,而脚本模式始终是 800。按固定参数测算,同一任务的 20 步,总消耗差 27 倍。
一、先讲清楚贵在哪
用 Agent 跑长任务,账单会莫名其妙变高。很多人以为是模型调用次数多,其实主要成本在另一处。
ReAct 的工作方式是:想一步、调一次工具、看结果、再想下一步。每一轮调用模型时,前面所有的思考记录和工具返回都要重新塞进上下文,因为它需要这些信息才能决定下一步。
关键在于,上下文是累积的。第 1 轮只带系统提示,第 2 轮带上第 1 轮的思考,第 3 轮带上前两轮的所有内容……跑到第 20 步,光是把历史塞进去就要几千 token,而这 20 次调用每次都在重复付出这个成本。
这就是为什么 20 步的任务,账单可能是一步任务的十几倍,而不是 20 倍。
二、Droid 1.0 换了个做法
Factory 11 月发布的 Droid 1.0,把沙箱脚本模式设成默认的执行方式。
具体做法是:模型不再一步一步来,而是生成一段轻量的 JavaScript 脚本,脚本在本地安全沙箱里执行,一次把几百个操作跑完。这取代了标准的对话式 ReAct 循环。
这个思路我在几个项目里都见过雏形,但把它做成默认,是个明确的取舍信号:在流程已知的批量任务上,一次规划比逐步试探便宜太多。
三、机制差异到底在哪
把两种模式并排放,差别就一条。
ReAct 是串行决策。 每一步都要模型重新参与,模型看到的信息量随步数增长。好处是灵活,中间发现不对能立刻改方向。
脚本模式是一次规划。 模型只参与两次:生成脚本、看结果摘要。中间成百上千次操作全在沙箱里跑,不消耗模型调用。好处是成本和上下文都恒定。
我写了个测算脚本,把两种模式的 token 消耗按固定参数算出来(不是真实 API 计费,是按每轮固定开销累加的理论值)。
 步骤数 |      ReAct 全历史 |     ReAct 窗口3 |       脚本模式 |       省多少倍
--------------------------------------------------------------------
     5 |          6,100 |         5,920 |      1,900 |       3.2x
    10 |         16,700 |        12,920 |      1,900 |       8.8x
    20 |         51,400 |        26,920 |      1,900 |      27.1x
    50 |        263,500 |        68,920 |      1,900 |     138.7x
   100 |        977,000 |       138,920 |      1,900 |     514.2x
数字有点夸张,我讲讲它为什么这么夸张,以及哪些地方不能当真。
ReAct 全历史那一列的增速是平方级的。第 n 步的输入是 800 + (n-1) × 180,累计求和就是 n²/2 量级。50 步 26 万 token,听起来吓人,但这是理论值,真实情况中没人会真的让上下文无限累积。
所以我加了第三列:ReAct 滑动窗口。只保留最近 3 步的历史,单轮输入封顶在 1,340。这是大多数工程实现会做的裁剪,也是更公平的对照。即便如此,50 步的总消耗还是脚本模式的 36 倍。
四、第 20 步那一轮最能说明问题
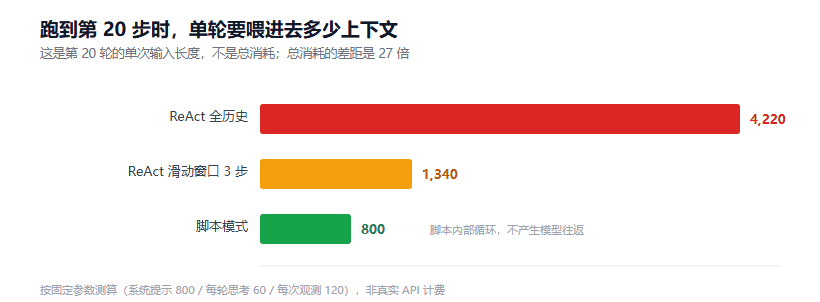
图 1:跑到第 20 步时,三种模式的单轮输入长度对比
这一轮,ReAct 全历史要喂 4,220 token,窗口版 1,340,脚本模式恒定为 800。
4,220 这个数字意味着什么?意味着你花在"让模型想起前面发生了什么"上的钱,是花在"让它思考这一步"上的几十倍。每轮输出才 60 token。
我认为这才是 ReAct 循环真正的成本结构:绝大部分 token 花在复述历史,不是花在推理。
五、脚本模式的代价
说完好处,得说代价,而且我认为这些代价比省钱重要。
一,中途不能改主意。 脚本是一次写完的,跑到第 5 步发现前面的假设错了,它没法停下来重新规划。你的脚本要么有分支处理,要么整个失败重来。
二,出错难定位。 ReAct 的每一步都有模型写的思考记录,出问题能顺着日志看它当时怎么想的。脚本出错就是一行堆栈,模型当时为什么这么写,得去读脚本本身。
三,对沙箱的要求高。 让模型生成的代码在本地跑,风险实打实。沙箱要限制文件系统、网络、执行时间,还得防注入。这块做不扎实,省钱换来的是安全事故。
四,不适合探索型任务。 如果你自己都不知道要走几步、每步会得到什么,就没法一次写好脚本。这种情况下 ReAct 的灵活性是刚需。
我的判断是:脚本模式适合"流程确定、步骤多、每步之间没有意外"的任务,比如批量改配置、批量跑测试、批量拉数据。这类活占到日常工作的比例不小,值得单独做一条路径。
六、怎么在项目里同时用两种
不要二选一,按任务类型分流。
判断标准很简单,问一句:这个任务的步骤数能不能提前确定。
能确定的,走脚本。 给模型的任务描述里写清楚输入输出和约束,让它生成脚本,沙箱执行,你验收结果。
不能确定的,走 ReAct。 探索类、调试类、需要根据中间结果调整方向的,老老实实一步一步来。
还有第三种情况值得单独提:混合模式。先让模型生成脚本跑前 80% 的确定部分,跑完把结果交给 ReAct 循环处理剩下的不确定部分。这个做法在数据清洗这类任务上特别有效。
七、坑清单
1. 以为省的是往返次数,其实省的是上下文。 这个误解会导致优化方向错。减少往返次数但每轮还是全量历史,省不下来多少。
2. 沙箱只限制网络不限制文件系统。 生成的脚本能读你的密钥文件、能改你的配置,沙箱等于没做。文件系统权限必须一起限。
3. 脚本没有超时保护。 模型写出一个死循环的概率不低,尤其在处理"遍历所有"这类需求时。执行必须带超时和步数上限。
4. 脚本执行结果不做校验。 脚本跑完返回 200 不代表业务成功。要有断言,没有断言就用脚本模式等于放弃了中间检查。
5. 忘了脚本本身也要算 token。 一段 900 token 的脚本,生成成本不低。如果任务只有两三步,脚本模式的固定开销反而更贵,5 步那一行 3.2 倍就是这么来的。
八、边界
这个测算用的是固定参数,真实场景里每轮开销会随任务复杂度变化,倍数的绝对值不能直接套。
滑动窗口那一列是我按 3 步算的,实际项目里窗口大小怎么定,取决于任务需要多长的记忆。窗口太小会丢关键信息,太大又回到成本问题。
还有一个我没算的变量:失败重试。脚本模式失败一次要整体重来,ReAct 失败只补那一步。任务越容易失败,脚本模式的隐性成本越高。
站里之前写过给 Agent 加预算护栏,讲的是怎么在超支前拦住。这篇讲的是换个结构从根上少花,两者配合起来才有意义。
参考资料
- Communeify - 11 月 1 日 AI 日报,含 Factory Droid 1.0 发布说明
- Factory 官方 - Droid 文档与沙箱执行说明
- ReAct 论文 - Synergizing Reasoning and Acting in Language Models
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。