
一句话总结:多伦多大学 10 月的一篇论文测了「什么决定 ChatGPT 引用哪个页面」。答案是:站内比较时,检索解释了 32% 的差异,排名单独解释 26.8%,而页面上的所有可改项——标题、结构、FAQ、schema、作者框、加载速度——加起来只有 2.8%。你的页面优化能影响的,比你想象的小一个数量级。
今年陆陆续续写了不少 GEO 相关的文章,讲怎么让内容被 AI 引用。
前阵子想把那些建议理成一张清单,理到一半发现个问题:我推荐的那些动作,一条都没验证过。
于是去翻论文。翻完有点难受。
一、两篇论文测的是同一件事:什么决定被引用
先说清楚这两份研究的口径,不然数字会被误读。
第一篇是多伦多大学的《What Drives AI Citations?》,作者 Mahe Chen 和 Nick Koudas,2026 年 10 月。它做的是归因分解:把「为什么这个页面被引用、那个没有」拆成几个来源,看各占多少。
关键区分:它做了两个层次的比较,即站内(同一个网站的不同页面之间)和跨站(不同网站之间)。这两个层次的结论不一样,必须分开看。
第二篇是 Search Engine Land 11 月 2 日发的《The Quiet Click》,用的是 1007 份美国成年人问卷 + 约 11100 个关键词的点击流数据(2024 到 2026,月均 8.626 亿次搜索)+ 28327 条研究与对比类查询的审计。
它测的不是「为什么被引用」,是「用户看到 AI 答案之后做了什么」。
两篇合起来,能回答一个完整链条的问题:怎么被引用、被引用了有什么用。
二、AI 引用靠的是检索,不是页面优化
第一篇的核心数字:
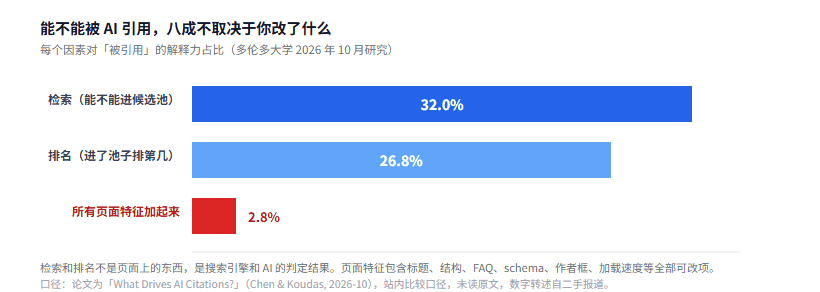
图 1:三根条的差距是 11 倍,红色那根只有 44 像素长
| 因素 | 解释力 |
|---|---|
| 检索(能不能进候选池) | 32.0% |
| 排名(进了池子排第几) | 26.8% |
| 所有页面特征加起来 | 2.8% |
三个数加起来 61.6%,剩下的 38.4% 是这篇论文也没解释的部分。
32% 对 2.8%,差 11.4 倍。 这个对比的意思是:你的页面能不能被 AI 引用,主要决定于「它有没有被检索到」和「检索到之后排第几」,而这两件事都不是你在页面上能直接改的。
再看第二个层次。如果只看「已经被捞进候选池的那些页面」,谁被选中:
排名单独解释            26.8%
加上问题匹配            →
加上引擎自己的查询      →  合计 32.5%
加上所有页面特征        →
所有你能改的东西加起来,只把解释力从 26.8% 抬到 32.5%,多 5.7 个百分点。
论文的结论说得挺克制:大部分结果不由页面上的任何东西解释,所以要预期一部分不可控,按月度量而不是改一次就忘。
三、那些 GEO 技巧,站内比较时没有效果
这条最扎人。
论文测了这些:FAQ 块、结构化数据(schema)、摘要框、作者框、页面加载速度。
站内比较时,全都没有显著效果。
但论文同时说:跨站比较时,它们全都看起来是正向的。
这两个结论矛盾的,论文自己给了原因——辛普森悖论。已经能拿到大量引用的站,本来就更倾向于用这些功能。所以跨站看是「用了这些的站引用多」,站内看才发现「同一个站里,用了这些的页面不比没用的多」。
我读到这段的时候停了一会儿。
因为过去半年我写过好几篇讲 schema 和结构化数据的文章,其中一部分就是按「这样更容易被引用」的逻辑推的。这个逻辑在站内比较下不成立。
论文没否认这些功能有用,只是把它们的定位改了:结构化数据帮机器准确读价格、营业时间、评分;快页面真人喜欢。这些是卫生条件,不是捷径。
(顺带说一句,站内那篇 GEO 的机制讲的是「从争夺投票变成争夺被提及」,方向没错,但当时把页面优化的权重估高了。)
四、零点击率在降,复核点击在升
第二篇的问卷数据,有几个数字推翻了我的假设。
| 行为 | 占比 |
|---|---|
| 至少有点信任 AI 摘要 | 64% |
| 购买前想要一个真实来源 | 71% |
| 读完 AI 答案后点链接复核 | 56% |
| 滚过 AI 摘要直接看传统结果 | 22% |
| 读完 AI 答案就停 | 16% |
56% 会点链接复核。 这个数字比我预期高很多。
我原来的判断是「AI 摘要会吃掉点击」,但数据说:大部分人拿 AI 摘要当定位工具,要掏钱或者要做决定的时候,还是会点进去看原始来源。
点击流那边也印证了:零点击率从 2024 年的 43% 降到 34%(降了 9 个点),搜索内重查询从 54% 升到 63%。
意思是:AI 答案不是搜索的终点,是搜索的一个中间站。
这对内容站的启示很具体:你的页面要能承接「复核」这个动作。
什么叫能承接复核?用户看完 AI 摘要,心里有个半信半疑的结论,点进来想看的是:
- 这个数字是哪来的、怎么算的
- 有什么前提条件、什么情况下不成立
- 有没有人试过、结果如何
纯复述事实的页面接不住这个动作,因为 AI 摘要已经把事实说完了。能接住的是有方法、有数据、有边界的那类。
这也是我一直在写「自己跑一遍数据」的原因,虽然当时不知道有这个数据支撑。
五、剩下那 2.8% 页面特征能做什么
2.8% 不等于零。而且论文给了两个具体有效的动作:
标题更贴近用户提问,每标准差多 14.1% 引用。
最佳段落更贴近提问,每标准差多 15.5% 引用。
这两条是所有测量项里唯一站内也显著有效的。
怎么用?论文的建议很直白:
- 小标题按「买家用什么话问」来写,别按「我怎么分类」写
- 每个小标题下第一两句就把答案给出来
- 每个小节自足,让助手能单独拎走一段
为什么段落匹配比标题匹配权重稍高? 我猜是因为 AI 引用粒度更细——它经常只摘一段,不摘整页。标题决定「要不要看这页」,段落决定「摘哪一段」。
这解释了一件事:为什么那种「先铺垫五百字再给答案」的写法在 AI 搜索里特别吃亏。铺垫的部分不构成可引用的段落。
六、论坛比品牌页更受信任
第二篇里有一组数,我觉得对内容站威胁最大:
| 内容类型 | 信任度 | 点击率 |
|---|---|---|
| 论坛 / 社区帖 | 21% | 22% |
| 其他(品牌页、媒体、电商等) | 合计 79% | 合计 78% |
论坛和社区在两项上都排第一。而且 GeoBuddy 那边统计的最常被引用域名是 reddit.com、youtube.com、linkedin.com,三个都是用户生成内容平台。
这意味着内容站的竞争对手不是同行,是论坛。
我在注意力那篇里讲过类似的事:红果短剧 4.3 亿月活,抢的不是长视频的份额,是用户那点空闲时间。这里同理,AI 引用抢的是「被信任的位置」,而论坛天生占着这个位置——因为它有真实用户的争论和反驳。
品牌页做不到这点。品牌页不会说自己的产品不适合谁。
所以能做的事是:明确写出局限性、适用边界、以及什么情况下不该用。 这听起来像自损,但它恰好是论坛帖最像的部分。
七、常见问题
这些研究的样本够大吗?
第二篇的点击流覆盖约 8.6 亿次月搜索、11100 个关键词,问卷 1007 人。第一篇的具体样本量报道里没给全。我倾向于认为方向可信、具体数字要打折。
2.8% 是不是说明页面优化完全没用?
不是。它说明「页面特征对引用的解释力」只有 2.8%,不等于「优化没用」。可能是这个测量方式抓不到真正的机制,也可能是页面特征之间高度相关、互相稀释了。这一条我保留怀疑。
那还要不要做 schema 和 FAQ?
做,但别指望它带来引用。把它当「让机器准确读取信息」的卫生工作,别当增长手段。
AI 引荐流量值不值得追?
看转化。Ahrefs 那边统计 6 万个站,所有 LLM 加起来带来不到 1% 流量,Google 是 41.35%。另一组 GA4 数据显示 AI 引荐只有 Google 自然流量的 0.62%,但转化率 13.8% 对 3.02%——高 4 倍多。
量小、质高。值得接住,不值得为它改整站策略。
内容站还有没有机会?
有,但位置变了。以前是「提供信息」,现在是「提供证据」。信息 AI 自己会说,证据它给不了。
八、结语
这组数据让我改了一个判断。
以前我认为 GEO 是「一套新的页面优化方法」。现在我认为它是「传统 SEO 的延伸,加上一点内容形态的调整」。
因为 32% 在检索上、26.8% 在排名上——这两件事基本就是传统 SEO 的活儿。真正新的部分只有那两条:标题和段落匹配提问。
这个结论不好听,但它省钱。 你不需要为 GEO 单独做一套东西,需要的是把已有的内容写得更像「回答」而不是「介绍」。
至于那 38.4% 没被解释的部分,我猜短期内也不会有答案。在一个大部分不可控的系统里,把可控的那部分做到位,剩下的交给时间。
参考资料
- Castle - LLM Citations: What They Are and How to Earn Them - 本文两篇论文数字的主要转述来源,含 Ahrefs 与 GeoBuddy 数据
- DEV Community - The Quiet Click: How AI Answers Are Changing Organic Search Behavior - 问卷与点击流数据的二手整理
- Web Pulse - AI Referrals Are Small, but GA4 May Miss How AI Shapes Buying Decisions - AI 引荐的转化率数据来源
- GeoBuddy - AI Search Statistics 2026 - 品牌可见度与被引用域名的实测统计
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。