
一句话总结:月之暗面 10 月 24 日发布 Kimi K3.1 Pro,仍是 2.8 万亿参数、1040 亿激活的开源最大模型,AA 智能指数从 K3 的 43.6 涨到 55.1、全球第 4、开源第一,Terminal-Bench 4.0 拿到 65.7% 只比 Claude Opus 5.5 低不到 1 个百分点,权重承诺 11 月 4 日前放出。
三个月前 K3 发布时,大家讨论的是「开源模型能不能打」。这次 K3.1 Pro 出来,问题变成了「还差多少」。
答案给得很具体:Terminal-Bench 4.0 上,K3.1 Pro 65.7%,Claude Opus 5.5 是 66.4%,GPT-6 Astra 是 58.2%。差 0.7 个百分点,基本可以算同一档了。
规格:参数没变,能力重训
| 项目 | 规格 |
|---|---|
| 发布 | 2026-10-24 凌晨,K3.1 系列首款 |
| 总参数 / 激活 | 2.8T / 104B(与 K3 同规模) |
| 上下文 | 1,000,000 Tokens |
| 定位 | K3 的后训练版本,非重新预训练 |
| 强化重点 | 代码、3D 创作、金融研究、长程 Agent |
| AA 智能指数 | 55.1(全球第 4,开源第 1) |
| 权重 | 承诺 11 月 4 日前放出完整权重 |
| 价格 | 官方称约为 GPT-6 Astra 的五分之一 |
参数没动,提升全部来自后训练。官方说这版大幅增加了后训练算力,把强化学习扩展到数百个下游领域,同时重构了 RL 框架、长上下文推理、训练效率和沙箱调度。
这句话翻译成人话:不是模型变聪明了,是它在真实任务上被练得更会干活了。
两个分数,两个含义
AA 智能指数 55.1。 这是第三方盲测的综合分,比 K3 的 43.6 高了 11.5 分。同期的开源对手是小米 MiMo-V2.6-Pro 46.3、智谱 GLM-5.3 44.8,K3.1 Pro 直接把开源第一拉开近 10 分。
Terminal-Bench 4.0 是 65.7%。 这个测试考的是「在终端里把活干完」的能力,跑的是真实命令、真实文件、真实报错。65.7 意味着它已经能独立处理绝大多数多步骤命令行任务,和 Opus 5.5 的 66.4 只差 0.7 分。
内部还有一项长程代码基准:K3.1 Pro 61.2%,K3 是 55.95%。这个提升幅度(5 个百分点)比综合分更能说明问题——长程任务正是 Agent 落地的瓶颈。
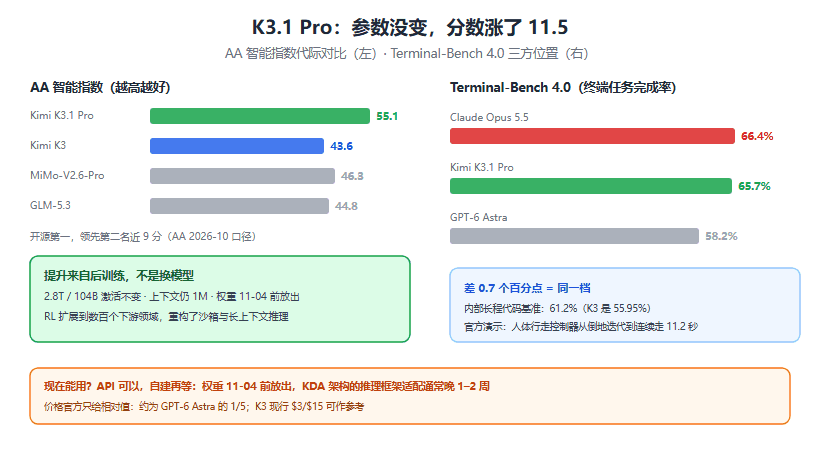
图 1:左边是 AA 指数代际对比,右边是 Terminal-Bench 4.0 的三方位置
官方演示里最值得看的不是分数
官方给的一个案例比跑分有说服力:让模型搭一套模拟人体行走的控制系统,要求它自己分析实验结果、定位问题、迭代控制器。
结果是从「走几步就倒」练到「连续行走 11.2 秒」,中途还修正了肩部肌肉力臂计算里的 36 处错误,并据此重新训练控制器。
这个案例的价值在于自我修正:不是答对一道题,是在失败反馈里持续改进。这也是这代模型把 RL 扩展到数百个下游领域的直接结果。
该不该现在上
现在上,理由两个:
- 它的强项(代码、3D、金融、长程 Agent)正好是当前落地最缺的能力,Terminal-Bench 65.7 已经能进生产链路
- 开源第一,价格是 GPT-6 Astra 的五分之一,性价比断层
等一等,理由也有两个:
我的建议:有 API 需求现在就用,想自建等 11 月中旬。K3 的教训是权重刚放出那两周框架适配很乱,别赶第一批。
和 K3 的关系
K3 不会立刻过时。两者同参数规模,K3 的权重已经在手、社区跑通、价格可能随新版下调。做模型对比实验、做微调研究,K3 仍是更好的起点;做生产任务,K3.1 Pro 的后训练红利是实打实的。
顺带说一句背景:这次发布在月之暗面赴港 IPO、估值 500 亿美元的前夜。从「参数竞赛」转向「场景交付」,是这家公司今年最明显的变化。
常见问题
K3.1 Pro 是重新训练的模型吗?
不是,是 K3 的后训练版本。底座架构和参数规模不变,提升来自更大规模的后训练和 RL。
55.1 分在什么水平?
AA 智能指数全球第 4,开源模型第 1。前面三名是闭源模型(具体排名随榜单版本变化,以 AA 当期数据为准)。
权重什么时候能用?
官方承诺 11 月 4 日前放出完整权重。放出后还需要推理框架适配,实际可用时间通常晚一到两周。
价格具体多少?
官方只给了「约为 GPT-6 Astra 的五分之一」这个相对说法,具体单价要等 API 定价页更新。K3 目前是 $3/$15,可作参考。
要长程代码和终端任务选 K3.1 Pro;要多模态全能和 1M 上下文稳定性选 Qwen3.8-Max;要金融和单任务成本选 Step5。
结语
K3.1 Pro 是国产开源模型第一次在硬指标上贴到闭源旗舰:0.7 个百分点的差距,基本属于「同一档、各有胜负」。这对整个开源阵营是标志性事件。
但别急着下结论说「开源追平闭源」。Terminal-Bench 只测终端任务,通用推理、多模态、工具调用还有距离。真正的判断要等 11 月权重放出、第三方复现之后。
参考资料
- Kimi K3.1 Pro 发布报道(每日经济新闻) - 发布时间、参数、Terminal-Bench 与 AA 排名出处
- Kimi K3.1 Pro 性能与定价分析(北京日报) - 价格约为 GPT-6 Astra 五分之一、行走控制案例
- Kimi K3 模型卡(Hugging Face) - 架构与许可证参考
- Artificial Analysis 智能指数 - 第三方盲测口径
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。