
一句话总结:华为昇腾 950 超节点在世界互联网大会上获领先科技奖,单节点集成 1024 张加速卡、支持 256TB 统一内存编址。它的意义不在卡多,在于把 1024 张卡的显存编成一个地址空间——训练万亿参数模型时,程序看到的是"一大块内存",不用自己处理跨卡搬运。
11 月 2 日,世界互联网大会颁了 20 项领先科技奖。
里面有一项是华为的昇腾 950 超节点。参数写得很干脆:单节点 1024 张加速卡,256TB 统一内存编址。
这两个数字放在一起,比单独看任何一个都有信息量。
一、昇腾 950 超节点是什么
先把概念理清楚。
超节点不是"很多台机器连起来",是"一台逻辑上的大机器"。
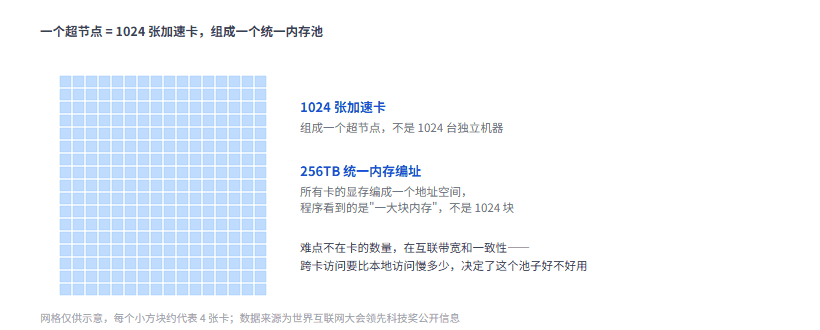
图 1:1024 张卡组成一个节点,256TB 显存编成一个地址空间
区别在哪:
普通集群里,每台机器有自己的内存空间,跨机器访问要走网络(比如 InfiniBand),延迟是微秒级的,还得靠代码显式处理(发消息、等回包、解析)。
超节点里,所有卡的显存被编成一个统一的地址空间。程序访问远端显存,用的是访存指令,不用写通信代码。延迟高一些,但语义上就是"读一块内存"。
这个差别决定了并行训练的代码复杂度。
二、1024 张卡放进一个节点,图什么
图的是通信。
训练大模型的时候,最耗时的不是算,是等数据来回搬。一张卡算完一部分,要把结果同步给其他卡,这一步叫 All-Reduce 或者 All-Gather。
卡的规模越大,同步的代价越高。8 卡的时候,走 PCIe 或者 NVLink 就行;上千卡的时候,如果还走普通网络,通信时间会超过计算时间——机器全在等消息。
超节点的解法是:把互联做到极快,快到"跨卡"和"卡内"差别不大。
具体到 1024 这个规模,意味着很多原来必须拆成"节点间通信"的操作,现在可以在"节点内"完成。
LongCat 那篇讲过类似的思路:国产单卡显存有限,靠把多卡组成一个大节点来绕开通信瓶颈,长序列 SFT 的单卡吞吐因此提升了 86%。
三、256TB 统一编址解决的是显存墙
第二个数字更关键。
单张加速卡的显存是 64GB 或 80GB 这个量级。训练万亿参数模型,光权重就要几 TB,一张卡装不下,必须切分。
切分之后就有个问题:模型的一部分在这张卡上,另一部分在那张卡上,计算的时候要来回取数据。
传统做法是写代码显式管理——哪一层放哪张卡、什么时候同步、什么时候等。这套逻辑写起来极其繁琐,而且容易出错。
统一编址把这件事交给硬件:1024 张卡 × 约 256GB 的显存,编成一个 256TB 的池子。程序申请内存的时候,不关心它实际落在哪张卡上。
这也解释了为什么"万亿参数训练"需要这种底座。万亿参数按 FP16 算要 2TB 显存,加上优化器状态和梯度,实际需求是好几倍。 没有一个大内存池,光切分策略就能把工程团队拖垮。
四、万亿参数训练需要什么样的底座
把需求列清楚:
容量。 权重 + 梯度 + 优化器状态,万亿参数模型要几 TB。256TB 的池子能装下,还留了激活值的空间。
带宽。 每次参数更新都要同步,带宽不够就是干等。
一致性。 统一编址要求缓存一致,否则读到旧数据,训练直接发散。
容错。 1024 张卡跑几周,坏几张是常态。得有办法隔离故障卡继续跑,而不是整个任务重来。
软件栈。 编译器、通信库、并行框架,都得支持这种拓扑。
前三条是硬件,后两条是工程。真正难的是后两条。
五、和 DeepSeek V5 那条消息的关系
前天有条消息说,DeepSeek V5 计划用昇腾 950 做预训练,节奏指向明年。
把两件事放一起,逻辑就通了:DeepSeek 要用国产卡训练万亿级模型,需要的就是这种底座。
那篇里我提过一个矛盾——代码库占位说 11 月发 V5,但昇腾训练说"明年落地"。现在补一条背景:昇腾 950 超节点这类硬件如果明年才规模可用,那"明年训练"就对得上了。
不过要说明:获奖不等于量产。 领先科技奖评的是技术成果,不是产能。实际能交付多少、良率如何、软件栈成熟度如何,公开信息里没有。
另外,1024 卡这个规模的"超节点"和英伟达 NVL72 的 72 卡不是一个定义——后者是单机柜,前者可能跨多个机柜。直接比数字会误导,得看具体的互联拓扑和延迟指标。
六、常见问题
超节点和普通集群的区别是什么?
普通集群跨机器访问要走网络协议,超节点用统一地址空间,程序不用写通信代码。
256TB 是显存总量吗?
是统一编址的地址空间总量,由 1024 张卡的显存聚合而成。具体每卡多少,看配置。
能训练多大的模型?
理论上限取决于总显存和并行策略。万亿参数级别是官方提到的目标场景。
和英伟达的方案比怎么样?
架构思路一致(都是把多卡编成一个大内存池),规模定义不同,不能直接比数字。实际表现要看互联带宽和软件栈成熟度。
普通开发者能用上吗?
用不上。这是给训练集群用的基础设施,个人通过云服务间接使用。
结语
这类硬件新闻容易写成参数罗列。但它真正的价值在降低了一件事的门槛:让"用国产卡训练万亿模型"从不可能变成可能。
可能和好用之间还有距离。软件栈成熟度、故障率、实际吞吐——这些才是决定它能不能被大规模采用的指标,而它们都不在奖项材料里。
参考资料
- 搜狐:今日 AI 行业热点速览 - 昇腾 950 超节点获奖信息与规格
- 财联社:DeepSeek V5 计划基于昇腾预训练 - 训练侧需求背景
- 新华网:乌镇峰会开源主题报道 - 领先科技奖获奖名单
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。