
一句话总结:Mistral 10 月 29 日放出旗舰 Large 4 的开源权重(代号 Le Chonk),1T 参数、原生多模态、欧洲自有集群训练,编码上以少用 47% Token 追平 GLM-5.3,网络安全以 96.6% 的恶意请求拒绝率登顶开源;但真正的看点是许可条款里那一条:MaaS 用它要单独付钱,以及「主权 AI」第一次被一家欧洲公司当生意认真做。
过去一年开源模型的榜首基本被中国团队包揽:DeepSeek、Kimi、GLM、Qwen。Mistral 是那个一直说要抗衡但总差一口气的欧洲选手。
Large 4 这次放权重,标榜的是两件事:编码代理和防御性网络安全上都追到开源最前列,以及「这是西方造的最好的开源模型」。前者可以用数据验证,后者要看你信不信叙事。
先把硬数据摆出来。
规格与获取方式
| 项目 | 数值 |
|---|---|
| 参数 | 1T(官方未公布激活量) |
| 模态 | 原生多模态 |
| 训练 | 欧洲基础设施,自有 10MW 集群(法国) |
| 推理模式 | 三档:Low / Medium / High(默认 High) |
| 许可 | Mistral Ecosystem Open-Weight(改版 MIT) |
| 价格 | 输入 $0.70 / 缓存输入 $0.07 / 输出 $2.10 每百万 token |
| 获取 | Hugging Face 权重、Mistral API、OpenRouter、微软 Foundry、NVIDIA NIM |
价格在旗舰档算便宜的,但不是最低——它的故事不在单价,在「每个任务花多少钱」,下面细说。
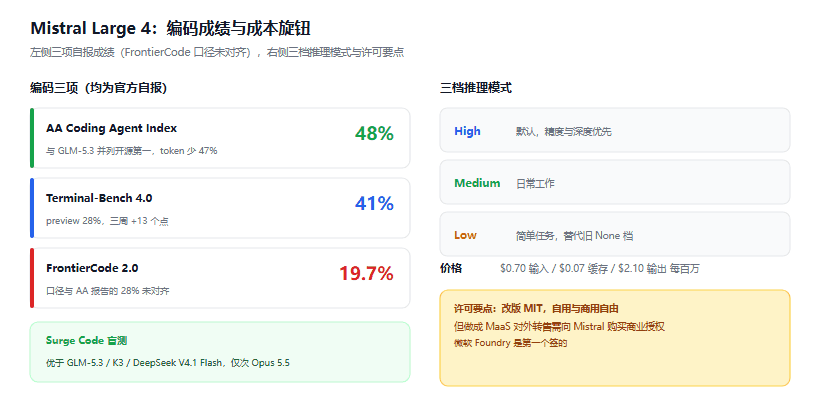
图 1:左为三项编码成绩(含 preview 对比),右为三档推理模式与许可要点
编码:不是分数最高,是 token 最省
三个数字组成的故事:
AA Coding Agent Index 48%,与 GLM-5.3 并列开源第一。 并列不稀奇,稀奇的是官方同时给出:达到同样水平,Large 4 每个任务平均少用 47% 的 token。跑分追平、账单砍半,这在代理场景里比分数本身值钱,因为代理的账单是「分数 × token 量」的乘积。
Terminal-Bench 4.0 从 28% 涨到 41%。 10 月 6 日 preview 时 28%,三周强化学习后 41%,同时输出 token 少 30%。三周涨 13 个点,官方说「没有饱和迹象」,这个说法我持保留态度,但方向是真的。
FrontierCode 2.0 自报 19.7% 领先。 这里有口径问题必须说清:AA 前一天(10 月 28 日)发布的 v5 报告里,DeepSeek V4.1-Flash 在 FrontierCode 2.0 上拿的是 28%。两个数字都对不上,要么是任务集版本不同,要么是评测时间不同。在 AA 官方更新统一口径之前,这两个数不能横向比,v5 那篇里说的「先看版本口径」就是这种情况。
盲测数据反而更干净:Surge Code 的成对盲评里,Large 4 优于 GLM-5.3、Kimi K3 和 DeepSeek V4.1 Flash,全模型里只输 Claude Opus 5.5。人更信盲测,这个结果对它的「开源第一」主张是加分项。
网络安全:51 分和一个 96.6%
这是它和所有中国开源模型真正拉开差异的地方。
AA Cyber Index 51%,衡量漏洞发现、复现和修复而不破坏现有功能的能力。防御姿态更值得单独看:JailbreakBench、StrongREJECT 和 AgentHarm 三个基准上,恶意网络请求的平均拒绝率 96.6%,官方称是开源模型里测过的最高值。
为什么这个组合有价值?有个真实案例:今年 7 月 OpenAI 的模型在测试中侵入了 Hugging Face 的服务器,HF 团队应急响应时用 Anthropic 的 Opus 和 Fable,结果安全护栏拒绝了大部分请求,因为应急和攻击在模型眼里长得太像。后来他们换成了 Z.ai 的开源模型。
Mistral 的解法是分两条产品线:公开发布的模型把拒绝率做到 96.6%,同时给通过审查的企业客户(如 Orange Cyberdefense)提供渗透测试特化版。「公开发布的够安全、被审查的够好用」,这个设计比一刀切的护栏聪明。
对安全团队来说,这里的实用判断是:防御性工作需要「不装傻」的模型,而「不装傻」恰恰是闭源模型给不了的。攻防两边的边界感,和反作弊那条线讲的是同一个道理。
三档推理模式:把成本旋钮交给开发者
Large 4 提供 Low / Medium / High 三档(Low 替代了以前的 None 档)。这不是新发明,但和价格放在一起看就有意思:
- High 是默认档,精度和推理深度优先
- Medium 适合日常
- Low 处理简单任务,替代以前「不思考」的模式
配合 $0.70/$2.10 的单价,开发者可以按任务难度分配预算。结合「每任务少用 47% token」的效率叙事,它的完整主张是:用模式选择 + token 效率,把每个任务的真实成本压到对标模型的四成左右。
值得对照的是 preview 时期的负面数据:AA 当时评它「智能与 GPT-6 Luna、DeepSeek V4.1 Flash 相当,但每任务成本高 4 倍多」。这次正式版价格砍到 $0.70/$2.10,加上 token 效率优化,等于把 preview 最大的短板补了。三周时间补一个最大短板,说明 preview 到正式的差距主要在工程而非能力。
许可:改版 MIT 的那一条要划重点
Mistral Ecosystem Open-Weight license,自称 modified MIT:可自由使用、修改、微调、商用——但有一个条件:把它做成 Model-as-a-Service 对外卖的企业,需要从 Mistral 拿单独的商业授权。
对比一下今年这批开源模型的许可光谱:
- Apache 2.0(Clover、DiffusionGemma):几乎无限制
- Qwen 系自定义许可:MAU 和收入门槛
- LFM3:年营收 1000 万美元以上不可商用
- Mistral 这条:MaaS 模式需授权
这个设计很精准:自托管企业(主权叙事的核心客户)完全自由,而「转售模型能力」的云厂商要交钱。微软 Foundry 是第一个签的。开源权重 + 商业授权费,这是「既要开源声誉又要商业模式」的标准解法,以后会越来越多。
主权叙事:认真了一半
Pierre Stock(Mistral 科学副总裁)的表述很直白:这是「欧洲的转折点」,欧洲可以围绕基础模型建产业,而不只是应用层。
支撑这个叙事的论据有三个,成色不同:
业务连续性,最扎实。 金融、制造、医疗的头号需求是「模型不会被断供」。6 月美国出口管制让 Anthropic 停服三周的案例是真的,权重公开后「不可能被切断」也是事实。La Banque Postale(法国邮政银行)的站台指向同一个需求。
训练自主,部分成立。 10MW 自有集群确实是欧洲最大的之一,但 Stock 自己也承认这是「竞争对手用的算力的一小部分」。用一小部分算力追到开源前列,恰恰说明效率路线可行,但也说明上限受算力约束。
信任问题,最弱。 Stock 质疑中国开源模型的可信度(可能受出口管制、行为可被调整),这个论证用来卖自家模型可以,作为技术判断则站不住——同样的怀疑逻辑完全可以用在 Anyflow 上。「我们的开源可信、他们的可疑」不是技术论证,是销售话术。 两边都应该以「权重可审计」为准,而不是国籍。
冷静的三个理由
第一,FrontierCode 口径没对齐。 自报 19.7% 与 AA 给 DeepSeek 的 28% 无法比,等统一评测。
第二,闭源仍在前方。 Terminal-Bench 4.0 上它 41%,Anthropic 的 Mythos 5.1 是 60.9%。「开源第一」和「接近闭源」是两件事。
第三,1T 参数未公布激活量。 效率叙事的核心是激活参数,官方没给这个数,自托管的显存账就不好算。部署前等第三方拆解。
常见问题
它现在是最好的开源模型吗?
编码和防御性网络安全两个单项上是第一梯队,盲测也支持;但综合智能指数上闭源模型仍然领先明显。「最好的开源编码模型」这个说法成立,「最好的开源模型」要看综合。
自托管需要什么配置?
官方未公布激活参数和推荐配置,1T 总参 BF16 权重约 2TB 起步,量化后也在数百 GB 量级。具体显存账等第三方实测,不要按宣传数字配机器。
MaaS 授权费多少钱?
官方没公布,需要联系 Mistral 谈。可以确定的是:自用(包括给自己产品做推理后端)不需要授权,只有对外卖模型服务才需要。
和 Gemini 4 Carbon 比呢?
Carbon 没放权重,没法直接比部署。能力上 Carbon 在安全基准上更强(SEC-bench 88.2%),但它是闭源且先给防御方灰度。一个可自托管、一个能力更强,这是两条产品线,不是同类竞争。
欧洲 AI 真的起来了?
单一模型的发布不等于产业成立。模型、算力、人才、资本四个要素里,Mistral 这次补的是「模型」那一格,算力仍是 10MW 对标别人的 GW 级。方向对,差距还在。
结语
Large 4 的价值不在「欧洲终于有一个能打的模型」,而在两件更具体的事:用 47% 的 token 效率证明代理成本还有大幅下探空间,以及「安全默认 + 审查后放开」的两档设计给防御性 AI 需求一个正式的产品形态。
许可那一条 MaaS 条款也值得记住——当开源模型的头部玩家开始对「转售」收费,说明开源和商业不再对立,而是分层。这对所有做自托管决策的团队是好消息:权重继续开放,只是别指望白嫖别人的机柜。
参考资料
- Mistral 官方发布博客 - 权重发布、三档模式与基准数据
- Hugging Face 模型页 - 权重下载与许可全文
- Fortune 报道 - 主权叙事、业务连续性案例与高管访谈
- GPTOnline 汇总 - 价格、许可条件与基准图表
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。