
一句话总结:K2.7 Code 是月之暗面 6 月发的编程专用模型,1 万亿参数、256K 上下文、开源权重。最大改进不是跑分,是"少想废话"——思考 Token 平均降了 30%,任务成功率反而涨了 10% 到 31.5%。
编程模型有个通病:想太多。
你让它改个变量名,它先分析五分钟项目架构,再回忆三遍编码规范,最后给出答案。中间那些思考 token 全都要付钱。
K2.7 Code 想解决的就是这个。
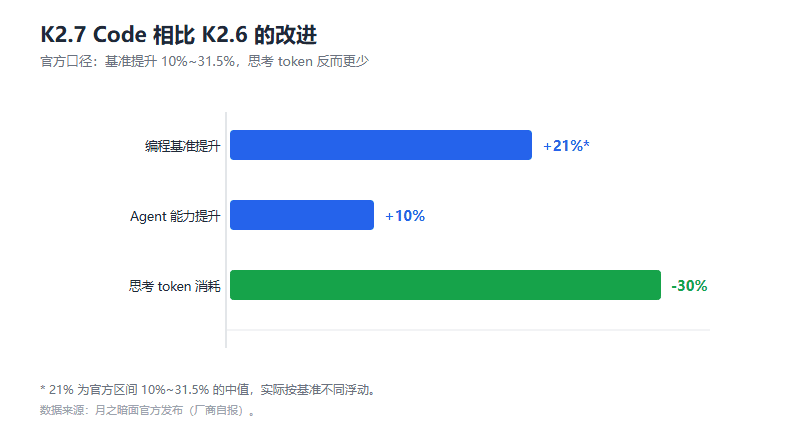
图 1:思考 token 减 30%,基准分反而涨了
架构:还是那个 K2 骨架
| 参数 | 数值 |
|---|---|
| 架构 | MoE |
| 总参数 | 1 万亿 |
| 每 token 激活 | 320 亿 |
| 层数 | 61(1 稠密 + 60 MoE) |
| 注意力机制 | MLA(多头潜在注意力) |
| 专家数 | 384,每 token 选 8 个 + 1 共享 |
| 激活函数 | SwiGLU |
| 词表 | 160K |
| 上下文 | 256K |
| 视觉编码器 | MoonViT(4 亿参数) |
这套配置跟 K2.6 几乎一样。参数没变,专家数没变,层数也没变。
差别在哪?在训练方式和数据上。官方没详细公开,但从结果反推,主要优化了两件事:长上下文里指令遵循的可靠性,以及"别瞎想"。
30% 这个数字值得细说
官方说思考 token 平均减少约 30%。在 Kimi Code Bench v2、Program Bench、MLS Bench Lite 三个基准上,分数都比 K2.6 高,但消耗的 token 更少。
这句话的信息量在于:不是靠少想换便宜,是靠想得更准。
如果只是砍掉思考量,分数必然掉。分数涨了还少用 30%,说明原来的思考里有大量无效推理。
对开发者的实际影响:
交互式编程会话响应更快,不用等它把一句话翻来覆去推敲。生产环境 API 成本直接降三成。Agent 工作流在同样的上下文预算内能多干几件事。
这三个我都在意。第三个最在意,因为 Agent 跑长任务时,上下文预算就是命。
一个必须知道的设计:不支持关闭思考
K2.7 Code 只能开着思考跑,没法关。
这是个明确的产品决策,不是 bug。要关思考,Kimi Code 里会自动把请求转给 K2.6 处理。
所以如果你做的是低延迟场景(比如实时补全),K2.7 不是最优解。要么用 K2.6,要么用 K2.7 的 HighSpeed 变体。
HighSpeed 变体
同一个模型,输出速度提到约 180 tokens/s,短上下文下能到 260。标准版大概 30 多。
代价是配额消耗 3 倍。
有意思的是官方文档里提到一个坑:模型 ID 必须写 kimi-for-coding-highspeed。写错了不会报错,会静默回退到标准版。用户会以为"高速版也不快"。
这个设计我不太认同。静默失败比报错更坑人。
价格
API:缓存命中 $0.19,未命中 $0.95,输出 $4.00 每百万 token。
Coding Plan:$15/月起(年付),分四档到 $159/月。档位越高,每周配额和并发上限越大。
开源:权重在 Hugging Face,可以自己部署。
跑分
官方给的是相对提升,不是绝对分数:相比 K2.6,各项基准提升 10% 到 31.5%,Agent 能力提升约 10%。
这种发布方式有点保留。没有绝对分数,就没法跟别家横向比。
不过从架构看,1T 参数配 32B 激活,这个体量放在 2026 年中属于主流水平。真打起来大概跟 GLM-5.3、MiniMax M3 一个档位,谁强要看具体任务。
该用它还是 K2.6
官方给的建议挺坦率:
编程任务用 K2.7 Code。它专门为这个训练过,长上下文里指令遵循更可靠,端到端成功率更高。
写作、分析、对话用 K2.6。K2.6 更均衡。
这个分工我认同。编程模型和通用模型分开做,不是什么营销概念,是真的有差别。K2.7 为了代码正确性牺牲了一些表达的自然度,写文章会显得干巴。
三个短板
上下文只有 256K。现在 1M 已经不稀奇了,K2.8 和 K3 都是 1M。做整个仓库级别的分析,256K 会卡脖子。
闭源思考。必须开思考这个限制,对某些流水线是硬伤。
跑分不透明。只有相对提升,没有绝对数字,也没说测试集规模。
常被问的
K2.7 Code 和 K2.7 是一个东西吗? 只有 Code 版。K2.7 系列里这个名字专指编程模型。
能微调吗? 权重开源,可以。官方没给微调脚本。
HighSpeed 值得加钱吗? 做实时补全值得,跑批处理不值得。3 倍配额换 6 倍速度,看你的场景是等人还是等机器。
最后
K2.7 Code 让我觉得有意思的地方,不是它多强,是它承认了一个问题:模型想太多是种浪费。
整个行业都在比谁的推理链更长、思考更深。K2.7 反过来说"我们砍了 30% 的思考,效果还更好了"。这个方向值得关注。
如果你的编程 Agent 现在 token 账单很难看,可以先算算有多少是花在无效推理上。这个比例可能比你想的高。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。