
一句话总结:月之暗面 10 月 23 日发布的 Kimi K3.1 Pro 用 2.8 万亿参数、104B 激活、100 万上下文把开源模型推到 AA 智能指数第 4 位,定价从 K3 的 $3/$15 降到 $2/$10,但因为它每任务要写 5.5 万输出 Token,第三方算出的单任务成本仍是 $1.98,和上一代持平。降价的是单价,不是交付。
一、这次升级没有动架构,动的是后训练
先摆一个容易误读的点。K3.1 Pro 名字里带 Pro,参数从 K3 的规模继续往上,看起来像新一代基座,实际上月之暗面自己在发布文里写得很直白:这是 K3 的后训练版本,架构没变,变的是强化学习那一段的规模。
具体做法是把 RL 的覆盖范围从少数几个领域铺到"数百个下游领域",为此重写了 RL 框架、长上下文推理、训练效率、沙箱基础设施和调度系统。官方的说法是让每一份新增算力都转化成稳定回报。这话听着像公关,但对照跑分看,方向确实成立:AA 智能指数从 K3 的 44 分跳到 55 分,11 分的涨幅在同一个基座上属于相当大的后训练收益。
架构沿用 K3 的配置:896 个专家、每 token 选中 16 个加 2 个共享,原生精度是 MXFP4 权重配 MXFP8 激活,从 SFT 阶段就这么训。多模态走 MoonViT-V2 编码器,吃文本、图像和视频。
我最想强调的一点是:这套配置意味着你没法用"模型变强了"来解释价格。架构一模一样,能力来自后训练,那么成本结构该变的只有推理侧的输出长度和后训练摊销。
二、规格和定价,一张表看完
| 项目 | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 总参数 | 2.8 万亿 | 同 |
| 每 token 激活 | 104B | 同 |
| 专家数 | 896(16 选中 + 2 共享) | 同 |
| 上下文 | 1,048,576 token | 同 |
| 输入模态 | 文本 / 图像 / 视频 | 同 |
| 权重精度 | MXFP4 权重、MXFP8 激活(QAT) | 同 |
| 输入价 | $2 / 百万 token | $4 |
| 输出价 | $10 / 百万 token | $20 |
| 缓存命中 | $0.20 / 百万 token | 未单列 |
| 相对速度 | 1× | 2–3× |
| 权重 | 承诺 11 月 4 日前放出 | — |
标准版三个价格相对 K3 的 $3/$15/$0.3 全部下调三成三。Highspeed 是双倍价格换两到三倍出字速度,这个换算我认为是划算的:如果你的场景是交互式编码或者实时补全,等待时间比 token 账单更贵。
官方没有公布权重许可证。K3 用的是自定义协议,不是 Apache 也不是 MIT。想自建的人得等条款出来再决定,这一点比跑分重要得多。
三、跑分要分三层读,因为三个数不是一回事
Terminal-Bench 4.0 这张表是最容易被拿去做标题的。官方自报 65.7%,Claude Opus 5.5 是 66.4%,GPT-6 Astra 是 58.2%。差 0.7 分,媒体就写"逼近"。
但 Footnote 里藏了两件事。测试跑在 Claude Code 的 harness 里,推理强度开到 max。harness 的选择对这类智能体基准的影响大得惊人:AA 用自家 harness 独立测同一个模型,Terminal-Bench 4.0 拿到 67%,比官方还高;而 K3 在 AA 的 harness 下只有 13%,官方口径里 K3 是 88.3%(那是更简单的 2.1 版)。同一家公司两代模型,换个测法分数能从 13 变到 88,这说明榜单之间根本不能横向比。
第三方唯一独立的数是 AA 智能指数 55 分。全球第 4,开源第一,前面是 Opus 5.5 的 58、Sonnet 5.5 的 56 和 Muse Wonder Full 的 56。这个位次比"开源第一"这个标签更有意义:开源模型第一次挤进前四,和闭源头部的差距缩小到 3 分以内。
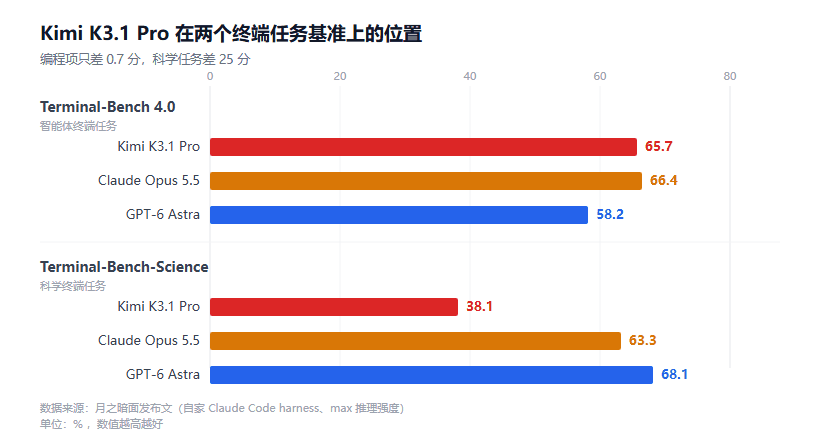
图 1:Kimi K3.1 Pro 与两个闭源头部在两项终端任务基准上的对比。数据来自月之暗面发布文(自家 harness、max 推理强度),Terminal-Bench-Science 一项差距最大
四、真正的短板在科学任务上,不在编程上
编程这一项已经很能打了:BenchCAD 带工具 92.7%,Opus 5.5 是 96.2%,Astra 是 95.9%;OfficeQA Pro v2 拿到 64.4,官方称 SOTA;内部 Kimi Code Bench 3.0 长程项从 55.95% 涨到 61.2%。
弱的是 Terminal-Bench-Science:38.1%。同一个榜上 Opus 5.5 是 63.3%,Astra 是 68.1%。差 25 个点,这不是噪声能解释的量级。
我的解读是:这个模型的强项集中在"软件工程的动作序列"上,写代码、跑命令、改文件、看报错再来一遍,这类循环它做得很好;一旦任务要求它理解实验设计、判断一个物理量是否合理、或者从数据里推出机制,能力就断崖。3D 创作和金融研究这两个宣传重点,本质上也是既有工具链的动作编排,不是科学推理。
如果你的业务是跑实验、读论文、做数值分析,这个模型现在不该进你的第一顺位。它适合的是把需求变成能跑的东西。
五、降价三成,为什么每任务成本没降
这是我最想算清楚的一笔账。
AA 给出的单任务成本是 $1.98,和 K3 基本持平。原因不在价格,在输出长度:K3.1 Pro 每个任务平均要写 55K 输出 token,K3 是 48K,多了 14%。三成三的单价降幅,被一成四的冗长几乎吃干净。
模型的思考默认是开着的。API 的 reasoning_effort 有 low / high / max 三档,默认 max。这意味着你按 token 付费时,付的钱里有一大块是看不见的推理过程。
我对这件事的判断比较直接:按 token 报价的时代基本结束了,接下来该按任务报价。你自己做选型时,别拿价目表比,拿一件真实任务跑十遍,把输入、输出、重试、失败全算进去,再除以成功次数。站里之前写过一篇真实压测的方法,口径可以直接搬过来用。
顺带提一个实操项:这个模型支持 prompt 缓存,命中价 $0.20,是输入价的十分之一。但缓存只认从第一个 token 开始完全一致的前缀,如果你的 prompt 把动态内容放在前面,这十分之一的价永远吃不到。改结构比砍 token 有效,具体做法在prompt caching 那篇里。
六、想自己部署,先算 1.56TB
权重格式是 MXFP4,K3 的发布版总共 1.56TB。K3.1 Pro 架构相同,仓库体积不会差太远,可以按 1.56TB 估。四比特在这里是原生精度,不是压缩后的妥协。
MoE 的特点是路由每个 token 都要选不同的专家,所以 2.8 万亿参数必须全部驻留显存,不能像稠密模型那样做部分卸载。vLLM 对 K3 给的最低配置是单节点 8 张 GB300 级 GPU,合计 2.3TB HBM3e。8 张 H200 的 1.13TB 连权重都装不下。
这就是开源和能用之间的差距。权重放出来和你跑得起来,中间隔着一整个机柜。之前那篇部署超大 MoE 的显存账算过类似的题,结论一样:除非你有稳定的高并发需求,否则 API 的每 token 价格就是你的成本下限。
七、有一个细节值得单独说:它主动砍了攻击性网络安全能力
月之暗面在发布说明里提到,这一版剔除了进攻性网络安全的训练数据,目的是让公开权重在黑客类任务上保持落后于前沿。
我认为这是今年最值得记的一个产品决策。过去开源模型的做法是能力全给,风险交给许可证和使用条款;这次是模型自己先降一档。代价很实际:安全研究、渗透测试、漏洞复现这些正当用途也会被一起削掉,用户在防御场景里会发现它不如闭源模型好使。
这条也解释了为什么 Mistral 在同一周把"防御性网络安全最强"当成卖点卖(那篇解读在这里)。两家在同一个能力维度上做了完全相反的选择,一个删一个卖。
FAQ
Kimi K3.1 Pro 和 K3 有什么区别?
架构完全一致,都是 2.8 万亿总参、104B 激活、896 专家、100 万上下文。区别在后训练:K3.1 Pro 的强化学习覆盖面扩到数百个领域,推理强度默认 max,AA 智能指数从 44 涨到 55。
权重什么时候放,能商用吗?
官方承诺 11 月 4 日前放出完整权重,具体日期可能滑动。许可证到写这篇时还没公布,K3 用的是自定义协议,建议等条款落地再规划自建。
100 万上下文是真的能用满吗?
技术上窗口是 1,048,576 token,API 也没有按长度分档计价。但长上下文的任务成本和延迟都会随长度上升,把整个代码库塞进去之前,先测一下首 token 延迟你能不能接受。
Terminal-Bench 65.7% 和第三方 67% 该信哪个?
两个都真,只是 harness 不同。官方跑在 Claude Code 环境、max 推理强度;AA 用自己的测试框架。这类基准的分数高度依赖脚手架,跨榜对比意义不大,看趋势比看绝对值靠谱。
Highspeed 版本贵一倍,值不值?
取决于你的等待成本。交互式编码、实时补全这类场景,2 到 3 倍出字速度值这个钱;离线批处理任务没必要,用标准版跑就行。
结语
K3.1 Pro 是今年开源阵营里最接近闭源头部的一次,但它证明的东西比较有限:后训练能把一个基座拉高 11 分,架构红利和后训练红利是两回事。它真正暴露的问题是定价逻辑——单价降三成、单任务不降,说明 token 计价和实际成本已经脱钩。
选型建议很明确:做软件工程、Agent 编排、3D 与设计工具链,值得排进候选;做科学计算、实验分析、需要模型讲清机制的活,暂时别指望它。
参考资料
- 月之暗面 Kimi 官方发布文 - K3.1 Pro 能力、跑分与权重时间表
- 证券时报 - 2.8 万亿参数蝉联最大开源模型,权重 11 月 4 日前发布
- Developers Digest - 定价、跑分口径与单任务成本拆解
- RunAIHome - 本地部署的显存与硬件测算
- Artificial Analysis - 独立智能指数与每任务成本
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。