
一句话总结:阿里发布 Qwen-AgentWorld 语言世界模型,提供 35B-A3B 与 397B-A17B 两种规模,一个模型覆盖 MCP、Search、Terminal、SWE、Web、OS、Android 七类环境。在 AgentWorldBench 上,397B 版的模拟质量超过 GPT-5.4、Claude Opus 4.8 和 Gemini 3.1 Pro。核心不在模型大小,在七类环境共用一套接口。
训练 Agent 最贵的东西不是模型,是环境。
你要训练一个会操作网页的 Agent,得真的开浏览器、真的点、真的等页面加载。一次操作两秒,一万次就是五个半小时。而且页面会变、网络会抖、有些操作不可逆。
训练一个会改代码的 Agent 更麻烦——你得准备几百个真实的代码库,每次改动还要能回滚。
世界模型想解决的就是这件事:用一个模型去模拟环境,随时重置,还能同时开几千个。
一、世界模型做 Agent 训练解决什么
思路不复杂。
传统做法是 Agent 在真实环境里试错,环境返回真实结果。慢、贵、不可复现。
世界模型的做法是:先训一个"环境模拟器",它学会"给定当前状态和这个动作,下一步会变成什么样"。然后 Agent 在这个模拟器里训练,不用碰真实系统。
好处有三个:
速度。 模拟器跑在 GPU 上,比真实环境快几十倍。
可复现。 同一个随机种子,跑出来完全一样。调试的时候能精确重放。
可并行。 一个模型能同时服务上千个"虚拟环境实例",训练吞吐直接拉满。
代价是模拟器有偏差。Agent 学到的策略是"在这个模拟器里最优",搬到真实环境会掉点。偏差越小,掉得越少。
所以世界模型的核心指标不是"能不能生成",是"生成得像不像"——这就是 AgentWorldBench 测的东西。
二、Qwen-AgentWorld 的 7 类环境
阿里的这套模型覆盖七类:
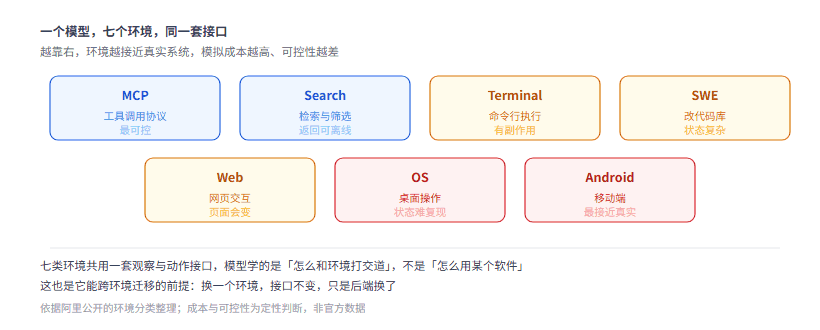
图 1:从左到右,环境越来越接近真实系统,模拟成本越高、可控性越差
MCP:工具调用协议。最简单的一类,输入参数、输出结果,没有中间状态。
Search:检索与筛选。返回的内容可以离线缓存,重放成本低。
Terminal:命令行执行。有副作用——rm 执行了就回不来了。
SWE:改代码库。状态复杂,一次改动牵扯多个文件。
Web:网页交互。页面会变,同一个按钮明天可能换个位置。
OS:桌面操作。状态难复现,窗口位置、焦点、弹窗都会影响。
Android:移动端。最接近真实用户场景,也最难模拟。
这七类排下来,正好是一条"从可控到不可控"的梯度。越靠右的环境,模拟得越像就越值钱。
三、两种规模怎么选
两个版本:
| 规模 | 总参数 | 激活参数 | 适合 |
|---|---|---|---|
| 35B-A3B | 35B | 3B | 单机部署,边训练边跑 |
| 397B-A17B | 397B | 17B | 模拟质量优先,集群部署 |
A 后面的数字是激活参数。35B-A3B 意味着每次前向只激活 3B,推理成本按 3B 算,但知识容量按 35B 算。
397B-A17B 是冲模拟质量去的——官方说这个版本在 AgentWorldBench 上超过 GPT-5.4、Claude Opus 4.8 和 Gemini 3.1 Pro。
35B-A3B 更实用。3B 的激活参数意味着单张消费级卡能跑,中小团队用得起。
四、跨环境迁移能省多少
这是我觉得最有价值的一点。
七类环境共用同一套"观察-动作"接口,意味着模型学到的不是"怎么用 Chrome",而是"怎么和环境打交道"。
差别在哪:
学具体软件:会点网页上的"提交"按钮,换个网站就不认识。
学交互模式:知道"要提交表单得先填完必填项、再找提交按钮、等响应",到哪个网站都能套。
后者能迁移。前者的知识换环境就作废。
对训练成本的影响很直接:在便宜的环境里学会的东西,能带到贵的环境里去。
比如在 Search(离线、便宜)里训练出来的"多轮验证再下结论"的习惯,可以迁移到 SWE(在线、贵)里用。省下的是最贵那部分环境的训练量。
五、统一接口怎么写
思路就是把七类环境抽象成同一个协议。核心只有三个方法。
from abc import ABC, abstractmethod

class Env(ABC):
    """所有环境实现同一个接口,Agent 侧不用关心后端是什么"""

    @abstractmethod
    def reset(self, seed: int | None = None) -> str:
        """回到初始状态,返回第一帧观察"""

    @abstractmethod
    def step(self, action: str) -> tuple[str, bool]:
        """执行一个动作,返回 (新观察, 是否结束)"""

    @abstractmethod
    def snapshot(self) -> dict:
        """当前状态快照,用于回滚和重放"""
三个具体实现,差别全在内部:
class SearchEnv(Env):
    def step(self, action):
        query = action.strip()
        hits = self.index.search(query, top_k=5)      # 离线检索
        return format_hits(hits), len(hits) == 0

class TerminalEnv(Env):
    def step(self, action):
        if "rm " in action:
            self.marked_destructive = True            # 真实环境里不可逆
        out = self.sandbox.run(action, timeout=10)
        return out, self.sandbox.exited

class SWEEnv(Env):
    def step(self, action):
        result = self.repo.apply_patch(action)        # 改代码库
        tests = self.repo.run_tests()
        return f"{result}\n{tests}", tests.all_pass
三个环境的内部逻辑完全不同,但对外都只有 reset / step / snapshot。
Agent 侧的代码一行都不用改。 这就是迁移的前提——不是靠模型学会"这个环境特殊在哪",而是靠接口把差异抹平。
六、坑清单
1. 模拟器偏差会被 Agent 学会利用。 如果模拟器的某个细节不准,Agent 会找到这个漏洞并反复利用。这不是它聪明,是奖励函数和模拟器不一致。真实环境一跑就现原形。
2. snapshot 要浅拷贝还是深拷贝。 状态复杂的环境(OS、SWE)如果只存引用,回滚时状态早被改了。必须深拷贝或者用不可变结构。
3. 不同环境的动作空间不能强行统一。 接口可以统一,但 action 的语义差别很大——Search 的动作是一条查询,Terminal 的动作是一条命令。硬用一个字符串塞进去,解析层会很难看。
4. 模拟质量要按环境分开测。 一个模型在 Search 上模拟得像,不代表在 OS 上也像。整体分数会掩盖长板短板。
5. 训练和评测要用不同的模拟器实例。 否则 Agent 会过拟合到某一个模拟器的特定偏差上。
七、边界
世界模型不能替代真实环境测试。它可以大幅减少真实测试的量,但终归要落到真机上验证。
官方公布的 AgentWorldBench 分数是自报的,超过 GPT-5.4、Claude Opus 4.8 这些对比我没办法验证。而且"模拟质量"这个指标的构成,公开信息里没有细说。
另一个要留意的是:七类环境覆盖的是"操作类"任务,不覆盖"判断类"任务。 让 Agent 判断一个方案值不值得做,这类事世界模型帮不上忙。
这类"判断 vs 执行"的分工,在验收口径那篇里拆过:能被自动化验证的环节和需要人定调的环节,处理方式完全不同。
结语
这件事的价值在于把"环境"这个成本项显性化了。
以前说训 Agent,大家想到的是模型、算力、数据。实际上卡住最多人的是环境——真实系统慢、贵、不可逆,很多团队根本跑不起来。
世界模型把环境变成可以批量制造的东西。这个方向如果成立,Agent 训练的门槛会降一个量级。
漏洞研究那篇讲过 AI 在哪些环节比人快,靠的是量和耐性。世界模型恰好把这两样放大了。
参考资料
- 每周 AI 新动态 - Qwen-AgentWorld 两种规模与七类环境
- Agentic AI News 2026-11-03 - 模型发布与评测信息
- Qwen 官方仓库 - 模型与代码
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。