
一句话总结:Qwen Code 仓库里出现了 qwen4-max、qwen4-coder-plus、qwen4-omni-120b 三个命名。阿里管理层同时否认了"转纯 API"的传闻,重申 Qwen 4.0 和 5.0 仍会开源。三个名字里藏着产品分层,而 omni 那个带 120b 后缀,说明规格可能已经锁死了。
代码仓库泄露这事,在模型厂商身上发生过很多次。多数时候泄露的是配置项、路由规则,价值不大。
这次不一样。Qwen Code 仓库里出现的三个名字,直接把 Qwen4 的产品线画出来了。
一、Qwen4 泄露了什么:三个名字,三种定位
抓到的是这三个:
qwen4-maxqwen4-coder-plusqwen4-omni-120b
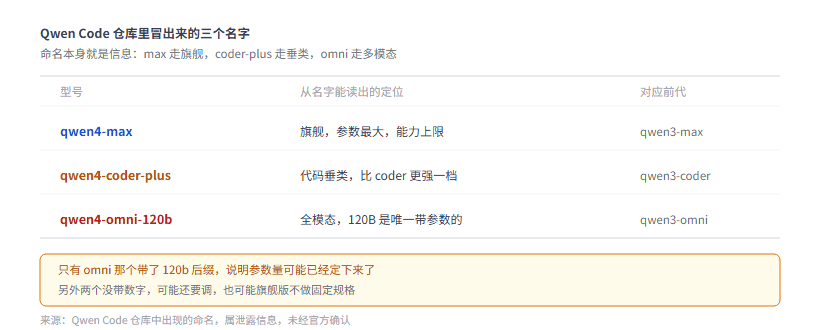
图 1:命名规则本身就是产品分层,max 走旗舰,coder-plus 走垂类,omni 走全模态
命名规则很清楚,和前代能一一对上。
max 一直是 Qwen 的旗舰线,参数最大、能力上限最高。coder 是代码垂类,-plus 这个后缀在 Qwen 体系里通常意味着"比基础版更强一档"。omni 是全模态,输入输出都能处理多种形式。
三个型号,三条完全不同的路线。 不是同一个模型的大小杯,是三种不同的产品。
二、Qwen 的开源承诺为什么值得单独说
比泄露本身更重要的,是同时发生的那件事。
Qwen 管理层公开否认了"将转向纯 API 模式"的传闻,并重申未来的 Qwen 4.0 和 5.0 仍将开源。
这个表态放在今天这个时间点,分量不一样。
因为开源与否,是这个行业最明显的分界线。闭源的可以靠模型能力收溢价,开源的只能靠服务和配套赚钱。一家公司如果从开源转向闭源,说明它判断"能力溢价"比"用户规模"更值钱。
Qwen 的公开数字是:累计开源超过 470 款模型,全球下载量突破 40 亿,衍生模型超过 33 万。这套体系是靠开源堆起来的,转闭源等于自毁地基。
所以"继续开源"这个承诺,与其说是姿态,不如说是路径依赖。
三、从 Qwen4 的命名能推断出三件事
我按命名的细节往下推,这三条是我的判断,都可能错。
第一,omni 的规格可能已经定了。 三个名字里只有它带参数量后缀 120b。通常产品在规格锁定之后才会把数字写进代号,还在调的版本一般不带。
第二,max 的规格可能还没定。 没带数字,说明参数量可能还在试,或者旗舰版本来就不打算标固定规格——毕竟 MoE 架构下"总参数"这个数字的意义越来越弱。
第三,coder-plus 这个命名是新的。 前代只有 qwen3-coder,没有 plus 档。加了 plus,说明他们想做代码模型的高端版本,可能是更大参数,也可能是专攻某类任务(比如长程重构)。
乌镇那篇讲过 Qwen4 和腾讯 Hy4 同台的事,当时只知道有 Qwen4,不知道具体型号。现在这条补上了。
四、和 GLM 5.2、gpt-oss 一起看开源节奏
这一周开源模型出得很密。
智谱 GLM 5.2:7440 亿总参数、400 亿激活,原生支持 100 万 token 上下文,MIT 协议允许企业完全私有化部署。提供 BF16、FP8、Q4_K_M、UD-IQ2 四档量化。
OpenAI gpt-oss 系列:gpt-oss-20b 和 gpt-oss-120b,是 2019 年 GPT-2 之后首次开源。120b 版本性能与 o4-mini 相当,单张 H100 可跑;20b 版本 16GB 内存就够,支持手机部署。Apache 2.0。
加上 Qwen4 的预告,三家在同一个月开源或承诺开源。
这个密度不正常。我猜的动因有两个:一是推理成本下降让"开源不亏"变得成立,二是开源能拿到部署侧的默认位置——企业一旦把你的权重跑起来,后面就很难换。
循环架构那篇算过参数效率的另一种解法:不堆参数,改深度。开源模型现在同时在两个方向上卷——更大的总参数,和更巧的架构。
五、Qwen4 什么时候能见到
没有官方时间表。
按 Qwen 过去的节奏,代码库出现命名到正式发布通常隔几周到两个月。前代 Qwen3 系列从泄露到发布大概一个多月。
值得盯的信号是:官方有没有开始放 benchmark 预热,以及 HuggingFace 上有没有出现占位仓库。这两个动作出现,基本就是一周内的事。
六、常见问题
Qwen4 是开源还是闭源?
官方承诺 Qwen 4.0 和 5.0 仍会开源。但"开源"的范围要看具体条款,旗舰版可能有商用限制。
omni-120b 的 120b 是总参数还是激活参数?
从命名习惯看更像总参数,但没有官方说明。MoE 架构下这两个数字差别很大。
coder-plus 和 max 哪个强?
定位不同。max 是通用旗舰,coder-plus 是代码垂类。写代码 coder-plus 可能更好,做别的事 max 更强。
什么时候能用到?
没有官方时间。代码库泄露只说明准备工作在做,不代表马上发。
会出更小的版本吗?
Qwen 一直有 0.5B 到 7B 的小模型线,Qwen4 大概也会补上。但这次的泄露里没看到。
结语
一条泄露消息,能读出的东西比想象中多。
三个名字告诉我产品分层定了,一个数字后缀告诉我规格锁了,一句"继续开源"告诉我商业模式没变。
这些都不算新闻,但拼起来能让人对接下来两个月有个预期。等官方真发了,回来对一对,就知道这次的推断准不准。
参考资料
- Agentic AI News 2026-11-03 - Qwen Code 仓库泄露与开源承诺声明
- 每周 AI 新动态 - GLM 5.2 与 gpt-oss 系列开源信息
- Qwen 官方仓库 - 模型发布与代码更新
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。