
一句话总结:MiniMax M3.1 Flash 报 200+ TPS 的推理速度,Kimi K3.1 Pro 报 3 万亿参数,星火 X2.6 报 41.9% 的端侧智能体覆盖率。三个数字单位不同、维度不同,放在一起比没有意义——但它们恰好指向三条互相排斥的路线:拼吞吐、拼规模、拼渗透。
这几天国产模型密集发新闻,我注意到三个数字。
它们没法比较——一个是每秒生成多少 token,一个是参数量,一个是覆盖率。但放在一起看,能看出三家在往不同方向使劲。
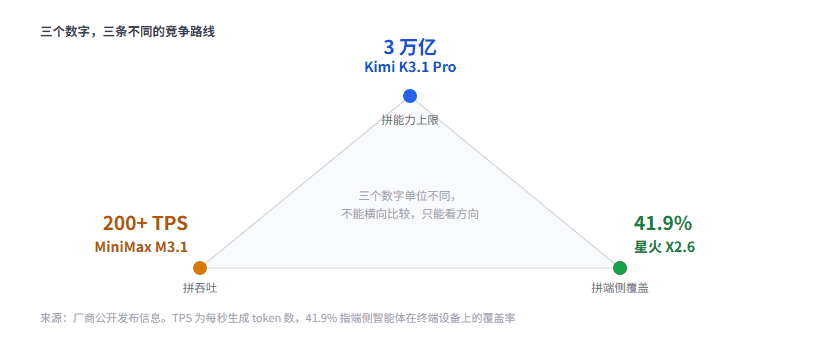
图 1:单位不同不能横比,但方向能看出差别
一、MiniMax M3.1 的 200 TPS:速度这条路
TPS 是 tokens per second,每秒生成多少 token。
200 TPS 意味着什么?人阅读速度大概每秒 5 到 10 个汉字,200 TPS 是四十倍的差距。在实际体验里,这个速度已经快到"你还没读完它就写完了"。
这条路的逻辑很直接:推理快,单位时间能服务更多请求,成本就摊得薄。
M3.1 Flash 定位就是"Flash"——轻量、快速、便宜。前面那篇算过量化和压缩,428B 的模型被社区压到 93GB,说明这个系列的开放权重也在往"能跑起来"的方向做。
速度战的代价是能力上限。一个 200 TPS 的模型,很难同时是能力最强的模型——速度快通常意味着参数少、层数浅、或者做了激进的稀疏化。
这条路的赢家是"调用量大"的场景:客服、批量处理、实时对话。
二、Kimi 的 3 万亿:规模这条路
3 万亿参数,这个数字放在全球范围也是顶格。
参考一下对比:腾讯混元 Hy4 是 770B,那篇算过它 4bit 量化后要 385GB。3 万亿是它的四倍,光权重就要 1.5TB 以上。
这条路的逻辑是:参数多,知识容量大,复杂推理的上限高。
代价有两层:
部署门槛。 1.5TB 权重的模型,只有大机构能自己跑。普通用户只能走 API。
速度。 参数越多,单次前向越慢。3 万亿的模型不可能跑到 200 TPS。
有个细节要注意:3 万亿是总参数还是激活参数? 如果是 MoE,激活参数可能只有几百亿,实际推理速度没那么慢。公开信息里没写清楚,这一条我标存疑。
这条路的赢家是"难度高"的场景:长程编码、复杂分析、需要深度推理的任务。
三、星火的 41.9%:端侧这条路
41.9% 是端侧智能体的覆盖率——指的是在终端设备上能跑智能体的比例。
这条路的逻辑和前两条完全不同:不拼云端能力,拼"能不能装到用户手边"。
端侧的好处很实在:
没有网络延迟。 本地推理,响应是毫秒级。
数据不出设备。 隐私敏感的场景必须这样。
不付 API 费用。 一次部署,无限次用。
代价是模型必须足够小。端侧设备的内存和算力有限,能跑的模型规模大概是几 B 到十几 B。这个规模在能力上没法和大模型比。
这条路的赢家是"随时在线"的场景:输入法、语音助手、本地文档处理。
四、Kimi 和星火能不能同时走
不能。这三条路在技术上是互相排斥的。
堆参数必然拖慢推理。 3 万亿的模型跑到 200 TPS,需要极其夸张的算力配置,成本上不成立。
端侧必然砍规模。 手机能跑 10B 已经很难,3 万亿连想都别想。
追求吞吐必然牺牲能力。 想快就得小,小就弱。
所以真实的产品策略是分层:用大模型做"能力标杆"和"复杂任务",用小模型做"日常调用"和"端侧"。
混元就是这么做的——Hy4 是 770B 的旗舰,同时宣布 Hy4 flash 即将发布,主打"大幅降低任务成本"。一个品牌,两个极端。
五、端侧覆盖对开发者意味着什么
41.9% 这个数字,对做应用的人有直接影响。
如果接近一半的设备能在本地跑智能体,那应用的架构可以变:
以前:所有推理请求都发到云端,等 500 毫秒到 2 秒。
以后:简单任务本地做,复杂任务才上云。
这会改变产品设计。比如:
- 输入法的联想、纠错、改写,全部本地做,零延迟
- 会议记录先本地转写,需要总结时才上云
- 图片搜索先在本地做粗筛,精细识别才走网络
"什么时候用云、什么时候用端"会变成一个新的设计维度。 现在大部分产品还没开始考虑这件事。
六、常见问题
这三个数字能直接比吗?
不能。TPS 是速度,参数量是规模,覆盖率是渗透率,三个维度。
200 TPS 是实测还是理论值?
厂商自报,通常是理想条件下的峰值。实际使用会受上下文长度、并发数影响。
3 万亿参数是总参数还是激活参数?
公开信息没写清楚。如果是 MoE,激活参数会小很多。这一条存疑。
41.9% 的分母是什么?
官方没细说,可能是"支持端侧智能体的设备占全部设备的比例",也可能是"激活用户中的比例"。得看完整报告。
对普通用户有影响吗?
有。速度提升直接改善体验,端侧覆盖意味着离线也能用。
结语
三个数字,三种活法。
我个人更关注第三个——端侧覆盖。因为前两条路(更快、更大)是线性进步,第三条(从云到端)是结构变化。
结构变化一旦发生,上一代的产品设计逻辑就会失效。
参考资料
- 中财网:Super-agent 架构突破 - 三家国产模型的数字与定位
- 搜狐:今日 AI 行业热点速览 - 国产模型发布汇总
- MiniMax 官方 - M3.1 Flash 规格
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。