
一句话总结:MiniMax M3.1 Flash 的 428B 开放权重,被社区开发者在 10 天内从 252.4GB 压到 93GB,官方点名致谢。按体积反推,每权重从 5.07 bit 降到 1.87 bit,比标准的 Q2 量化还低。这个数字用普通标量量化做不到,得靠模型本身对量化友好。
MiniMax 前两天做了件挺少见的事。
社区开发者把 M3.1 Flash 的开放权重从 252.4GB 压到了 93GB,用了 10 天。MiniMax 官方公开致谢,还点了名。
模型厂商给社区改模型的成果发致谢,这不常见。多数时候官方对社区量化是默认态度——不反对,也不表态。
一、先反推一下量化位宽
体积和参数量的关系是确定的,可以反推。
428B 参数,252.4GB 文件。一个权重占几位?
PARAMS = 428e9

def bpw(size_gb):
    """bits per weight:一个权重占几位"""
    return size_gb * (1024 ** 3) * 8 / PARAMS

print(f"压缩前:{bpw(252.4):.2f} bit")   # 5.07
print(f"压缩后:{bpw(93.0):.2f} bit")    # 1.87
算出来是 5.07 bit → 1.87 bit,压了 2.71 倍。
这个换算假设文件里全是权重。实际还有量化表、元数据、tokenizer 之类的开销,所以真实位宽会比这个数略低一点点。差不太多,量级是对的。
二、1.87 bit 的位宽是什么概念
对照一下常见档位就明白了。
| 档位 | 位宽 | 428B 对应体积 |
|---|---|---|
| FP16 | 16 bit | 797 GB |
| FP8 | 8 bit | 399 GB |
| Q5_K_M | 5.69 bit | 284 GB |
| Q4_K_M | 4.85 bit | 242 GB |
| 压缩前 | 5.07 bit | 252 GB |
| Q3_K_M | 3.91 bit | 195 GB |
| Q2_K | 2.63 bit | 131 GB |
| 压缩后 | 1.87 bit | 93 GB |
看表格末尾两行。
Q2_K 是 2.63 bit,已经是常规量化的下限了。 再往下,模型基本会崩——输出重复、逻辑断裂、长句跑飞。
社区这次做到了 1.87 bit,比 Q2_K 还低 0.76 bit,体积再砍 29%。
这个位置,靠普通的标量量化(把每个权重从 FP16 映射到 2 bit 整数)是做不出来的。
三、MiniMax 为什么能压到这么低
我的判断有三条,都是推测,官方没说明具体方法。
第一,模型本身用了量化感知训练(QAT)。 素材里提到 M3.1 Flash 采用量化感知训练。这类模型在训练阶段就模拟了量化误差,权重分布天然更适合低比特。这是最关键的一条——同样压到 1.87 bit,普通模型会崩,QAT 模型能撑住。
第二,混合精度。 不是所有层都压到 1.87 bit。通常是注意力层、embedding 层保留高精度,中间的 FFN 层压得很低。平均下来是 1.87,实际分布是先高后低。
第三,稀疏注意力。 M3.1 Flash 用的是稀疏注意力,一部分权重本来就参与得少,压狠一点也不影响输出。
三条叠加,才让 1.87 bit 这个数字成立。
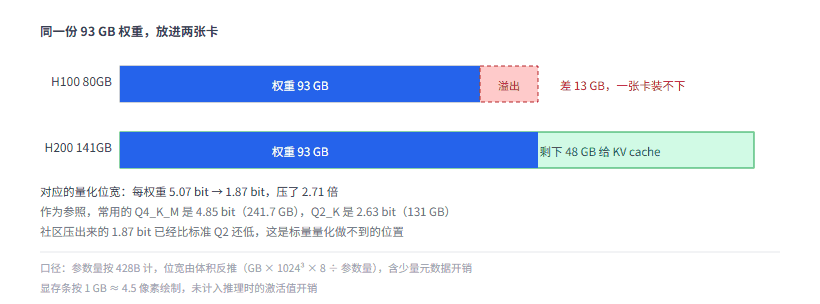
图 1:同一份权重,H100 差 13GB 装不下,H200 装得下还剩 48GB 给 KV cache
四、93GB 的显存能装进什么卡
压缩的意义全在能不能跑起来。
| 显卡 | 显存 | 结果 |
|---|---|---|
| RTX 4090 | 24 GB | 差 69 GB |
| A100 80G | 80 GB | 差 13 GB |
| H100 80G | 80 GB | 差 13 GB |
| H200 | 141 GB | 装得下,剩 48 GB |
| 双 H100 | 160 GB | 装得下,剩 67 GB |
93GB 这个数字卡得很微妙——刚好超过单张 80GB 卡。
从 252GB 压到 93GB,把"必须四卡"变成了"两卡就行"或者"单张 H200 就行"。硬件成本直接砍一半。
这也是社区为什么愿意花 10 天做这件事:省下来的钱比时间值钱。
剩下的 48GB 给 KV cache。M3.1 Flash 标称支持 100 万 token 上下文,27B 那篇算过 262K 上下文要 48GB KV——100 万 token 的话,48GB 撑不满。所以实际部署时上下文还是得截短。
五、压缩的代价在哪
必须说清楚:1.87 bit 一定有损失,问题只是损失多少。
常规经验是,Q4 基本无损,Q3 轻微下降,Q2 明显下降。1.87 bit 比 Q2 还低,理论上不应该无损。
官方致谢说明认可这个成果,但那不等于"和原版一样好"。社区压缩通常会给出一组 benchmark 对比,这次的具体数字我没看到。
如果你要拿它跑关键任务,建议自己测一遍再上。 特别是多步推理、长上下文、代码生成这三类,对量化误差最敏感。
六、常见问题
93GB 的模型能商用吗?
取决于原始权重许可。M3.1 Flash 是开放权重,压缩版沿用原许可。
为什么社区要做这件事?
因为官方给的是 252GB,普通人跑不起来。压到 93GB 之后,两张 H100 或者一张 H200 就能部署。
1.87 bit 会不会影响能力?
会,多少的问题。这种程度的量化通常在某些任务上掉点明显,另一些任务几乎无感。得自己测。
我能自己复现吗?
要 10 天和相当多的算力。作者是团队作业,不是单人一晚上能完成的。
还有更低的吗?
理论上还能往下,但 1.87 bit 已经在常规方法的下限之外了,再低要换思路。
结语
这件事有意思的地方不在"压缩比多大"。
在于模型交付的形态在变。过去厂商发一个权重文件就完事,用户自己想办法跑。现在社区会把它改成能落地的样子,厂商还会公开认可。
这等于说:发布权重只是开始,能不能被跑起来是另一半。
显存那篇算过另一种解法——改架构省显存。这次是改精度省显存。两条路子会同时存在,选哪个看你的场景。
参考资料
- Agentic AI News 2026-11-03 - MiniMax M3.1 Flash 社区压缩与官方致谢
- MiniMax 官方 - 模型发布与许可信息
- llama.cpp 量化文档 - Q2_K、Q4_K_M 等档位的定义
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。