
一句话总结:买卡这件事,这件事有顺序:显存,带宽,算力。8GB 只够跑 7B 的 Q4,12 到 16GB 落在 14B 上,24GB 才轮到 32B,48GB 以上才谈得上 70B。带宽决定解码速度的上限,而这正是日常体感最敏感的那一项。
每隔几天就有读者问:想在自己机器上跑大模型,买哪张卡。 我一般反问他准备跑多大的模型、上下文多长。答不上来的人,通常也是被商家文案带偏的人。这篇按显存分四档讲清楚,每档能跑什么、别指望什么。
先把算法摆出来,免得后面全靠感觉。显存占用分三笔账:权重、KV 缓存、框架开销,我在12GB 那篇里已经算过一遍。这四个档位都按 Q4 量化、8K 上下文、留 1GB 开销来估。
前两档:8GB 与 12 到 16GB,差的是余量
8GB:只够 7B 的 Q4
7B 走 Q4 是 5.5GB 的量级,8GB 卡放得下,还能余出 2GB。这个余量刚好够一点上下文,别贪。
剩下的余量别拿去拉长上下文。7B 拉到 32K 光缓存就要 4GB,直接爆。 这一档定位是试水。能跑通、能对话、能做点简单的代码补全,但不适合当工作主力。14B 的 Q4 要 9GB 出头,8GB 卡别想了。
如果你只是想试试本地模型什么手感,这一档够用,花最少的钱先把流程跑通。
12 到 16GB:分界线在 14B
14B 走 Q4 是 9.3GB 的量级,12GB 卡跑得动,缓冲不足 3GB。
缓冲小有两个后果。一是上下文一拉长就吃紧,二是同时开别的程序容易抢显存。所以 12GB 跑 14B,得把上下文压到 8K 以内,别开太长的对话历史。
16GB 就从容多了,同一套配置下还剩 6GB 以上,可以拉到 32K 上下文,或者把批处理开大一点。 这也是我建议大多数人起步的位置:能跑 14B 的 Q4 且有余量,进可攻退可守。
后两档:24GB 与 48GB,差的是一个数量级
24GB:32B 的入场券
32B 走 Q4 是 19GB 的量级,24GB 卡能收下,余 5GB。 这一档跨过了一道门槛。32B 在指令跟随、长文总结、代码理解上的表现,比 14B 明显强一截,很多原来只能靠云端完成的任务,本地就够用了。
但别拿它跑 32K 以上的上下文。32B 通常是 64 层,缓存涨得比 14B 快,32K 要 8GB 缓存,加上权重直接 24GB 打满,一点不剩。
要长上下文,往下一档走。
48GB 以上:才谈得上 70B
70B 走 Q4 是 38.5GB 的量级,48GB 起才收得住。
48GB 装得下,还能拉到 16K 上下文。80GB 就更宽松,可以上更大的批处理或者跑高精度量化。
这一档的成本不止翻倍。而且通常伴随机箱、电源、散热的整机改造。个人用户慎入。 有个折中方案值得提:混合专家模型。同样是三十多 B 总量,激活只有一小部分,Q4 权重十几 GB,24GB 卡就够,速度还接近大模型。近半年本地部署的热度大半来自这里。
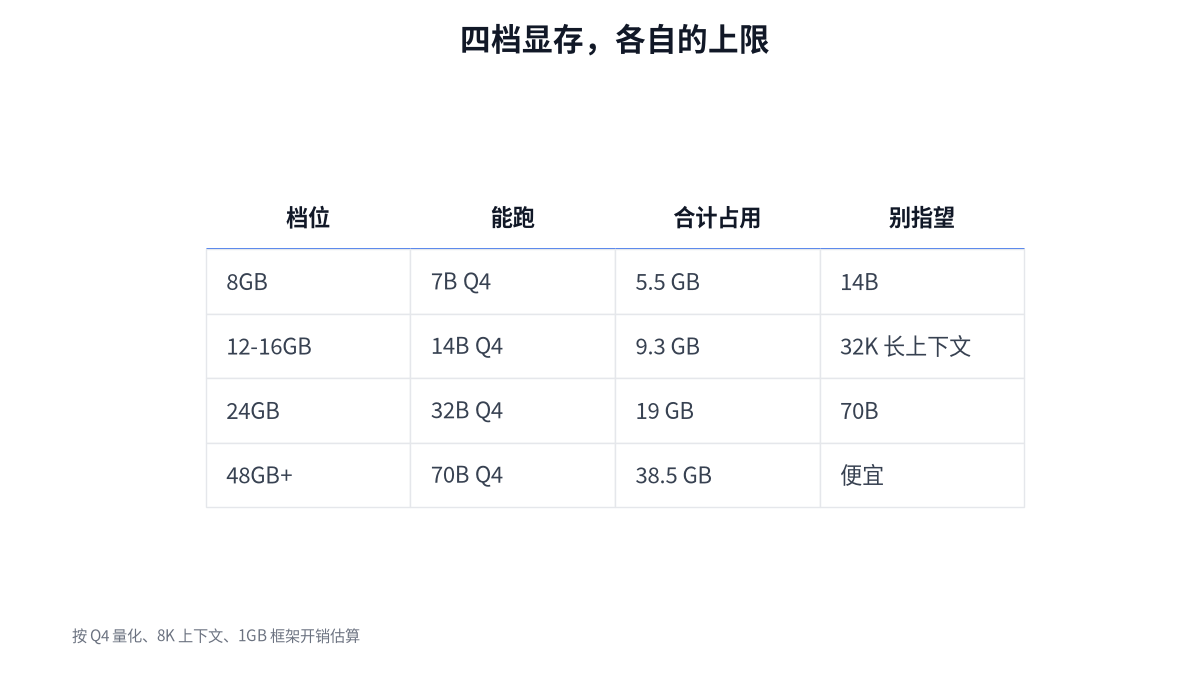
图 1:每一档都按同一条线算,条件变一个结论就要重算
带宽:比显存更容易被忽略的那个数
显存决定能不能跑,带宽决定跑多快。解码时每生成一个 token,要把参与计算的权重读一遍,所以速度上限约等于带宽除以每 token 字节数。
拿 32B 的 Q4 举例:每 token 要读约 16GB 权重,带宽 900GB/s 的卡理论 55 tok/s,带宽 500GB/s 的卡只有 30 tok/s。同样 24GB 显存,体感能差一倍。
所以「显存一样大」不代表「一样好用」。买卡时这两个数都要看,优先选带宽高的。这条判断标准比看核心数量有用得多,推理优化那篇整篇都在讲同一件事。
顺带说统一内存的机器:显存和内存共用,能装下很大的模型,但带宽是内存级别的,解码速度通常比同价位独显低一截。它们适合「装得下就行」的场景,不适合追速度。
别踩的三个坑
第一个坑是买低显存高算力的卡。商家宣传的算力数字对训练有意义,对推理意义有限;推理瓶颈在带宽,不在峰值算力。花高价买一张显存不够的卡,最后发现模型加载不了,只能退回更小的模型。
第二个坑是把「内存够大」当兜底。内存跑大模型确实可行,但速度要算:35GB 权重按 80GB/s 内存带宽读一遍要 0.44 秒,两个多 tok/s。能读不能聊。
第三个坑是忽视机箱和电源。高端卡的功耗和长度都不小,买回来装不进机箱、或者电源带不动,这类翻车我见过不止一次。买之前先量一下机箱内部长度。
自己算:一段二十行的估算脚本
与其记结论,不如记住算法。下面这段只用标准库,把模型参数填进去就能算出你这张卡够不够。我平时就是先跑它,再去翻购物车。
def need_gb(params_b, bits=4, layers=32, kv_heads=8, head_dim=128,
            ctx=8192, overhead=1.0, kv_bytes=2):
    w = params_b * bits / 8              # 权重
    kv = 2 * layers * kv_heads * head_dim * kv_bytes * ctx / 1e9
    return round(w + kv + overhead, 2)

for name, p, L in [("7B", 7, 32), ("14B", 14, 40),
                   ("32B", 32, 64), ("70B", 70, 80)]:
    print(name, need_gb(p, layers=L), "GB")
输出分别是 5.5、9.3、19.0、38.5。换模型改三个参数,换上下文改 ctx,换量化改 bits。
卡之外还有一笔账。高端卡的功耗和长度都在变大,换卡常常连带换电源、换机箱,甚至换整套散热。这些钱不进「显卡预算」,却实实在在要花。
动手前量三个数:机箱内部可用长度、电源额定功率、机箱进风余量。三个里有一个不够,你买回来的卡就只能躺在盒子里。
还有一条省钱路线:先在云端租两周,把「多大模型够用」跑明白。租是按小时算,试错成本比买错一张卡低得多。
一张表看完四档
把上面四档压成一句一句:8GB 跑 7B Q4,试水用;12 到 16GB 跑 14B Q4,起步首选;24GB 跑 32B Q4,跨门槛;48GB 以上跑 70B Q4,个人慎重。
每一档都要在同一条线上看:上下文压到 8K、量化 Q4、留一成余量。三个条件变一个,结论就得重算。 最后一句劝退:如果你还没确定要跑哪个模型,先别买卡。租一台云机器跑两周,把「多大模型够用」这个问题答完,再回来选硬件,能省掉一大笔试错钱。
FAQ
Q:24GB 能跑 70B 吗?
Q4 不行,权重就 35GB。降到 2bit 也许能塞进内存跑,但速度是内存带宽级别的,而且质量掉得厉害。
Q:同显存不同型号差在哪?
主要在带宽和散热。带宽高的那张,解码速度可能快一倍,日常体感差别很大。
Q:二手卡值不值?
显存和带宽的规格是确定的,这点没有风险。风险在矿卡磨损和保修,这个我没法替你判断。
参考资料
- Hugging Face 文档 · KV cache(缓存占用与上下文长度的关系)
- GitHub · llama.cpp(量化位宽与内存占用的实际换算)
口径与核验:四个档位的合计值按「Q4 每参 0.5 字节 + 8K 上下文 + 1GB 框架开销」推的,层数分别按 7B 32 层、14B 40 层、32B 64 层、70B 80 层估,KV 头统一按 8 个。这些是我设定的假设,不同模型的实际层数和头数会变,换模型请重算。带宽 900GB/s 和 500GB/s 是举例用的区间值。文中没有给价格和具体型号推荐,因为这两样变化快,写死了反而误导。
- 8GB:只够 7B 的 Q4
- 12 到 16GB:分界线在 14B
- 24GB:32B 的入场券
- 48GB 以上:才谈得上 70B
- 别踩的三个坑
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。