
一句话总结:英文版 71,721 星,中文版 23,450 星,两个仓库相差一天创建。它们做的事情高度一致:把「读起来像 AI 写的」拆成 26 种可指认的句式,一条一条改。最有意思的是它自己写的边界:它不负责骗过检测器,检测器照样能标出它改过的文本。
这段时间我在给自己写稿的流程里加了一道检查。查着查着发现,我用的那份中文润色 skill 和它的英文原版,在 GitHub 上已经是两个庞然大物。
站里此前写过推理提速那套「先算上限」的方法,这里用的是同一种顺序:先定标准,再动手。
英文原版叫 humanizer,1 月 18 日创建,核到 71,721 星、5,611 fork、仅 3 个待处理 issue,MIT,仓库 276KB。
中文版是 op7418/Humanizer-zh,1 月 19 日创建,23,450 星、1,441 fork、35 个 issue,仓库只有 27KB。
两个数加起来九万五。这个量级通常属于框架和工具链,一个「改文风」的提示词包能到这个位置,说明需求有多普遍。
它的根据不是玄学,是维基百科的一份编辑指南
humanizer 在 README 里直接写明自己建立在维基百科的 Signs of AI writing 上。那是维基编辑者用来识别 AI 稿件的指南,不是营销材料。
指南里有一句话被它引作原理:模型总是选最可能出现的下一个词,于是默认选那个能适配最多读者和最多主题的表达;人则为某一个读者、某一个主题做选择。
这句话解释了很多现象。为什么 AI 稿子读起来「对但空」——它要为所有读者都成立,所以不敢具体。为什么它爱总结、爱升华——升华是最安全的收尾。
humanizer 的 26 个模式,基本都是这个默认选择的副产品:一句不增加事实、只负责提示重要性的话;节奏靠规则而不是靠内容起伏;普通事实被写成转折点。
26 种模式,前五种见一次就改
README 把模式编号排列,从最强最常见到最弱。前五种看到一次就动手:
一、先否定再抬高的句式(模型最爱用「这不只是 X,而是 Y」)。典型句:「这不只是一个功能,而是一次协作方式的改变」。改法就一句:直接说结论。
二、单句收尾和戏剧化短段。每节末尾来一句「这才是真正的价值」,或者「没有前作,没有怀旧」。改法是删掉重复的那句,把碎片并进具体陈述。
三、听起来很有道理的格言。比如「说到底,重要的是……」或者「对称是信任的语言」。改法是把格言替换成具体主张。
四、进正题前的铺垫。比如「让我们深入看看」「说实话?要看情况」「最难的部分是……」。改法是删掉铺垫,直接说。
五、跟不存在的对手辩论。比如「这不是主要关于……」「一种诱人的做法是……」。改法是删掉没人提出的反对意见和假选项。
这几条我逐条对照过自己以前写的东西。第五条我犯得最多:为了显得周延,先立一个靶子再打掉它。
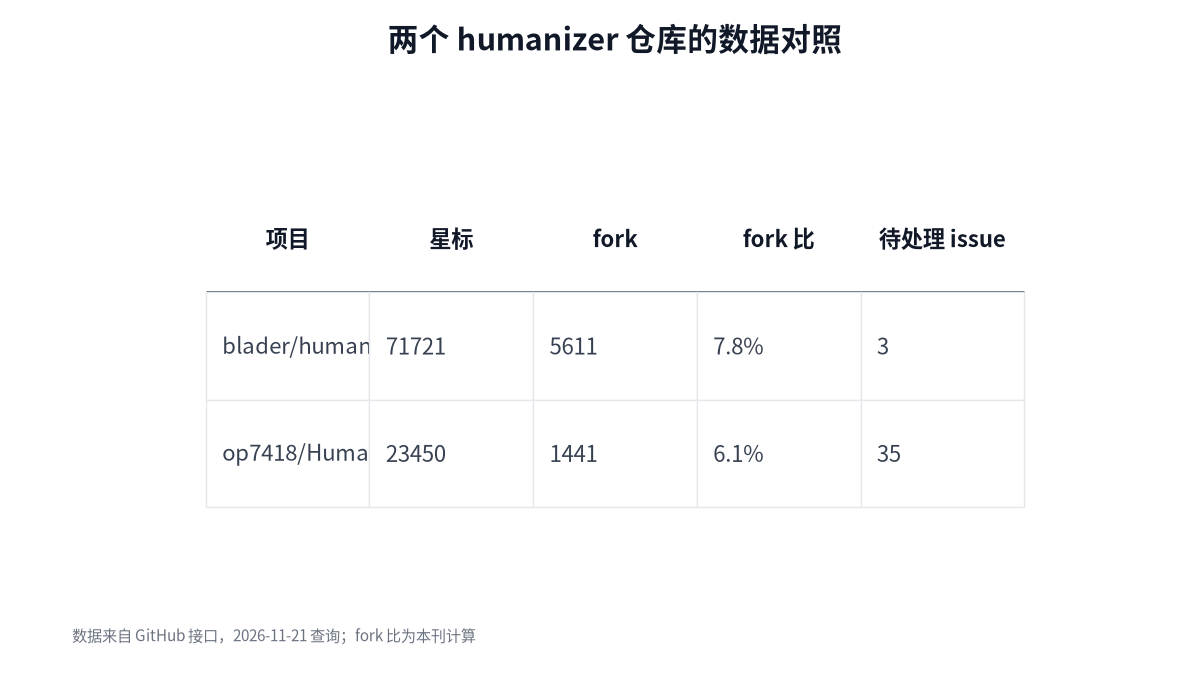
图 1:星标差了约三倍,fork 比却接近;中文版的待处理 issue 多得多
后半段是节奏问题,不是词问题
第六到第十一条归在「按规则生成的节奏」下:强行三段并列、句首反复、破折号当万能连接符、限定词叠加、到处加连字符、被动语态缺主语。 这一组比前一组难改,因为它们单独看都不是毛病。三个并列有什么错?破折号有什么错? README 的处理方式是给它们打标:标了 weak alone 的,只有在同一段里还出现别的信号时才动手。理由写得很清楚——认真的写作者可能故意这么用。
中文版在 2026 年 9 月 23 日的更新里做了同一件事:重写规则和示例,明确「普通的排比、破折号和连接词不再一律修改」。 这条演进值得注意。早期版本大概是把这些当硬指标,改得过了头;后来收回来,承认弱信号需要组合才成立。
我这边的实测:质检脚本扣的分正好命中它的模式
我给站里写的发布流程有一道质检脚本,会按固定项扣分。对上号之后我才发现,扣分项基本是从这张模式表抄的。 最近一次跑分,「不是……而是……」出现超过 1 次,扣 5 分。这就是模式 1。 另一篇被扣 3 分,原因是文末又用「核验方式:」开头。质检把这种写法叫报幕式过渡,对应模式 2 和模式 4 的合体。
还有两次扣分是破折号密度——5 处扣 3 分。这对应模式 8。 最有说服力的一次是「通篇没有一处承认不确定,像通稿」。这一条不在这 26 个模式里,但精神一致:AI 稿子不敢示弱,人也该敢说「这里我没底」。
所以我现在的做法,是在写的时候就避开。改的成本远高于不写。
它自己说的三句实话
这三条我挑出来单说,是因为它们决定了这个东西能用来干什么。同类作者主动划边界的写法,Blender 那篇的「不是安全沙箱」也是一例。
第一句在开头附近:humanizer 面向人类读者改写,不试图骗过 AI 检测器,检测器仍然会标出它的大部分输出。 这句话把整件事的性质说清楚了。它做的是可读性,不是伪装。指望它「洗稿过检测」的人,方向从一开始就错了。
第二句在流程里:原文若空泛,它会补一个自己确认为真的具体细节,同时保留原文所有主张。 「确认为真」是限制条件。补细节和编细节只差这一步,中文版把它写得更硬:原文缺少的证,可以向作者索取,不能用润色补出数据。
第三句在交付方式上:粘贴文本时它会展示修改过程,先给第一版改写,再列一遍「残留下来的信号」,最后才是终稿。 这个设计比直接吐终稿有用。你能看见它判断了什么、漏了什么,而不是只能接受或拒绝。
有个盲测数字,我持保留态度
README 提到一次盲测:评委在 16 次比对里 16 次更喜欢 humanizer 的改写版本,链接指向 issue #229。
16 比 16 听起来很有力,但样本是 16 次,不是 16 组独立评委的大样本;而且「更喜欢」这个标准本身偏主观。 我倾向于这样看:这个结果说明改写方向是对的,不说明它稳定优于人工编辑。真要评估,得看具体文本类型——技术文档和社媒文案的最优改法完全不同。
顺带一个可以算的数:中文版 23,450 星、1,441 fork,fork 比 6.1%;英文版 71,721 星、5,611 fork,fork 比 7.8%。两个都远低于「拿下来改代码」那类工具,符合提示词包的使用方式——装完就用,很少有人改。
怎么用,以及别指望它做什么
Claude Code 里两条命令:先加插件市场,再装 humanizer;版本要求 2.1.142 以上,低了就用 npx skills add 的方式装。中文版更简单,一条 npx skills add 加仓库地址,或者把文件夹拷进 skills 目录。
用法有两种:贴一段文本让它改,或者给一个文件路径让它只改正文,代码、数据、链接目标不动。 它还支持给样本对声音。你把两三段自己写的东西贴进去,它会照着样本的节奏、用词、标点甚至习惯性破折号来改。这条对长期写作的人有用,比通用规则更贴。
别指望的两件事:一是过检测器,作者自己说了不行;二是补事实,它只保留和重组原文的主张。数据缺就是缺,得回去找源。
FAQ
Q:中文版和英文版是什么关系?
中文版不是逐句翻译。它重写了规则和示例,2026-09-23 那次更新还放宽了排比、破折号和连接词的处理,思路同源但规则独立。
Q:装上就会自动生效吗?
不会。它是 skill,要你显式调用,或者用自然语言明确要求它改写。不调用就不起作用。
Q:改完还需要人看吗?
要。它会展示「残留信号」,说明还有没处理干净的地方;技术准确性也只能由人核。
参考资料
- GitHub · blader/humanizer(MIT,含 26 种模式表与盲测说明)
- GitHub · op7418/Humanizer-zh(中文版,含 2026-09-23 更新记录)
- Wikipedia · Signs of AI writing(模式表的方法来源)
数从哪来、哪些是推的:两组星标与 fork 数来自 GitHub 接口,查询于 2026-11-21;26 个模式的编号、前五种的具体改法、weak alone 的处理规则、16 比 16 的盲测,均引自两份 README。扣分项的对应关系是我对着自己脚本的规则逐条比出来的,属个人经验。fork 比 6.1% 和 7.8% 是我用 fork 数除以星标数算的。盲测样本量的问题是我自己的保留意见,不是作者的说明。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。