
一句话总结:显存不是只看权重。一张 12GB 的卡,7B 的 Q4 模型放得进还有余量,14B 刚好卡在边上,32B 和 70B 怎么量化都装不下。真正的分界线是权重加 KV 缓存再加框架开销这三笔账,而第三笔常被忘掉。
「12GB 显存能跑 70B 吗」这个问题在评论区见过太多次,答案经常被简化成一句「量化到 2bit 就行」。 我不这么看,但也理解为什么有人这么答:只算权重的话,70B 的 2bit 确实不到 18GB,看着像有戏。问题在于另外两笔账。
这篇把三笔账摊开算一遍,全部写清假设,你可以把参数换成自己的模型重算。
第一笔:权重,只看量化位数
权重的算法最简单:参数量乘以每个参数占的字节数。fp16 是 2 字节,8bit 是 1 字节,4bit 是 0.5 字节,3bit 约 0.4 字节。
所以 7B 的 Q4 是 3.5GB,14B 是 7GB,32B 是 16GB,70B 是 35GB。 到这里已经能排除两个:32B 和 70B 的 Q4 都超过 12GB。想把 32B 塞进去,得降到 2bit 左右,而 2bit 的掉点不是能忽略的量级。
这一步的常见误解是把「模型大小」当成「显存需求」。两个数不是一回事,后者永远更大。
第二笔:KV 缓存,跟上下文长度成正比
每生成一个 token,模型要把之前所有 token 的键值对留着。这部分叫 KV 缓存,大小跟上下文长度线性相关。 单 token 的占用可以这样估:2 乘以层数,乘以 KV 头数,乘以头维度,乘以字节数。前面那个 2 是键和值各一份。
拿一个常见的 7B 配置算:32 层、8 个 KV 头(GQA)、头维度 128、fp16。每个 token 约 128KB,8K 上下文就是 1GB。
如果不用 GQA,KV 头数和注意力头数一样多,这部分要乘四倍:每个 token 512KB,8K 就是 4GB。这就是为什么现在的模型几乎都上 GQA,省下来的正是这块。
上下文一长,这笔账会翻脸。同样一个 7B,跑到 32K 就需要 4GB 缓存,加上 3.5GB 权重,12GB 卡只剩不到 5GB 给框架和批处理。
第三笔:框架开销,最容易被忘掉的
这部分没有精确公式,只能给经验区间:推理框架自己、CUDA 上下文、激活值、批处理预留,加起来通常 1GB 到 2GB。
我见过有人算出「权重加缓存刚好 11.8GB,12GB 够用」,然后加载时就爆了。差的就是这一笔。
所以实践经验是留一成余量:12GB 的卡按 10.5GB 到 11GB 规划,别按 12GB 算。
四个模型放一起看
把三笔账合起来,按 Q4 量化、8K 上下文、GQA 8 个 KV 头、开销 1GB 的假设算一遍: 7B 是 3.5 加 1.0 加 1.0,合计 5.5GB,12GB 卡装得下,还剩一半给更长上下文或更大批处理。
14B 是 7 加 1.25 加 1,合计 9.25GB,装得下,但余量只剩不到 3GB,上下文再拉长就危险。 32B 是 16 加 2 加 1,合计 19GB,超了。70B 是 35 加 2.5 加 1,38.5GB,超得更多。
所以 12GB 卡的实际边界在 14B 的 Q4 附近。想跑 32B,得换 24GB 的卡;想跑 70B 的 Q4,得 48GB 左右。
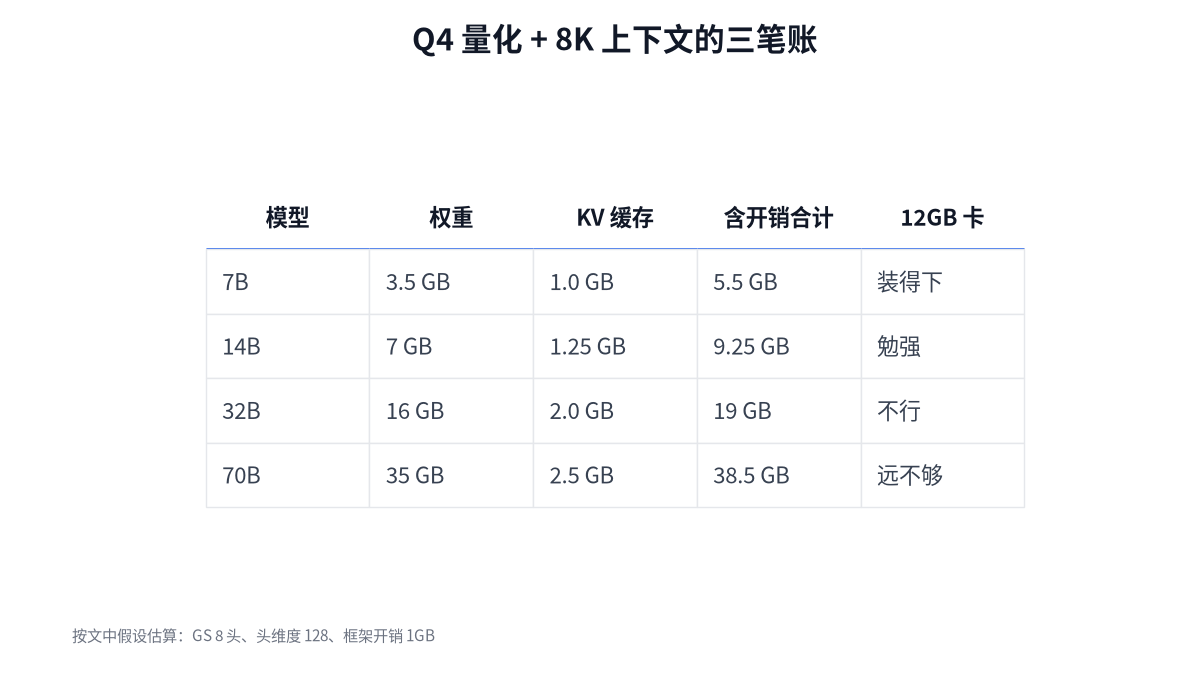
图 1:分界线落在 14B 附近,32B 起再怎么省也不够
「那用内存凑」这个说法怎么算
到这里会有人接一句:显存不够可以放内存,CPU 也能算。 技术上成立,但速度要算。解码时每生成一个 token,要把参与计算的权重读一遍。70B 的 Q4 是 35GB,双通道内存的实际带宽按 80GB/s 估,光读一遍就要 0.44 秒。
折算下来两个多 tok/s,还没算 CPU 算力和调度开销。这个速度能读,不能聊。 但有一条例外值得说:混合专家模型。它的权重总量大,每个 token 只激活一小部分。同样是 35B 总量、3B 激活的模型,Q4 权重 17.5GB 放内存里,每个 token 只读约 1.5GB,按 80GB/s 就是 50 tok/s 的理论上限。
实际上会低不少,调度和内存抖动都在吃时间。但这解释了一个现象:为什么最近几个月「内存跑大模型」又变得可行了,因为大家跑的是 MoE。
这个 50 tok/s 是我按带宽除出来的天花板,不是实测值。真实数字要看具体引擎和机器。推理优化那篇讲的就是怎么把实测值往天花板推。
三句话版本
如果只记三句:权重看量化位数,缓存看上下文长度,开销按一到两 GB 留。 再补一句判断方法:看到「某卡能跑某模型」的说法,先问他上下文开多长、量化多少位、留了多少余量。三样缺一样,这个结论就没法复现。
这也是写 MCP 客户端那篇里提过的同一件事:把假设写下来,别人才可能算出跟你一样的数。
我没算准的部分
三个地方要坦白。第一,KV 缓存我按 8 个 KV 头算的,不同模型的头数差别很大,头数翻倍这笔账就翻倍。 第二,框架开销给了 1GB 的假设值,实际可能到 2GB 甚至更多,取决于批处理和是否开了前缀缓存。
第三,所有数字都是算出来的,我没有在同一天用同一台 12GB 机器把四个模型逐个加载验证。想拿去做采购决策的话,务必先自己加载一次实测。
倒是有一个可以立刻自检的办法:把模型加载起来,看显存占用减去权重大小,剩下的部分再除以每 token 缓存大小,就能倒推出你的实际上下文上限。这比任何公式都准。
FAQ
Q:12GB 卡跑 14B 稳吗?
Q4 加 8K 上下文大致 9GB 出头,能跑。上下文拉到 32K 就悬了,要降量化或减长度。
Q:Q2 能不能救 32B?
权重约 9GB,理论上塞得进。但 2bit 的质量损失明显,而且留给缓存和开销的空间很小。
Q:为什么同样参数量,有的模型吃显存更多?
层数、KV 头数、注意力实现都会影响。层数多的模型缓存涨得快,这是最容易忽略的变量。
参考资料
- Hugging Face 文档 · KV cache(键值缓存的定义与实现)
- GitHub · llama.cpp(量化位宽与内存占用的实际换算参考)
- vLLM 文档(显存分配与分页缓存的说明)
算法与口径:权重等于参数量乘每参数字节,4bit 取 0.5 字节;KV 单 token 等于 2 乘层数乘 KV 头数乘头维度乘 2 字节;框架开销取 1GB。四个模型分别按 32、40、64、80 层估算,头维度统一 128,KV 头统一 8 个。这些是我设定的假设,不是各模型的出厂参数,换模型请按实际配置重算。80GB/s 是双通道内存的保守估值。文中所有结论都是算术推出来的,未做同机实测。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。