
一句话总结:内链不是「每篇随手加两条」,而是三张不同的网——串联、枢纽、跨分类导流;本文拿自己的站做样本,把 129 篇的出链结构统计出来,发现问题不在数量,在没有设计,然后给一套可执行的检查方法和主题簇方案。
写了一百多篇之后我才认真看内链这件事,原因很简单:Google Search Console 里看到一堆页面「已抓取,未编入索引」。
排查下来不是内容问题,是这些页面在站内没人指向它。搜索引擎爬虫靠链接发现页面,一个没有任何入链的页面,等于放在孤岛上。
于是我把自己站的数据拉出来看了一遍,结果挺难看。
先量一下:自家站的真实数据
| 分类 | 篇数 | 占比 |
|---|---|---|
| AI资讯 | 57 | 44.2% |
| 编程开发 | 34 | 26.4% |
| 品牌优化 | 15 | 11.6% |
| 软件工具 | 12 | 9.3% |
| 逆向工程 | 11 | 8.5% |
| 合计 | 129 |
再看最近 9 篇的出链数:
| 篇目 | 站内出链 | 站外引用 |
|---|---|---|
| Clover 深度解读 | 2 | 5 |
| 扩散语言模型谱系 | 2 | 5 |
| AA 指数 v5 | 2 | 4 |
| AI 基建账本 | 2 | 5 |
| Clover 部署 | 2 | 4 |
| 模型压测 | 2 | 1 |
| Agent 可观测性 | 2 | 0 |
| Nemotron 语音 | 2 | 3 |
| 逆向路线图 | 9 | 1 |
前八篇整齐划一的「2」,第九篇突然变成 9。
这个对比把问题说清楚了:我一直在执行一条「每篇至少两条内链」的达标线,而没有在做链接结构。 2 条刚好够串起前后两篇,形不成网。
唯一跳出这个数的是那篇路线图,因为它的写法决定了它必须链九篇。这恰好说明了枢纽页的价值。
内链其实有三种,作用完全不同
第一种:串联。 系列文章的前后指向。「上一篇讲数学,这一篇讲执行」。作用是让读者连续阅读,也把权重沿系列传递。
这种链接的问题是只在一条线上,第一篇文章永远拿不到后面的权重。
第二种:枢纽。 一个汇总页指向该主题下的所有文章。作用是给分散的页面一个共同的入链来源。
逆向入门路线图就是这种:九个环节各链一篇,同时每篇都在开头链回路线图,形成一个双向的簇。
第三种:跨分类导流。 一篇文章指向另一个分类的文章,理由是有实质关联。
比如讲 Clover 部署时提到显存怎么估,链到自建 MoE 那篇。作用是把权重从一个分类导向另一个,也是分类占比失衡时唯一能纠正的手段。
三种里,串联我一直在做,枢纽只做了一次,跨分类导流是碰运气。顺带说一句,外链也有类似的分寸问题,AI 搜索引用那篇讲的是内容被引用的逻辑,跟这里讲的「谁指向谁」是一套思路的两种应用。
每篇 2 条为什么不够
算个简单的账。129 篇、平均 2 条出链,全站约 258 条链接。听起来不少,但摊到每篇的入链只有 2 条。
搜索引擎判断一个页面的重要性,入链数量和质量都是信号。全站平均 2 条入链,意味着没有任何页面显得比别的更重要,站点结构是平的。
平坦结构有两个后果:
一是新页面很难被发现。新发的文章只有发布时那一两条入链,如果那两条来自低权重页面,抓取优先级就很低。
二是分类失衡自我强化。AI资讯占 44%,篇数多,被链的机会也多,权重越来越集中;逆向工程占 8.5%,越没人链越沉底。
主题簇:一次解决两个问题
改法不是「每篇多加几条链」,那样会变成乱撒。有效的是做成主题簇:一个枢纽页 + 5 到 9 篇环绕文章,簇内互链,簇外通过枢纽导流。
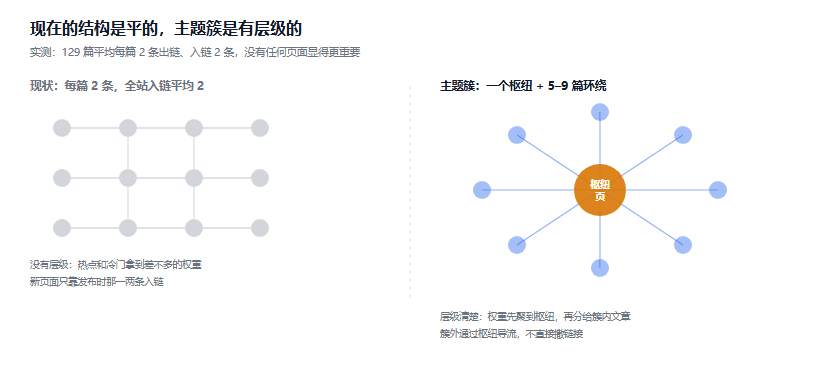
图 1:左边是现状(每篇 2 条,无层级),右边是主题簇(一个枢纽 + N 篇环绕)
一个簇长这样:
        枢纽页(汇总/路线图)
       ↓    ↓    ↓    ↓
     文章A 文章B 文章C 文章D
       └────┴────┴────┘
簇内互相引用 2-3 次三个规则:
枢纽只联本簇,不联全站。 一个页面链 30 篇,权重被摊薄到没有意义。控制在 12 篇以内。
每篇环绕文章都要链回枢纽。 位置放在开头或结尾,用「这套东西的整体路径见」这类自然表述,别在正文中间硬插。
簇内互链要克制。 文章 A 链 B 和 C 就够,不用把兄弟全链一遍。互链过多会被判断为链接农场。
现在已经有一个雏形:逆向那条线九篇 + 路线图。AI资讯和编程开发也应该各做一两个枢纽,而不是只有零星串联。
锚文本:描述用途,不堆关键词
我踩过的坑是在锚文本里硬塞关键词,写出来像这样:「点击了解大模型推理性能优化」。读者看着别扭,搜索引擎也认得出这是优化痕迹。
现在用的规则是三条:
用目标页里真实存在的概念。 目标页讲的是显存估算,锚文本就写「显存账怎么估」,不要写「大模型部署优化方案」。
同一目标页的锚文本要有变化。 全站二十处都写一样的词,是明显的操作痕迹。同一个页面被链时,按上下文换说法。
别用「点击这里」「详情」。 这种锚文本对读者和爬虫都没有信息量。
一个反例自查表:
| 别写 | 改写成 |
|---|---|
| 点击这里 | 显存估算的方法 |
| 详情 | 那套压测流程 |
| 了解更多 | 备案期能做的十一项 |
| 相关文章 | 逆向那条线的完整路径 |
一个能跑的审计
内链靠眼看是看不出来的,得统计。下面这段用站点的 MCP 接口拉数据,算每篇的出链和入链:
# audit_links.py —— 需要站点提供 get_article / list_articles 接口
import re, sys
from collections import defaultdict, Counter

LINK = re.compile(r"zhaixingw\.cn/(ai-news|coding|SEO|reverse|tools)/(\d+)\.html")

def audit(ids, get_article):
    out = {}                      # id -> 出链数
    inn = defaultdict(set)        # id -> 谁链了我
    for aid in ids:
        content = get_article(aid).get("content", "")
        hits = LINK.findall(content)
        out[aid] = len(hits)
        for _, target in hits:
            if target != str(aid):     # 排除自链
                inn[target].add(str(aid))

    orphans = [i for i in ids if not inn.get(i)]
    print("总出链:", sum(out.values()))
    print("平均出链: %.1f" % (sum(out.values()) / len(ids)))
    print("零入链页面:", len(orphans), orphans[:20])
    print("零出链页面:", [i for i, n in out.items() if n == 0][:20])

    top = sorted(inn.items(), key=lambda kv: -len(kv[1]))[:10]
    print("入链最多的页面:", [(i, len(s)) for i, s in top])
    return out, inn, orphans
四个输出各自对应一个问题:
- 平均出链低于 2 → 站点结构是平的,需要补枢纽
- 零入链页面超过 10% → 有一批页面爬虫可能根本发现不了
- 零出链页面 → 这些页面在消耗权重但不贡献
- 入链 Top10 过于集中 → 权重分配畸形,通常是分类失衡的镜像
注意限制:这个脚本要逐篇拉正文,篇数多会很慢(我这次跑 129 篇直接超时,只能抽样最近九篇)。篇数上百时建议分页拉、加本地缓存,或者直接从数据库导一次正文。
五个坑,按命中率排
坑 1:把「每篇 2 条」当成结构。 这只是最低限度,不是设计。达标不等于有效。
坑 2:所有文章都链向热门那几篇。 结果热门更热、冷门更冷,长尾页面永远起不来。要有意识地把链接引向新文章和新分类。
坑 3:枢纽页链太多。 一个页面挂 30 个链接,每个分到的权重极小,而且读者也看不完。控制在一屏能扫完的量。
坑 4:锚文本全站统一。 同一个目标页二十处写法一模一样,是操作痕迹。按上下文换说法。
坑 5:发完就不回头。 内链是存量工作。新发十篇就要回头看看,能不能给老文章补一两条指向新文章的链接。我这次审计发现的「一直 2 条」,就是从不回头的后果。
边界
这篇讲的是结构,不是内容质量。内链能让好内容被看见,但救不了差内容——一篇没人看的文章,加了十条内链还是没人看。
另外中文站的搜索引擎生态和英文站差别不小,我这套判断基于自己站的实际情况(129 篇、收录状态受备案影响),换到别的站要重新量一遍。先审计,再改,别照搬比例。
我的下一步很清楚:给编程开发和 AI资讯各做一个枢纽页,把现有 91 篇按主题切成四到五个簇,然后每季度跑一次审计脚本。这件事的价值不在这一周的量,在一年后的结构。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。