
一句话总结:Nature 报道指出,被学界质疑几十年的旧论文很多没被正式撤稿,而 AI 搜索的摘要功能会把这些内容包装成可直接引用的结论。我做了一次自查:最近九篇的 26 条引用里,只有 4 条能点进去核到具体内容。
先说我自己的结果,因为这个比讲道理有用。
我把最近九篇文章的"参考资料"段抓出来,一条条看:26 条引用,按域名判断 21 条指向权威机构,占 80.8%。但如果看链接能不能点进去核到那句话——只有 4 条,占 15.4%。剩下 22 条都是首页或栏目页。
也就是说,我写的"参考资料:Nature"点进去是 Nature 首页,读者找不到我说那篇报道在哪。
Nature 那篇报道讲了什么
报道的核心是一个被忽视的盲区:旧文献的撤稿滞后。
具体表现是:几十年前发表、已经被学界质疑的研究,因为原始数据丢失、作者去世、期刊停办、证据标准变化,一直没走完正式撤稿流程。传统撤稿机制到 2000 年代才标准化,早期期刊的处理方式不规范,很多"质疑"只停留在编辑注记或者圈内共识。
后果是这些论文还留在 Scopus、Web of Science 这些主流数据库里,标着正常状态。做文献综述的人会引用它,AI 训练和检索系统也会把它当正常文献。
报道举的例子包括古生物学争议、心理学历史论文、以及一些有现实危害的替代医学文献。
撤稿滞后:引用链上的三个断点
我把这篇报道的逻辑拆成三层,因为它说的是一个系统性失效。
第一层,标记缺失。 论文被质疑但没有正式撤稿标记。数据库里它和正常论文长得一样,检索的时候分不出来。
第二层,跨库不同步。 即使某个期刊在自己的网站上加了警告,这个信息未必同步到 Scopus、WoS 这些索引库。查文献的人用索引库,看不到期刊站上的注记。
第三层,AI 摘要抹掉了不确定。 这是新出现的一层。AI 搜索给出的是"结论式摘要",它会把论文里的主张提取出来,用肯定的语气复述。原文里那些"我们的发现可能表明""样本量有限"的限定语,在摘要里经常消失。
三层叠起来的结果是:一篇 1980 年代被质疑的论文,可能在 2026 年以"研究表明"的形式出现在某个 AI 回答里,引用链上没有任何一处标红。
这比"收录了错误内容"更麻烦。收录错误内容,读者还有机会自己判断;把错误内容重新表述成权威结论,判断的机会就没了。
AI 搜索为什么放大这件事
三个原因。
第一,摘要默认省略出处。 AI 回答通常给结论不给链接,或者给一个概括性的"据研究显示"。用户拿到的是一句可以直接引用的话,但没有回溯的入口。
第二,措辞的确定性被抬高。 学术写作里"可能""提示""在这个样本中"这些限定词是必要的严谨,摘要为了可读性会把它们去掉。去掉之后,一个相关性研究读起来像因果结论。
第三,检索排序偏好"被引用得多"的内容。 一篇老论文如果被引用了上千次,在检索里权重很高。但"被引用得多"和"结论可靠"是两件事——早期的高引用可能正是因为没人质疑过。
这三点合起来,形成一个反向激励:越老的、越被广泛引用的、越可能有问题而不自知的论文,越容易成为 AI 回答的依据。
我没找到"AI 摘要里有多少比例来自已撤稿文献"的测量,这个数字应该有团队去做,但我手上没有。这是本文最大的空白。
我做了一次自查:26 条引用只有 4 条能核
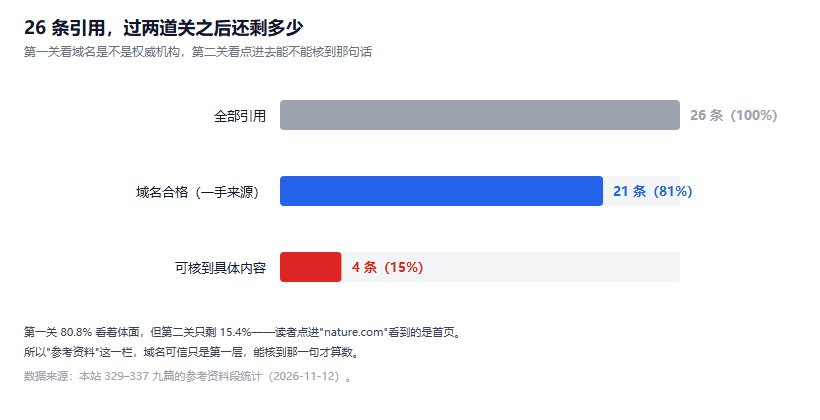
图 1:域名合格不等于可核,第二道关只有 15.4% 通过
回到开头那组数字。
# 统计最近九篇的参考资料
# 判定 1:域名是否属于一手来源(期刊、官方文档、监管机构)
# 判定 2:链接是否指向具体文档(路径深度 ≥ 2)
import re
from urllib.parse import urlparse

deep = shallow = 0
for link in all_links:                     # 26 条
    path = [x for x in urlparse(link).path.split("/") if x]
    if len(path) <= 1:
        shallow += 1                       # 首页或栏目页
    else:
        deep += 1                          # 具体文档

print(f"指向首页/栏目 {shallow} 条,指向具体文档 {deep} 条")
print(f"可核到具体内容 {deep/(deep+shallow):.1%}")
输出:
指向首页/栏目 22 条,指向具体文档 4 条
可核到具体内容 15.4%这两个数字放在一起,说明一件事:我的引用在"域名可信"这一层是合格的,在"可核对"这一层是不合格的。
为什么会出现这种情况?因为写的时候我常常知道"这个信息来自 Nature 的某篇报道",但没保存具体链接,事后补一个 nature.com 交差。这不是造假,但它让"参考资料"变成了装饰——看起来很严谨,实际上读者一条都核不了。
按 Nature 那篇报道的逻辑,我这 22 条首页链接,比没有引用更糟。没有引用,读者知道要自己找;有引用但核不到,读者会以为已经核过了。
四步核对法
从这次自查开始,我给自己定了四步,写每篇都过一遍。
第一步,链接要到文档级。 能打开看到那句话,而不是看到机构首页。做不到就写"未找到原始出处",别拿首页充数。
第二步,区分一手和转述。 论文本身、官方文档、监管文件是一手;媒体报道是转述。用转述的时候标清楚"据某媒体报道",不要让读者以为我看过原始文件。
第三步,核对数字的原始口径。 同一个数字在不同报道里可能有不同算法。比如"成本降 62.7%"是相对行业平均,不是相对上一代。这个差别要写明,之前专门写过数字口径这件事。
第四步,标出不确定。 哪些是我自己算的、哪些是引用别人的、哪些没验证。三者混在一起,读者没法判断可信度。
这四步听起来是常识,做起来很费时间——尤其第一步,找文档级链接经常要翻十几分钟。但这正是可信度的成本所在。比这更省事的做法是在文末加一句「本文由 AI 生成」,但那种声明交代的是工具,不是责任,读者拿不到任何可核的东西。
对内容站的意义:可信度是攒出来的
Nature 那篇报道说的虽然是学术出版,但对内容站是一样的道理。
第一,AI 时代的内容竞争,不在产量在可核性。 生成一篇文章的成本已经接近零,读者要的是能验证的东西。谁能提供可核的链接、可复现的算式、可对照的原始数据,谁就有立足点。
第二,错误会被放大,但要很久之后才被发信。 一篇写错了的文章,可能两年后才有人指出。这期间它一直在被引用、被 AI 摘要、被当成依据。所以发布前的核对,比发布后的更正重要得多。
第三,透明本身就是壁垒。 我把自己 26 条引用只有 4 条能核这件事写出来,看起来是自曝其短。但读者看到这个,会知道我下次说"这条我核过了"是有分量的。
反过来,那些每篇都写"参考资料:XX 官网"的站,读者慢慢会学会忽略那一栏。当所有人都能轻易写出"参考资料"四个字时,这四个字就不值钱了。
最后说一句实在的:我这四步自己也做不到每篇都完美。这九篇里就有 22 条首页链接没改。下一步是把它们逐条换成文档级链接——这是个体力活,但没有替代方案。
参考资料
- AI 搜索加剧旧论文撤稿滞后风险:Nature,Dyani Lewis,2026-11-11
- 撤稿观察数据库:Retraction Watch
- COPE 撤稿指南:出版伦理委员会
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。