
一句话总结:K2.8 Preview 是月之暗面 9 月 11 日上线的编程模型,官方说能力接近 K3,但思考效率更高、全会员档位都能用。它接的是 K3 看不上的日常活。
K3 很强,但贵。
强到什么程度?2.8 万亿参数,一套完整的推理链跑下来,普通开发者一个月工资就没了。这就带来一个很现实的问题:日常写代码、补全、改 bug,真需要每次动用 2.8 万亿参数吗?
K2.8 Preview 就是回答这个问题的。
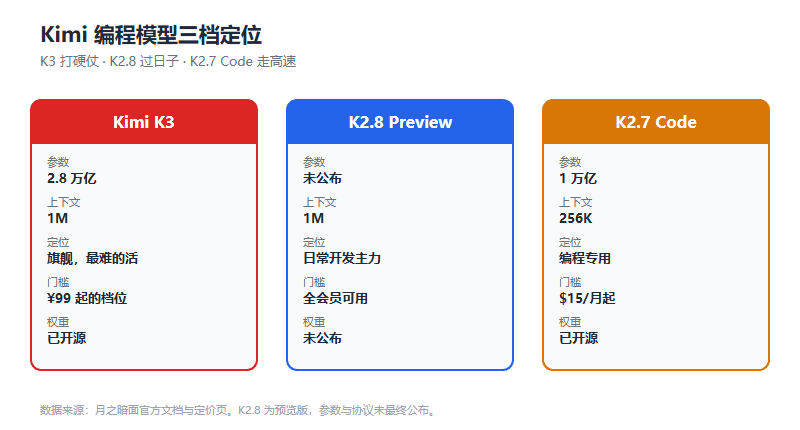
图 1:K3 打硬仗,K2.8 过日子,K2.7 走高速
它把自己放在哪个位置
官方的说法很直接:性能接近 K3,思考更高效。
翻译成人话就是:它不跟你抢最难的活,但日常开发够用了。
有个细节能说明定位。K2.8 的 Model ID 直接沿用 Kimi-for-coding,没有换新名字。这意味着已经在用 Kimi Code 的人,升级是零改动,客户端和第三方工具都不用动配置。
这种"原地升级"的做法挺聪明。少一次迁移,就少一批用户流失。
规格
| 项目 | 参数 |
|---|---|
| 上下文 | 1M(1,048,576) |
| 输入模态 | 文本、图片、视频 |
| 输出 | 文本 |
| 思考档位 | low / high / max 三档 |
| 默认档位 | high |
| API 价格 | $1.00 输入 / $4.00 输出(每百万 Token) |
| 开源状态 | 未公布权重 |
| 发布时间 | 2026 年 9 月 11 日 |
三档思考强度是它比 K3 更灵活的地方。K3 刚上线只有 max 一档,简单任务也得跑满推理链。K2.8 可以按任务调:补全用 low,改 bug 用 high,重构用 max。
这个设计能省不少 token。
一个不太被提到的差异:行为更可控
这条我是从用户反馈里看到的,官方文档没写那么细。
K3 在模糊任务里比较"主动"。你给的需求不明确,它可能自作主张补一堆你没要的东西。而且它对历史 thinking 内容很敏感,多轮对话里一旦前面的推理跑偏,后面会跟着偏。
K2.8 定位日常开发,行为边界稳定得多。说白了就是:更听话,不折腾。
做代码补全这种高频交互,这一点比能力上限更重要。补全要的是"猜得准、不出戏",不是"想得深"。
价格这件事
K2.8 走的是订阅制,包含在各档会员里,从免费档 Adagio 开始就能用。
对比 K3:K3 需要 ¥99 起的档位才能调。K2.8 直接把门槛拉平了。
API 那边是 $1.00 / $4.00 每百万 token。跟 K2.7 Code 的 $0.95 / $4.00 基本持平,但上下文从 256K 涨到 1M,等于同样的钱能塞四倍的代码。
如果你的活是"把整个仓库读一遍然后回答问题",这个差别很实际。
三个短板
它是预览版。正式版什么时候出、会不会变,官方没说。生产环境别拿它当主力,这是官方自己的建议,不是我说的。
不支持结构化输出。JSON schema 这类功能它没有。做 Agent 编排、需要严格格式返回的场景,得绕路。
能力上限还是不如 K3。官方说"接近",没说"等同"。真遇到硬骨头,该换还是得换。
和 K2.7 Code 怎么选
这个问题现在有点尴尬,因为两者价格接近。
我的看法是看上下文需求。需要 1M 窗口就读整个仓库,选 K2.8。只需要 256K、更在意稳定性,K2.7 Code 是经过验证的正式版,反而更靠谱。
K2.7 还有个 HighSpeed 变体,输出 180-260 tokens/s,比标准版快五六倍。如果你做的是实时补全,速度比上下文重要,那个更合适。
怎么用
Kimi Code:kimi-for-coding 这个 ID 已经默认指向 K2.8,不用改配置。
API:platform.kimi.ai,模型 ID kimi-k2.8-preview。
注意:1M 上下文不是所有档位都开。Plus 及以上才有,低档位可能限在 256K 左右。
常被问的
预览版能上生产吗? 不建议。官方语气也很谨慎。想稳定就用 K3 或 K2.7 Code。
它开源吗? 目前没公布权重。K 系列有开源传统,K3 都开了,但 K2.8 是 preview,等正式版再看。
和 Claude Sonnet 5 比? K2.8 官方没公布 benchmark,只给了"接近 K3"这个模糊说法。Claude Sonnet 5 在 SWE-Bench Pro 上是 63.2%,OSWoRLd-Verified 81.2%。没有同口径数据,硬比没意义。
最后
K2.8 的存在说明一件事:模型厂商开始认真做分层了。
以前是"一个旗舰打天下",现在是旗舰干重活、轻量版过日子。这个分层不是为了卖更多,是因为旗舰的推理成本真的降不下来。
对开发者来说,这是好事。你不需要为一个写 CRUD 的任务付 2.8 万亿参数的价钱。
唯一要留意的是预览版的稳定性。等正式版。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。