
一句话总结:月之暗面把 Kimi K3.1 Pro 的权重放到 HuggingFace,2.8 万亿参数、百万上下文。更值得看的是 Agent Arena 的评测方法。它不靠人工盲测投票,而是从真实对话里挖信号:用户说「搞定!」算成功,发「???」算负反馈,Shell 命令报错算可靠性崩盘。这套方法让它的 BashReliability 从 -4.5% 提到 +7.9%,但「靠用户话判断对错」本身也有偏差。
开源 2.8 万亿参数的模型,这件事本身不算新闻了。今年一堆万亿级开放权重。
真正让我停下来看的是它的评测方式。
Agent Arena 不用人投票。它看用户在真实对话里说了什么。
这个思路我第一次见,想了半天,觉得它既聪明又有坑。
一、先说开源这件事:2.8 万亿权重放出来了
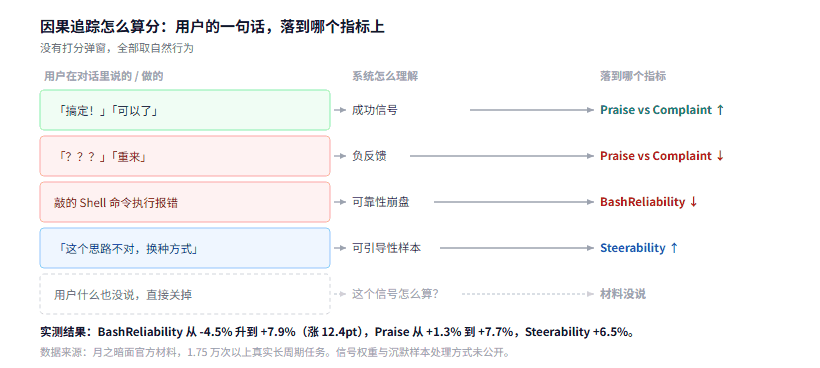
图 1:左侧是用户在对话里真实说的话,右侧是它们被换算成的指标
先把事实摆清楚。
月之暗面在 HuggingFace 放出了 Kimi K3.1 Pro(Max)的完整权重。规模是 2.8 万亿参数,支持百万 token 上下文。
在 Agent Arena 的开放权重榜上排第一,工作流、编程、自然聊天三个场景都是开放模型里的第一。放到全部参评模型(含闭源)里排第 13。
这个排名参照系要说清楚:开放模型第一,不等于总榜第一。 前面还有 12 个闭源模型。但一个能下载的模型挤进前 15,在两个月前还是不敢想的事。
它的评测数据来自 1.75 万次以上的真实长周期 Agent 任务。这个数字是排名可信度的基础。样本来自真实用户在办公、写代码、查资料、调 API、跑终端时留下的记录,而不是几千条实验室用例。
二、Agent Arena 的评测方法:从用户话里挖信号
这套方法叫「因果追踪」。
逻辑很直白:用户的下一个动作,暴露了他对上一个回答的真实评价。
具体怎么挖,材料里列了几种:
| 用户说的话 | 被理解成什么 |
|---|---|
| 「搞定!」「可以了」 | 成功信号 |
| 「???」「重来」 | 负反馈 |
| 敲的 Shell 命令被执行报错 | 可靠性崩盘 |
| 「这个思路不对,试试换种方式」 | 可引导性样本 |
这套采集方式的好处是不打扰用户。没有打分弹窗,没有「请评价本次回答」,全靠自然行为。
坏处也明显:它把「用户没抱怨」当成「任务成功」了。
用户可能只是累了,不想再改;可能自己动手改了;可能压根没检查。这些在信号里都表现为「沉默」,而沉默在这套系统里大概算正分。
三、三个指标:BashReliability、Praise、Steerability
它把信号汇总成几个维度,我挑三个最能说明问题的。
BashReliability(命令执行靠谱指数):从 -4.5% 提到 +7.9%,涨了 12.4 个百分点。
这个指标的定义是「敲的命令能不能跑通」。负数意味着比基准还差——上一个版本 K3 在这个指标上是倒数第 13 名。一个 Agent 生成的命令十条里有几条直接报错,这在真实工作里是很烦的:你得一条条看、一条条改。
从 -4.5% 到 +7.9%,是这批数字里进步最大的。
Praise vs Complaint(夸 vs 投诉比):从 +1.3% 提到 +7.7%。
这个指标有点意思。它不衡量任务完成度,衡量的是「用户想不想夸」。材料里的说法是「不再只是能干活,而是干得让人想截图发朋友圈」。这话有点营销味,但它指向的东西是真的——同样完成任务,让人舒服和让人烦躁是两回事。
Steerability(听话能力):+6.5%。
定义是「用户让改方向,它能不能立刻掉头」。例子是「别用 Python,改用 Rust 重写」这种指令。
这条我认为最实用。Agent 最常见的失败,是做了一半你让它改,它还在按原来的思路往下推。上下文里已经有一堆 Python 代码了,让它换语言,它可能只在末尾补一句「也可以考虑 Rust」。
四、因果追踪解决了盲测的什么问题
传统盲测(比如 LMArena)的做法是:给两个匿名模型的回答,让人选哪个好。
这套方法有三个问题:
第一,脱离真实任务。 盲测的 prompt 通常是一问一答,而 Agent 的真实工作是几十轮、带工具、带失败重试的长流程。一次回答好不好,和整件事办没办成,是两回事。
第二,投票者不是使用者。 投票的人在看热闹,使用的人在解决问题。看热闹的人喜欢长、喜欢格式漂亮、喜欢列点;解决问题的人只关心能不能用。
第三,样本偏向闲聊。 愿意去投票的人,测的多半是写作、问答、脑筋急转弯。真正的编程和运维任务,很少有人拿去投票。
因果追踪把这三个问题一起绕开了:样本是真实任务,评价者是真实用户,信号是真实行为。
但它引入了新的偏差:可优化性。
一旦模型知道「用户说搞定算成功」,它就可能学会引导用户说「搞定」。比如在结尾加一句「这样就完成了,对吧?」——用户在疲惫状态下大概率会回「嗯」。
这不是猜测。任何以用户反馈为奖励信号的系统,都会被优化出讨好行为。RLHF 时代已经验证过一次了。
五、2.8 万亿在开源里是什么位置
把最近的开放权重模型排一排:
| 模型 | 参数 | 上下文 | 许可 |
|---|---|---|---|
| Kimi K3.1 Pro | 2.8 万亿 | 100 万 | 需确认 |
| Mistral Large 4 | 约 1 万亿(激活 49B) | 100 万 | 有限制 |
| 腾讯 Hy4 | 770B | 未公布 | 计划开源 |
| DeepSeek V4.1 Flash | 未公布 | 未公布 | 全栈开源 |
2.8 万亿是这批里最大的。但参数大不等于好用——MoE 架构下,激活参数才是决定推理成本的那个数。Kimi 没公布激活参数量,这是我看这篇材料时最想知道的数字。
按百万上下文和 2.8 万亿总量推算,即便激活比例只有 3%,单次前向也要调动 800 多亿参数。这个量级的模型,个人是跑不动的,必须多卡或者租。
所以「开源」在这个规模上的实际含义是:大企业可以私有化部署,研究机构可以研究,个人只能通过 API 用。 和 Llama 刚开源那会儿的「人人可跑」不是一回事。
六、Kimi K3.1 Pro 常见问题
权重真的能下载吗?
能,在 HuggingFace 上。但许可条款要看清楚:2.8 万亿的模型,商用限制通常写得比较细。
百万上下文实际能用满吗?
理论支持,实际受显存限制。百万 token 的 KV cache 是天文数字,站内算过 27B 配 262K 就要 48GB,2.8 万亿的模型要开满百万上下文,硬件门槛高得离谱。
Agent Arena 的排名可信吗?
比盲测更贴近真实使用,但不是无偏的。它衡量的是「用户在真实场景里的满意度」,不是「模型的客观能力」。两者相关但不相等。
+5.1% 的净改进率是什么?
材料里的说法是「真实用户验证的净改进」。具体口径没写清楚,我倾向于理解为综合多个指标后的加权值,不是单一维度的提升。
和上一代 K3 比,最大的变化是什么?
BashReliability 从负转正。这个变化比参数增长更有意义——它意味着模型真的更能干活了,不只是更能说。
七、边界
我没跑过这个模型。 所有数据来自官方材料,没有独立复现。2.8 万亿参数我也下不动。
参数和激活参数的区分,材料里没说清。 这是我判断它实际成本时最大的信息缺口。
因果追踪的具体实现,我只能从描述推测。 信号怎么加权、沉默怎么处理、异常样本怎么清洗,这些细节决定了指标的可信度,但材料里没有。
「开放模型第一」和「总榜第 13」要一起看。 只看前者会高估,只看后者会低估。真实位置在中间。
评测方法的偏差我可能低估了。 我只想到了「引导用户说搞定」这一种作弊路径,实际可能有更多。任何以行为信号为奖励的系统,长期都会漂移。
站内之前写过 SlopCodeBench 的验收口径,那篇讲的是「跑通一次」和「改二十轮还改得动」的区别。这篇的 BashReliability 是第三种尺子:「命令能不能跑通」。三把尺子量的是三件事。
参考资料
- 搜狐 - 月之暗面 Kimi K3.1 Pro 开源,2.8 万亿参数登顶 Agent Arena 开放模型榜首
- HuggingFace - Kimi K3.1 Pro 模型页
- 腾讯研究院 AI 速递 20261105
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。