
一句话总结:月之暗面演示 Kimi 无人干预连续工作 20 小时、交付可继续开发的原生工程;同一天 SlopCodeBench 公布 36 个任务、196 个检查点的评测,无一智能体完整通过,最佳严格通过率 16.3%。两组数据看着打架,其实验收的根本不是同一件事——一个问"能不能做出来",一个问"做出来之后还留着多少余地"。
昨天同一天看到两组数字,放在一起很有意思。
一组是月之暗面放的:Kimi 在无人工干预的情况下连续工作 20 小时,复现了一个原作,产出可继续开发的原生工程。
另一组是 SlopCodeBench 的评测:36 个任务、196 个检查点,没有任何一个智能体完整通过,成绩最好的一家,严格通过率 16.3%。
一个说能连干 20 小时,一个说基本不及格。这两件事发生在同一天。
一、Kimi 那 20 小时,验收的是什么
先把事实摆清楚。
月之暗面 11 月 2 日发布游戏开发与创意工作方案,基于 Kimi K3.1 Pro、Kimi Code 和 Kimi Work,通过插件直接操作 Unity、Unreal Engine 和 Blender 里已有的工程。和团结引擎协同的那次演示里,模型连续工作 20 小时,复现原作,产出可继续开发的原生工程。
官方还给了另一个数字:没有编程经验的策划,1 到 2 天能做出可试玩原型。
这两件事的共同点是——验收标准只有一个:东西做出来了,而且能打开、能改。
注意"能改"这两个字。它是有分量的,很多演示交付的是一堆无法维护的脚本。但"能改"和"改二十轮还改得动"是两个量级的事。
二、SlopCodeBench 的 196 个检查点
另一组数据考的东西不一样。
SlopCodeBench 是一个分阶段的评测,36 个任务,196 个检查点。它不是让智能体从头写一个项目,而是让它在一个已存在的代码库上做多轮修改,然后检查改完之后代码库还健不健康。
结果:没有一个智能体完整通过,最好的严格通过率 16.3%。
"严格通过"的意思大概是——不光功能要对,结构指标也得达标。松弛一点的口径可能好看很多,它偏偏用了严格的那个。
我觉得这个评测切中了真问题。因为真实开发里,写新代码的时间占比很低,大部分时间花在读旧代码、改旧代码、以及搞清楚"这段为什么这么写"上。
三、两种验收口径的差别在哪
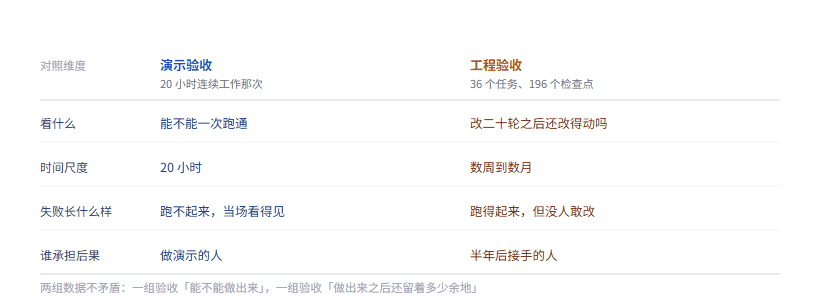
图 1:同一件事,两种问法,答案可以完全相反
差别可以拆成四条。
看什么不同。 演示验收看一次跑通,工程验收看改二十轮之后的状态。
时间尺度不同。 20 小时对 20 小时,那是冲刺;196 个检查点铺开,那是数周到数月。
失败的样子不同。 演示失败很响——跑不起来,当场就看见。工程失败很静——跑得起来,但没人敢动,每次改动都要祈祷。后者不会报错,它会慢慢积累。
谁承担后果不同。 演示的后果由做演示的人承担,工程验收的后果由半年后接手的人承担。
这四条叠加起来,就是为什么同一个系统能在一边拿满分、在另一边不及格。
四、为什么"改不动"比"跑不起来"更贵
这一点值得展开,因为它决定了你该用哪种方式验收 Agent。
跑不起来的成本是可见的:报错、卡住、重来。你能算得清,也能立刻修。
改不动的成本是隐藏的。代码能跑,测试能过,但每加一个功能都要动三处地方;每次改完都担心别的地方崩。这种状态下,团队会本能地绕开那块代码——加个 if 兜住,写个补丁盖过去。半年后没人知道原来的逻辑是什么。
过度封装那篇讲过类似的情况:一个简单的检查活被拆成六个组件,改一个需求要动两天。那不是功能问题,是结构问题。
Agent 让这件事变严重了。因为 Agent 写代码的速度比人快,它一晚上能产出你想都不敢想的量。如果这些代码的结构是坏的,债务积累的速度也跟着快十倍。
五、Agent 的验收标准该怎么定
我给三条,都从"能不能长期维护"出发。
第一,验收"改得动"而不是"跑得通"。 让 Agent 交付之后,你自己动手改一个小需求。改得顺,说明结构没坏;改了三处才生效,说明它只是在凑。
第二,给检查点,不给一句话。 SlopCodeBench 用 196 个检查点是有道理的——单个"看起来对"的判断太容易骗过。把验收拆成多个具体指标,比让评审说一句"还行"靠谱得多。决策模型接口那篇讲过类似的事:让模型输出结构化分数,比让它自由回答准确率高。
第三,把回溯成本算进去。 Agent 越自主,出错之后要往回退的距离越长。20 小时的连续工作,如果第 18 小时发现有结构问题,前 17 小时的产出都可能要重做。要么接受这个风险,要么在中途设检查点。
六、常见问题
Kimi 真的能连续工作 20 小时吗?
官方演示是这样描述的,我手上没有复现条件。这一类演示通常跑的是精心准备的任务,实际项目里的表现要以你自己的任务为准。
SlopCodeBench 的 16.3% 是不是说明 Agent 写代码不行?
不能这么推论。它考的是"多轮修改后代码库保持健康",这个标准比"能写出能跑的代码"严得多。换成后一种口径,通过率会高很多。
这两个结论我该信哪个?
都信。它们回答的是两个问题。你要做快速原型,看第一个;你要把 Agent 放进长期维护的项目,看第二个。
怎么判断我的项目属于哪种?
问一句:这份代码三个月后还要不要改。要改,用工程口径验收。
结语
我更愿意把这组数据读成一个提醒,而不是一个结论。
20 小时的演示是真的,16.3% 也是真的。但它们放在一起容易被误读成"Agent 到底行不行"——这个问题没有统一答案,得看你拿什么尺子量。
真正该警惕的是那种"演示过了就算成功"的验收习惯。它在演示阶段很省事,在维护阶段很贵。而这个代价通常不由当时验收的人承担。
参考资料
- 腾讯研究院 AI 速递 2026-11-03 - 收录 Kimi 连续工作 20 小时的演示描述
- AI 圈要闻 2026-11-03 - 含 SlopCodeBench 的 36 任务、196 检查点与 16.3% 数据
- 月之暗面 - 官方产品与发布信息
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。