
一句话总结:Kimi K3 总参数 2.8 万亿、激活 104B,稀疏比 26.9 比 1。它按 2.8 万亿的显存付钱,按 104B 的算力干活。这个错配,就是开源 3T 模型的全部生意。
11 月 20 日,月之暗面在 Hugging Face 上线 Kimi K3,完整权重公开。官方称它是「全球首个开源的 3T 级模型」。
参数摆出来是这样的:总参数 2.8 万亿,激活参数 104B,上下文 100 万 token,原生多模态,能吃文本、图像和视频。
两个数放在一起,才是这篇要算的东西。
2.8 万亿里只有 3.7% 在动
104 除以 2800,是 3.71%。换个说法:96.3% 的参数这次前向根本不动。
这个比例来自 MoE 的结构。K3 用了 Stable LatentMoE 框架,896 个专家里,每个 token 只激活 16 个,再加 2 个共享专家。
16 除以 896,是 1.79%。
两个比例不一样,因为激活参数里除了专家还有注意力和嵌入层。但方向一致:绝大部分容量是常驻不用的。
稀疏比是 26.9 比 1。官方说整体扩展效率比 Kimi K2 提升约 2.5 倍,这个倍数怎么来的,报告里没给拆解。
显存按 2.8 万亿付,算力按 104B 花
这是开源大模型最容易被忽略的一笔账。
先说显存。K3 用 MXFP4 存权重、MXFP8 存激活,属于量化感知训练。128K 上下文要多少 KV cache那篇算过另一头的账,这里先只算权重。按 4.25 bit 每参数估(4 bit 加一点缩放因子,这是我的假设),2.8 万亿参数约合 1.49TB。
对照一下:站内那篇记 K3.1 Pro 权重 1.56TB、折合每参数 4.46 bit。两个数差 4.7%,考虑到 4.25 是我拍的,这个偏差在合理范围。
再说算力。每次前向只读激活的那部分,104B 乘 4.25 bit,约 55GB。生成每个 token,搬的是 55GB,不是 1.49TB。
所以这台机器的配置会很怪:显存要装得下 1.49TB,带宽只要供得起每 token 55GB。8 张 H200 是 1.13TB,装不下权重;但装下之后,跑起来的算力开销只相当于一个 100B 级别的稠密模型。
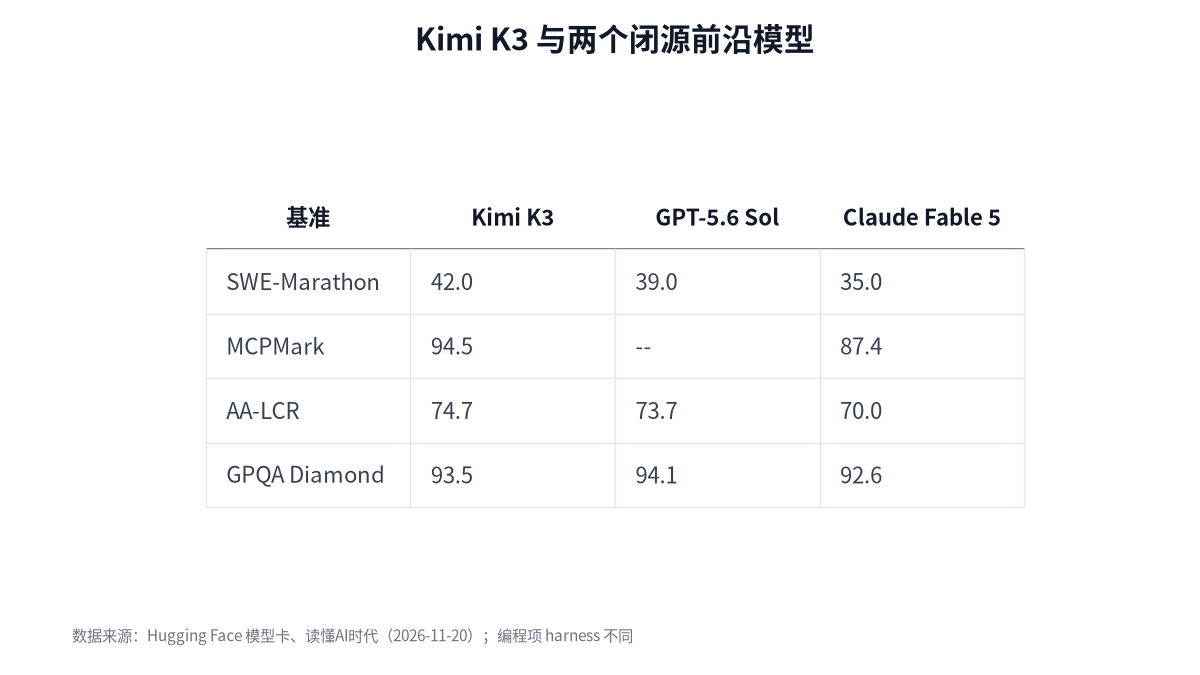
图 1:六项基准,K3 赢四项、输两项,差距都在 1 分以内或口径不同
93 层的账
结构上是 93 层,其中注意力层 69 层用 KDA(Kimi Delta Attention),24 层用 Gated MLA。隐藏维度 7168,词表 16 万。
多模态靠 MoonViT-V2,4.01 亿参数的视觉编码器。相对 2.8 万亿的总量,这个编码器只占 0.14%。
顺带交代一句:这种稀疏设计不是 K3 首创,145B 塞进 29GB 那篇记过同一条路线。
长上下文给到 100 万 token。这个数字对 KV cache 的压力,比 55GB 的权重读取大得多。上下文越长,缓存越线性膨胀。K3 没有公布 KV cache 的具体结构,所以这块我算不出来。
赢四项,输两项
官方列了一批对比。挑几个有参照的看:
| 基准 | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 |
| AA-LCR | 74.7 | 73.7 | 70.0 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 |
| MCPMark-Verified | 94.5 | — | 87.4 |
推理知识类,三家挤在 92.6 到 94.1 之间,差不到 1.5 分。长上下文 AA-LCR 拉开一点,K3 领先 4.7 分。
真正拉开的是 SWE-Marathon,42.0 对 39.0 对 35.0,测的是长程编程。这和官方宣传的「在大型代码库中导航、调度终端工具」对得上。
MCPMark-Verified 差得最多,94.5 对 87.4,7.1 分。这个基准测的是工具调用,正是 agent 场景的核心。
口径要先看 harness
官方自己标了一句很重要的话:K3 的编程成绩用的是 Kimi Code harness,部分对比模型取的是跨 harness 的最佳成绩。
这句话的意思是,那张表不是同一把尺子量的。
同一套测试框架下,工具链、重试策略、上下文管理都会影响结果。长程编程这种多轮任务,harness 的差异可能比模型差异还大。
所以 SWE-Marathon 那 3 分,我倾向于打折看。真要比较,得等第三方用同一套 harness 跑一遍。
我的判断
开源 3T 模型的价值不在分数,在成本结构。
闭源 API 按 token 收费,单价里包含了对方的显存成本。自托管 K3,你付的是 1.49TB 显存,但推理算力只按 104B 走。负载越重,这个错配越划算。
代价也清楚:1.49TB 的机器不便宜,随权重一起交接的责任(部署、调优、安全治理)全归使用方。K3 用的是自定义的 Kimi K3 License,允许研究和再创新,但条款细节我没逐条读,这一点存疑。
模型卡上还标了 moonshotai/Kimi-K3.1-Pro。迭代节奏没停,今天选的版本可能下个月就不是最优解。
FAQ
Q:2.8 万亿参数,为什么只要 104B 的算力?
因为它是 MoE 结构,896 个专家里每个 token 只激活 16 个。不激活的参数不参与计算,但仍然占显存。
Q:8 张 H200 能跑吗?
按 4.25 bit 估,权重约 1.49TB。8 张 H200 合计 1.13TB,装不下。这是我的估算,官方没有公布最低部署配置。
Q:K3 和 K3.1 Pro 是什么关系?
K3.1 Pro 是模型卡上标注的更新版本,站内另一篇记过它的权重是 1.56TB、折合每参数 4.46 bit。
Q:能商用吗?
权重用 Kimi K3 License 发布,官方说允许研究、部署与再创新。具体商用条款要看授权原文。
参考资料
- 读懂AI时代 · 月之暗面发布 Kimi K3:2.8 万亿参数开源多模态模型(2026-11-20,原源 Hugging Face 模型卡)
- 读懂AI时代日报 · 11 月 20 日(当日模型与行情条目)
3.71%、1.79%、26.9 倍都是披露数字直接除出来的。1.49TB 和 55GB 没法这么算:官方只说权重用 MXFP4,没给有效位宽,4.25 bit 是我按 4 位加缩放因子补的。这个假设偏一点,总量会跟着偏。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。