
一句话总结:Ricursive 的 Ripple-65B 是 65B 稠密模型、Apache 2.0,TerminalBench 2.1 拿到 80.52 分,比 501B 和 816B 的对手还高;Q4 权重 36.3 GiB,24G 卡装不下,48G 双卡刚好。
先说结论:这个模型的新闻点不是分数,是它用 65B 打过了 8 到 12 倍规模的对手。
分数高一点低一点没那么重要,重要的是它证明了在编程 agent 这个方向上,数据质量和训练配方能顶掉一部分参数。
对我们这些要部署的人来说,65B 稠密是一个很具体的数字:装得下,还是装不下。
Ripple-65B 赢在成本,不是参数
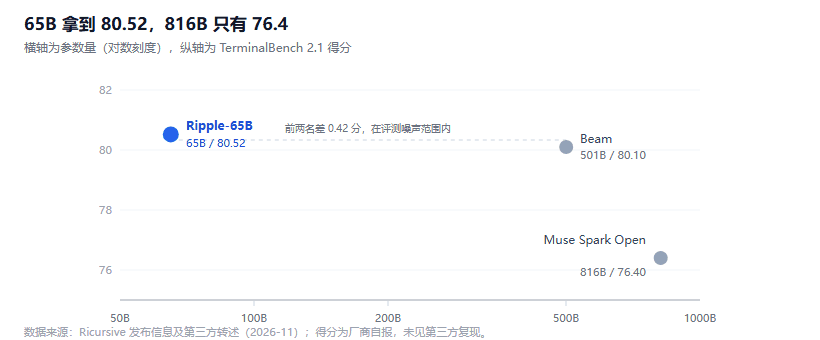
图 1:横轴为参数量(对数刻度),纵轴为 TerminalBench 2.1 得分。数据来源:Ricursive 发布信息与第三方转述
三个数摆在一起:
| 模型 | 参数量 | TerminalBench 2.1 |
|---|---|---|
| Ripple-65B | 65B | 80.52 |
| Beam | 501B | 80.1 |
| Muse Spark Open | 816B | 76.4 |
65B 拿 80.52,501B 拿 80.1,816B 拿 76.4。
前两名差 0.42 分——按上一批那篇抽样误差的算法,这个差距在评测噪声范围里,说"超过"其实站不住。
真正的差距在第三行:816B 反而低 4 分。规模不是单调收益,这个结论比"小模型打败大模型"更可信。
训练成本官方给的是约 3200 万美元。这个数字没有对照组,不知道比同类省了多少,但它是唯一可比的量。
Ripple-65B 的显存账:Q4 到 F16 差三倍
65B 稠密模型的权重,按不同量化:
| 精度 | 位/参数 | 权重 | 单卡能不能装 |
|---|---|---|---|
| Q4_K_M | 4.8 | 36.3 GiB | 48G 可以,24G 不行 |
| Q5_K_M | 5.6 | 42.4 GiB | 48G 勉强 |
| Q8_0 | 8.5 | 64.3 GiB | 80G 可以 |
| F16 | 16 | 121.1 GiB | 要两张 80G |
Q4 到 F16 差 3.3 倍。这就是量化的全部意义:同一套权重,换一个精度,从"两张卡"变成"一张卡"。
24G 卡的缺口是 36.3 − 24 = 12.3 GiB。这个缺口没法靠调小 batch 补——权重是常驻的,跟 batch 无关。
唯一的办法是层卸载:把一部分层放内存,用到的时候再搬。我在这台 2060 上测过 7B 模型的卸载,GPU 26.3 tok/s、CPU 4.7 tok/s,差 5.6 倍。65B 卸载一半,速度大概会掉到个位数。
24G 卡怎么跑 Ripple-65B:三种玩法
| 方案 | 可行性 | 速度预期 |
|---|---|---|
| 单张 24G,Q4 + 重度卸载 | 能起,很慢 | 个位数 token/s |
| 双卡 24G,Q4 张量并行 | 可行,卡在通信 | 20 到 40 token/s |
| 单张 48G(A6000/L40S),Q4 | 最舒服 | 受带宽限制,约 30 token/s |
第三种是甜点。48G 卡装 36.3 GiB 权重,剩 11.7 GiB 给 KV 和激活值。
算一下 KV:按 80 层、8 个 KV 头、head_dim 128、FP16 存,每 token 是 2 × 80 × 8 × 128 × 2 = 320 KiB。
8K 上下文要 2.5 GiB,32K 要 10 GiB,128K 要 40 GiB。
所以 48G 卡上,32K 上下文基本是上限,128K 得再加一张卡。
这是我估的,层数和 KV 头数官方没在模型卡里给全。如果实际是 64 层 4 头,KV 会降到 128 KiB/token,同样显存能开到 80K。
3200 万美元的训练成本怎么用
这个数字最容易被误读。
它不等于"你也可以花 3200 万训一个"。它意味着:这家公司的总训练开销是 3200 万,包括失败的尝试、重跑、调参烧掉的卡时。
真正可用的是另一个推论:如果 65B 能达到这个水平,那你的微调预算应该优先投在数据上,不是投在更大的基座上。
65B 开源、Apache 2.0、单机可跑,这三个条件凑齐的意义是:你能拿它做领域微调,成本可控,成果能商用。
816B 那个模型做不到这一点——不是许可证的问题,是你连推理都跑不起来。
关于 Ripple-65B 部署的五个问题
权重在哪下? Hugging Face,Apache 2.0。协议允许商用、修改、再分发。
65B 稠密和 65B MoE 有什么区别? 稠密模型每个 token 都要读全部 65B 权重;MoE 只读激活的那部分。所以稠密模型更吃带宽,但显存需求等于参数量,没有"专家全要常驻"的问题。
Q4 掉点严重吗? 编程任务对量化比较敏感,Q4 通常在基准上掉 1 到 3 个点。如果做代码补全,建议 Q5 起步。
能跑多长上下文? 官方没给明确窗口。按 KV 估算,48G 卡上 32K 是现实值。
TerminalBench 80.52 可信吗? 这是厂商自报的数字,第三方复现还没看到。同类榜单的自报和复现差异通常在 2 到 5 个点。
结语
Ripple-65B 值得关注的地方,是它把"开源编程 agent"这条线的规模门槛从"几百 B"拉回了"几十 B"。
对我们这些没有 8 卡机的人,这个变化是实质性的:以前那些刷榜的开源编程模型,看得到跑不动;65B 这一档,一张 48G 卡就能跑起来。
代价是性能上限。65B 再优化也追不上万亿参数的那一档,它赢的是"同分更便宜",不是"更强"。
如果你的场景是代码补全、单元测试生成、简单的仓库级修改,这一档够用。如果是长程重构,还是得看更大的模型——比如 Kimi K3.1 Pro 那种 1.56TB 的规模,前提是你有 16 张卡。
参考资料
- 谷歌前研究员发布 65B 模型,以十分之一成本击败 8 倍规模的编程 AI 模型(Global AI News)
- AI Daily Newsstand: November 7, 2026(BYOBot)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。