
一句话总结:K3.1 Pro 开源权重 1.56TB,折合每参数 4.46 bit,是官方量化的 4bit 版;8 卡 H200 节点装不下,最少 12 张起步,而且每卡只剩 11GB,连一个 128K 上下文的 KV cache 都放不下。
月之暗面 11 月 4 日开源 K3.1 Pro 权重,舆论场的注意力全在"2.8 万亿参数""46 分"这些数字上。真正想把它跑起来的人第一句话是:权重复制下来多大、几张卡装得下。这两个数官方没有明说,只能从第三方口径反推。
这篇把部署账从头算一遍。先对齐权重口径,再算卡数下限,再看剩余显存能不能撑住上下文,最后给量化方案的对比。全部是纸面账,我没有 12 张 H200 可跑,实机数字按存疑处理。
1.56TB 权重是多少 bit:先对齐口径
两个来源对得上:theairankings 写"1.56 TB self-host",AIFOD 报道总参 2.8 万亿。1.56TB 除以 2.8T,每参数 0.56 字节,折合 4.46 bit。
4.46 bit 这个数字基本坐实了一件事:官方放出的是 4bit 量化版。纯 4bit 是 0.5 字节每参数、1.40TB,多出来的 160GB 是 embedding、layer norm 和分组缩放因子的开销,11% 的 overhead 在大模型量化里是正常水平。BF16 原版则是 5.60TB,官方没有放,市场上能拿到的最低门槛就是这 1.56TB。
顺便排除一种误读:有人按 1.76T 参数口径反推出 7.09 bit,得出"7bit 权重"的结论。2.8T 的口径与 4bit 完全自洽,没有理由取 1.76T。参数口径这种事,先用文件大小校一遍再引用,LongCat-2.5 的 745GiB 那篇用的就是同一套校验法。
8 卡节点装不下:显存差 432GB
标准推理节点是 8 卡。H200 单卡 141GB,8 卡 1128GB;权重 1560GB,缺口 432GB,差得远。B200 单卡 192GB,8 卡 1536GB,看着只差 24GB,但这 24GB 必须留给 KV cache 和激活,实际上一样跑不了。
这就是量化版的意义所在。如果不量化直接上 BF16 的 5.60TB,8 卡缺口超过 4TB,连讨论的必要都没有。1.56TB 把门槛从"40 张卡"拉到了"12 张卡",已经是一个中小团队能谈的数字。
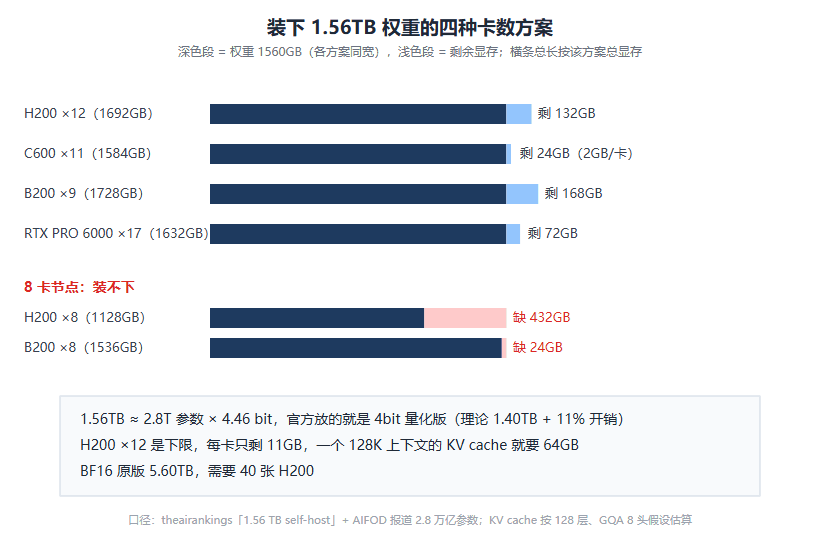
图 1:深色段是 1560GB 权重,浅色段是剩余空间;下方两个 8 卡方案标出缺口
12 张 H200 的显存下限:剩 11GB
按裸权重算,H200 最少 12 张,总显存 1692GB,权重占掉 92%,每卡剩 11GB。这点空间能放激活和缓冲,上下文就别想了。
算一笔 KV cache 就知道多紧。假设 128 层、GQA 8 个 KV 头、head_dim 128(2.8T 级 MoE 的典型配置,未验证),一个 128K 上下文的请求要 64GB KV,一个 1M 上下文的请求要 488GB。12 张卡剩的 132GB 总共只够两个 128K 请求。
所以实际部署是 16 张(两个 8 卡节点):权重占 69%,剩 484GB 给 KV 和激活,128K 上下文能撑七到八个并发,勉强算一个能用的服务。至于 1M 上下文,单请求就吃掉近 500GB,两个节点全体让路,一次只能服务一个请求。
其他卡型的下限:沐曦 C600 144GB 要 11 张、剩 24GB,比 H200 更紧,那篇带宽算账的结论在这里同样适用——每 GB 显存配多少带宽,决定 KV 密集负载的真实速度。B200 要 9 张、剩 168GB,是单节点方案里唯一有戏的,但 8 卡差 24GB 卡得很难受,9 卡的拓扑又不是标准形态。
量化到 INT4 之后:没有更便宜的档
权重已经是 4bit,常规量化路线走到头了。往下有 3bit 和 2bit 方案,2.8T 参数按 3bit 算是 1.05TB,8 卡 H200 还差 300 多GB;2bit 是 700GB,8 卡装得下还有余量。
但低比特的代价要心里有数。46 分的模型再砍一刀精度,掉多少分没有公开评测,我倾向认为 2bit 在这个规模的 MoE 上还能保住八成能力,这是经验判断不是实测结论。真要用,先跑一遍自己的评测集再上生产。
另一条路是 offload:权重留 GPU,部分专家层放 CPU 内存,用 8 张 H200 跑 1.5TB 的模型。代价是每个激活的专家都要跨 PCIe 搬数据,吞吐掉一到两个数量级,适合跑批处理,不适合在线服务。
BF16 原版是另一个世界
官方没放 BF16,但如果做训练或深度微调,5.60TB 是绕不开的数。40 张 H200 起步,按 H200 一小时 3 到 4 美元的市场价,一个训练任务开一晚上就是四五千美元的卡时。
这也是开源万亿模型的现实:推理能用量化版凑合,微调的门槛基本把中小团队挡在外面。K3.1 Pro 46 分配 0.24 美元输入价的 API,本质上是把这道门槛折成了账单。买 API 还是买卡,取决于你的调用量能不能摊薄那 16 张卡的固定成本,开源支出的剪刀差那篇里 Kimi 拿走 61% 份额,说明大多数人用脚投票选了前者。
这笔账的坑清单
按命中率排序。第一,8 卡节点幻觉:看到"单节点 8 卡"就默认能跑,B200 都差 24GB,先乘一遍再下单。第二,把 1.56TB 当成 BF16 大小去估算量化收益,它已经是量化后的数,没有再省一半的空间。第三,KV cache 按 128K 规划却忘了它是按请求线性增长的,12 卡方案剩的 132GB 只够两个并发。第四,C600 这类国产卡按张数对标 H200,忽略带宽差异,KV 密集负载下每 GB 配多少带宽才是真变量。
最后交代边界:层结构和 GQA 头数是我的假设,KV 数字按这个假设推的,实际以 config.json 为准;卡价和卡时价随行情波动;所有方案都没有实机验证,下单前先拿单节点试跑。
FAQ
Q:1.56TB 是下载体积还是显存占用?
基本一致。Safetensors 加载后不做额外解压的话,显存里的权重大小就是文件大小 1560GB,再加上 KV cache、激活和框架开销,实际占用只会更高。
Q:最少要多少张 H200 才能正常服务?
裸权重 12 张是数学下限,能正常服务要 16 张,给 KV cache 和并发留出空间。只做离线批处理、上下文短的话,12 张勉强可用。
Q:为什么官方只放 4bit 不放 BF16?
BF16 要 5.6TB,单个权重仓库的分发成本和下载时间都翻三倍多,而绝大多数开源用户的目的是推理。社区常有人自行反量化,精度损失自担。
Q:2.8T 参数这个口径可靠吗?
来自 AIFOD 等媒体对官方发布的转引,与 1.56TB 权重、4bit 量化三层相互印证,逻辑上自洽。但月之暗面没有发布完整的技术报告参数表,最终以仓库 config.json 为准。
Q:跑不起来 API 也不想买卡怎么办?
K3.1 Pro 在 OpenRouter 等聚合平台有托管服务,牌价 0.24 美元输入、8.41 美元输出每百万。对绝大多数用量,API 比 16 张卡的折旧和电费便宜得多。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。