
一句话总结:英伟达 Bolt E4B 用 4GB 显存换 133 tok/s 的端侧对话,Meta Muse Glimmer 30B 用 17GB 换 131K 上下文和视觉,KRAFTON Raon-1 mini 用 30B-A4B 换韩语优势——三个都是 Apache 系许可,但解决的是三种完全不同的需求。
大模型还在卷参数,另一条线在卷「每 GB 能干什么」。这三个月发的小模型,设计目标比大模型差异更大。
挑了三款有代表性的:英伟达的 Bolt E4B(极致小)、Meta 的 Muse Glimmer 30B(中量级)、KRAFTON 的 Raon-1 mini(垂直语言)。它们不是同一场比赛,放在一起看反而清楚。
规格先对齐
| 项目 | Nemotron 3.5 Bolt E4B | Muse Glimmer 30B | Raon-1 mini |
|---|---|---|---|
| 发布 | 2026-10-23 | 2026-10(Meta) | 2026-10(预览) |
| 参数 | 8B 总 / 4B 有效 | 30B | 30B 总 / 4B 激活 |
| 上下文 | 64K(Ollama 包标 128K) | 131,072 | 未公开 |
| 输入 | 文本(部分包支持图像) | 文本 + 图像 | 文本 |
| 量化体积 | Q4_K_M 约 6.2GB,峰值 3.1–4.3GB 显存 | Q4 主模型 16.76GB + 视觉 1.40GB | 未公开 |
| 许可 | OpenMDW-1.1(底座 Gemma 4 为 Apache 2.0) | Apache 2.0 + 使用政策 | Apache 2.0 |
| 定位 | 端侧语音/角色/机器人 | 本地多模态 Agent | 韩英双语,编程与 Agent |
先纠正一个常见误读:「4GB 模型」说的是量化后的运行占用,不是权重文件大小。 Bolt E4B 的 BF16 权重约 15.9GB,Q4_K_M 文件 6.2GB,跑起来峰值 3.1–4.3GB。三个数字都真,看你问的是哪个。
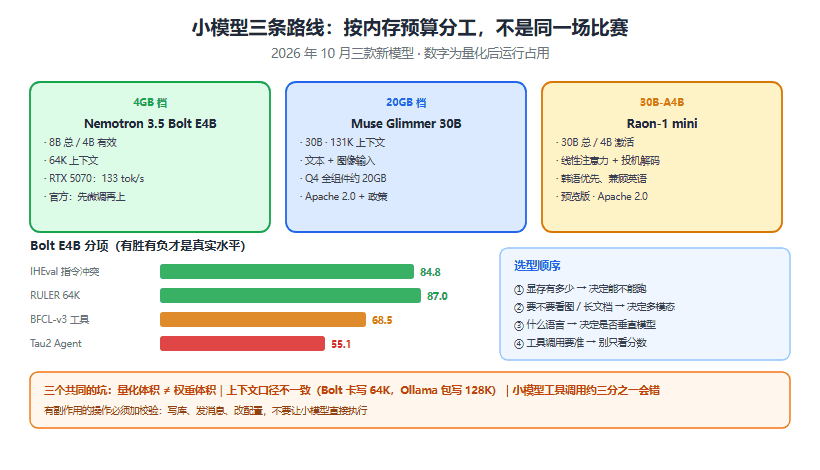
图 1:三款模型的内存档位与 Bolt 的分项表现
路线一:Bolt E4B,为「装得下」而生
英伟达这次没走「更强」的路线,走的是「更省」。8B 总参数里只有 4B 真正参与计算,底座是 Gemma 4 E4B 后训练,目标场景写得很直白:车载助手、游戏角色、机器人、语音前台。
数字挺硬:RTX 5070 上 133.4 tok/s、显存 3.5GB;Jetson Orin Nano 8GB 上 15.5 tok/s、首 Token 5.8 秒。后者已经不适合实时对话,但跑后台任务够用。
分项成绩有胜有负,这反而是可信的信号:
- IHEval 84.8(指令冲突处理),Gemma 4 E4B 是 67.0,Qwen3.5-4B 是 60.6
- BFCL-v3 工具调用 68.5,输给 Qwen3.5-4B 的 70.9
- RULER 64K 长上下文 87.0,输给 Qwen 的 95.1
- Tau2-Bench Agent 55.1,明显输给 Qwen 的 75.1
英伟达自己在模型卡上写了一句很实在的话:这个模型「主要用于定制和后训练,而不是直接用于生产推理」。翻译过来就是:拿去微调,别直接上生产。他们还跳过了 SFT,纯用强化学习后训练,理由是 SFT 会损害对话质量。
路线二:Muse Glimmer 30B,为「本地多模态」而生
Meta 这个 30B 走的是另一条路:不追求小,追求「在本地能干活」。Q4 主模型 16.76GB,加视觉模块 1.40GB,还有个可选的 1.63GB 推测解码器,全开接近 20GB 显存。
131K 上下文、支持图像输入,许可 Apache 2.0 但附了使用政策。它和 Muse Spark(816B/42B 激活)是同一代的产品线,一个在云端,一个在本地。
适用场景:本地文档理解、截图分析、桌面级 Agent。它的显存门槛把 8GB 卡排除了,16GB 起步比较现实。
路线三:Raon-1 mini,为「非英语」而生
KRAFTON 是做游戏的(PUBG 的母公司),这个模型明显带着产品目的:韩语优先,兼顾英语,30B 总参数 4B 激活,用了线性注意力和投机解码,Apache 2.0,官网还给限时免费 API。
它宣称在编程和 Agent 任务上对标 Meta 的 Muse Glimmer 30B,速度更快、内存更省。目前是预览版,第三方复现还没有。
这类「垂直语言模型」的价值经常被低估:通用模型在韩语、日语、阿拉伯语上的表现,往往比英文差一个档,本地化模型能补上这个缺口。
三条路线怎么选
| 你的需求 | 选谁 | 理由 |
|---|---|---|
| 4–8GB 显存、离线语音助手 | Bolt E4B | 3.5GB 就能跑,133 tok/s 足够对话 |
| 16GB 以上、本地看图和长文档 | Muse Glimmer 30B | 131K + 视觉,唯一的多模态选项 |
| 韩语业务、要 Apache 2.0 | Raon-1 mini | 语言优势 + 许可干净,但等正式版 |
| 工具调用要准 | 都不选,看 Qwen3.5-4B | Bolt 在 BFCL 和 Tau2 上都不占优 |
三个共同的坑
量化数字被当成权重体积。 4GB、6GB、16GB 这些说法混着用,采购和运维容易算错显存。看模型卡里的「峰值显存」那一栏。
上下文口径不一致。 Bolt 的官方卡写 64K,Ollama 的包写 128K 还带图像输入——不同打包方式能力不同,用之前确认自己装的是哪个版本。
小模型的工具调用不可靠。 68.5 分的 BFCL 意味着三分之一场景会错。写数据库、发消息这类有副作用的操作,必须加一层校验,别让它直接执行。
常见问题
4GB 显存真的能跑吗?
能,但那是 Q4_K_M 量化 + 短上下文的峰值。上到 64K 上下文,显存会明显上涨,8GB 卡更稳妥。
Bolt E4B 能直接商用吗?
许可允许(OpenMDW-1.1,底座 Apache 2.0),但英伟达明确建议先做后训练。直接拿去接客户,效果大概率不达标。
Muse Glimmer 30B 需要什么显卡?
Q4 全组件约 20GB,建议 24GB 显存(4090/3090)或统一内存的 Mac(32GB 以上)。
Raon-1 mini 中文能用吗?
它是韩英优先,中文不在主目标里。中文场景建议看 MiniCPM5 或 Qwen 系列。
这三个和云端大模型什么关系?
互补。端侧负责隐私、离线、低延迟的简单任务;复杂任务还是走云端。混合路由才是常规做法。
结语
小模型这波竞争的本质,不是「谁更聪明」,是「在给定内存预算里谁更能干」。Bolt 把预算压到 4GB,Glimmer 把多模态塞进 20GB,Raon 把语言本地化做进 30B。
选型时先问自己显存有多少、要不要看图、说的是什么语言,答案基本就定了。分数只在同一条路线内比较才有意义。
参考资料
- Nemotron 3.5 Bolt E4B 发布与实测(CodeYourCraft) - 显存、速度与分项分数出处
- Bolt E4B 定位与后训练说明(Rush Commerce) - 「用于定制而非直接生产」的模型卡原文
- 开源模型清单与许可说明(S5 Labs) - Muse Glimmer 组件体积与许可
- KRAFTON Raon-1 mini 预览(IT之家) - 30B-A4B、Apache 2.0 与定位
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。