
一句话总结:Google DeepMind 10 月 27 日放出 Genie 4 研究预览,相比 Genie 3 有四项变化:更真实的世界、运行中用自然语言实时改场景、原生生成音频、由 Gemini 3.8 Flash 当「导演」规划并校验每一帧。单段连贯时长从一分钟翻到两分钟,官方也承认跑久了细节仍会漂移。
世界模型这个品类有意思的地方在于:它不像语言模型那样有明确的评测榜。你很难说「这个世界的物理正确率是多少」。所以判断一个世界模型好不好,基本看三件事:能跑多久不崩、能改什么、以及是不是只能看不能碰。
Genie 4 在这三件事上都往前挪了一步。
四项变化
| 维度 | Genie 3 | Genie 4 |
|---|---|---|
| 单段连贯时长 | 约 1 分钟 | 约 2 分钟 |
| 音频 | 无 | 原生生成环境音、音乐、可交互对话 |
| 运行中干预 | 有限 | 自然语言实时改:天气、机位、增删人物物体 |
| 驱动方式 | 自身 | Gemini 3.8 Flash 当规划与校验层 |
| 物理 | 基础 | 空气动力学与碰撞处理改善,人物动作更自然 |
官方给的定位还是那三个场景:影视预可视化、游戏原型、机器人训练环境。这几个方向的共同点是「在真实投入之前先看一眼」。
两分钟为什么是硬指标
外行看两分钟会觉得短得可笑,实际这是当前最硬的约束之一。
世界模型是逐帧生成的。它没有预渲染的场景,也没有预设的物理引擎,每一帧都是模型根据上一帧和当前操作推出来的。跑得越久,误差累积越多,最终要么画面崩坏,要么整个场景的逻辑散掉。
从一分钟到两分钟,中间不是简单加一倍算力。它意味着模型把「物体恒存」这件事记住的时间变长了——你转个身回来,那棵树还在原地,杯子还在桌上。DeepMind 自己在发布材料里也留了余地:跑得越久,细节与物体恒存性会出现漂移。
我的判断是,两分钟够做原型,不够做产品。影视预演一个镜头、游戏里验证一段玩法交互、机器人训练采一段演示轨迹,两分钟很够用。但要做成一个能玩十分钟的关卡,现在这套还差得远。
Gemini 3.8 Flash 当导演
这是架构上最值得说的一点。
Genie 4 不是单打独斗,它上面套了一层 Gemini 3.8 Flash。这层的工作是把用户的目标拆成步骤、规划路径、并在生成每一帧时做检查评估,防止模拟跑偏。
Google 研究总监 Tejas Kulkarni 在简报会上的说法是,未来会越来越多地看到「混合式世界模型」:Gemini 负责写代码和文本,Genie 实时读取并做不同抽象层级的仿真。
这套分工解决了一个具体问题:世界模型不会「规划」,它只会「续写画面」。让它自己想「用户要走到那扇门」,它做不到;但让一个语言模型把任务拆成「先向左转、再直行、到门前停下」,世界模型就能逐段执行。
有个细节能说明这套组合的用法:在和 Gemini 机器人项目相关的一个实验里,Gemini 4 Argon 把任务拆成多个步骤,Genie 4 负责实时仿真,验证「真机测试之前先在虚拟环境里跑一遍」这条路可行。
对做机器人的人这才是关键收益:合成训练环境的边际成本接近零,而真机采数据的成本是实打实的。
原生音频被低估了
多数报道把音频当成一个附加功能写,我认为它比看上去重要。
Genie 4 能生成三类声音:环境的背景声、音乐、以及可交互的对话。三类都跟场景同步变化——你在场景里走动,声音会跟着变;加了个人物,对话也会出现。
这解决的是「沉浸感的木桶效应」。一个能实时操作、光影逼真但完全静音的世界,你大脑第一秒就知道它是假的。声音补上之后,判断真假的依据才从「看」变成「感受」。
但官方也承认两个短板:音频准确性不足,以及场景里的文字常常糊得看不清。后者做影视预演时挺要命,因为画面里的招牌和字幕本身就是信息。
谁能用,多少钱
现在的状态是研究预览,只给受信任测试者。等候名单已经开放(Project Genie)。
消费端的路径是 Google AI Ultra 订阅,起步价每月 100 美元,未来几周内分批推送;AI Pro 和 AI Plus 可能会后续跟进,但没有时间表。
开发者走 Gemini API 和 Google AI Studio,官方说「即将提供」,定价和具体时间都没公布。
参数规模、上下文、评测分数,一概未披露。这点要留意:目前所有关于它「更真实」的判断,依据都是 Google 自己的演示视频。
商业侧:游戏股又跌了一轮
有个现象值得记一笔:Genie 3 发布时把游戏股砸了一波,Genie 4 发布又来了一次。
理由不难理解——如果一句话就能生成一个可玩的世界,那「做场景」这件事的价值就要重估。不过从我跟踪的情况看,这类反应通常是情绪性的:世界模型现在生成的是「体验片段」,不是「可发行的游戏」,中间隔着关卡设计、数值、叙事、优化、发行一整套。
赛道的整合趋势倒是实打实的:Runway 出了第二款世界模型 GWM WoRLds 2(也带音频);李飞飞的 World Labs 被 AMD 收购;亚马逊在谈收购 Decart;Rivian 收了 Third Dimension 做自动驾驶仿真。世界模型正在从研究品变成大公司的能力组件,这比股价波动更能说明问题。
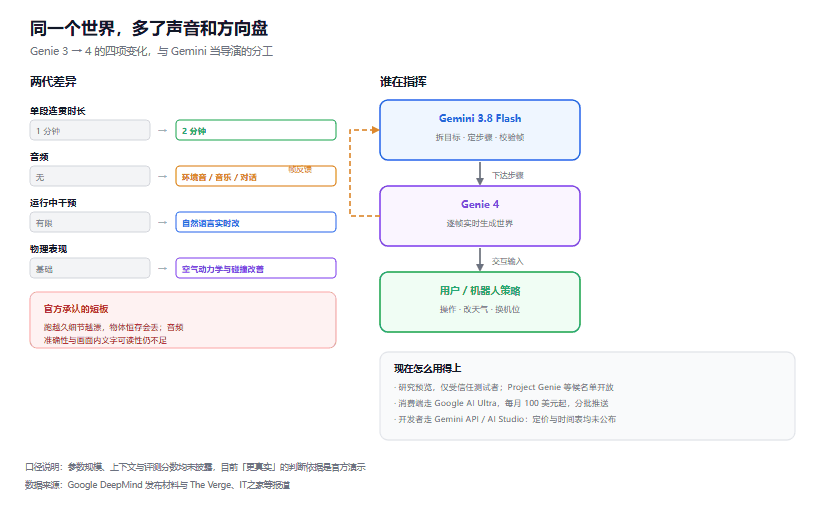
图 1:左为两代的核心差异,右为 Gemini 当导演、Genie 出画面的分工
FAQ
世界模型和视频生成模型有什么区别?
视频生成是「给定提示,产出一段确定的视频」;世界模型是「边跑边生成,且对用户操作有响应」。前者只能看,后者能玩。
两分钟是不是太短了?
做原型够用,做产品不够。视觉模型的长时一致性是当前全行业的天花板,不只是 Google 一家的问题。
需要多少算力才能用?
消费端走订阅(AI Ultra 每月 100 美元起),你不需要自己的算力。开发者 API 的定价还没公布。
和 Sora 那类视频模型是竞争关系吗?
部分重叠但不完全。视频模型解决「产出内容」,世界模型解决「生成可交互环境」。像Gemini Omni 那类对话式视频编辑,本质上还是在已有素材上做修改。做影视预演两者都会用上。
中国有对应的产品吗?
有类似方向,但公开可用的交互式世界模型还不多。这块的差距主要不在单点效果,在于「实时生成 + 规划校验」这套工程组合。
结语
Genie 4 的进步可以概括成一句话:从「能生成一个会动的世界」到「能生成一个能改的世界」。
两分钟、有声音、能边跑边改,这三个条件凑齐之后,它第一次具备了「当工具用」的雏形。至于什么时候能当生产工具用,取决于长时一致性什么时候突破,而这个问题目前没人给出时间表。
参考资料
- The Verge - Google 发布 Genie 4,含音频与实时提示编辑
- Google DeepMind 官方说明 - Genie 4 研究预览与访问方式
- IT之家 - Genie 4 的四项更新与世界模型赛道整合
- 网易科技 - 两分钟世界边跑边改的技术细节
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。