
一句话总结:BOSS 直聘旗下 Nanbeige 实验室 10 月 25 日在 Hugging Face 放出 33B 稠密智能体模型,Apache 2.0、512K 上下文,官方自报在 Terminal-Bench 2.1 上 80.9 分。但第三方在 Terminal-Bench 4.0 上实测只有 23.8 —— 两个数字都真,只是不同版本的榜,这篇把口径拆清楚。
30B 这个档位今年特别挤。Qwen3.8-27B 是本地部署的事实标准,Muse Glimmer 30B 主打多模态,现在又来了一个 33B 稠密。三家都在同一个内存区间抢位置,选型的时候光看参数已经没意义了。
Nanbeige 这个实验室背景值得一提:隶属 BOSS 直聘,之前在做招聘场景的模型。这次放的是通用智能体模型,定位写得很明确——先出大模型,再蒸馏出 3B 小版本,大模型是教师。
规格
| 项目 | 参数 |
|---|---|
| 发布时间 | 2026 年 10 月 25 日 |
| 参数规模 | 33B 稠密(非 MoE) |
| 上下文 | 524,288 Token(512K) |
| 协议 | Apache 2.0 |
| 权重 | 基座与对话权重均放出 |
| 定位 | 智能体 / 仓库级任务,兼作 3B 蒸馏教师 |
| 官方基准 | Terminal-Bench 2.1 80.9;DeepSWE 65.5 |
Apache 2.0 这条要单独说:它比 Qwen3.8-27B 的 Apache 2.0 一样宽松,也比 Kimi、M3.1 Flash 那些带商用门槛的自定义协议省心。要嵌进产品里卖,这一档不用找法务。
跑分那个「矛盾」,其实是两个榜
网上现在流传两组数字,看着像打架:
- 官方:Terminal-Bench 2.1 = 80.9
- 第三方:Terminal-Bench 4.0 = 23.8
差 57 分。这不是谁造假,是两个不同版本的测试集。Terminal-Bench 从 2.1 到 4.0 难度跨了好几级,同一批模型在两版上的分数根本没有可比性。
有个参照能印证:Kimi K3.1 Pro 在 Terminal-Bench 4.0 上是 65.7%。一个 2.8 万亿参数、激活 104B 的旗舰在 4.0 上拿 65.7,那 33B 稠密拿 23.8 就完全说得通——不是它弱,是 4.0 太硬。
同理第三方给的 DeepSWE 65.5 和 Qwen3.8-27B 的 42.5 也是同一套 4.0 系列口径下的对比,这个差距才是有意义的信号。
我的建议很简单:看跑分先看版本号,再看是谁测的,再看对手是谁。 三个缺一个,那个数字就没有决策价值。
第三方实测:Colab 上一台 A100-80GB
有个做本地部署的博主用 Colab CLI 拉了一台 A100-80GB 实测,结论是「有点东西,但不多」。
这个评价我认为挺准确。它在智能体类任务上确实压过了 Qwen3.8-27B(Terminal-Bench 4.0 上是 6.3 分),差距不是一星半点;但通用对话和知识类任务没有明显优势,中文语感也不一定比 Qwen 好。
三十多 B 的稠密模型有个天然特点:每一层权重都被实际激活,所以显存占用和算力开销是实打实的,不像 MoE 那样能用「总参数大、激活少」换便宜。好处是推理稳定、不用赌路由,坏处是不能靠稀疏性省显存。
对本地部署的人,这意味着 33B 稠密就是 33B 的显存账单,没有折扣。
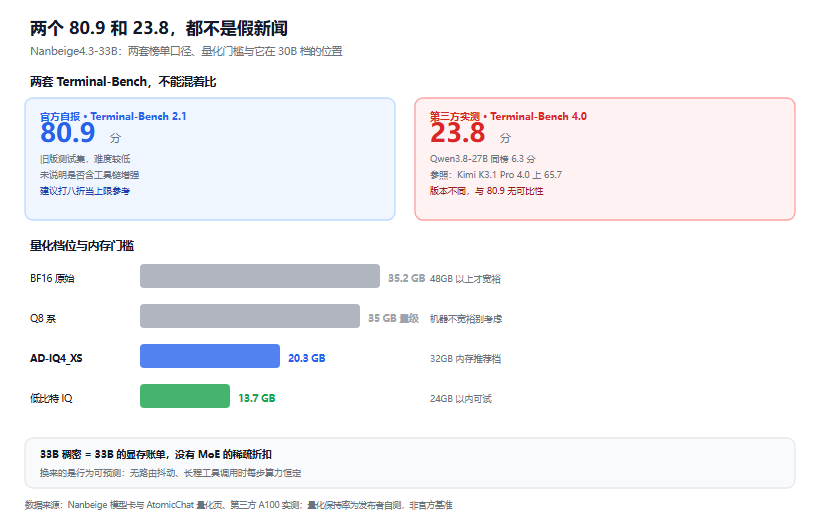
图 1:左为两套榜单的口径差异,右为量化档位对应的内存门槛
量化:35.2GB 到 13.7GB 的三级跳
官方发的是 safetensors。第三方(Atomic Chat)在发布当天就上传了 GGUF 量化组,体积从 35.2GB 压到 13.7GB。
| 档位 | 体积 | 适合的内存 |
|---|---|---|
| BF16 原始 | 35.2GB | 48GB 以上 |
| Q8 系 | 约 35GB 量级 | 偏大,机器不宽裕别考虑 |
| AD-IQ4_XS | 20.3GB | 32GB 内存的机器(发布者推荐) |
| 低比特 IQ 系 | 13.7GB | 24GB 以内可试 |
发布者称 AD-IQ4_XS 相对 BF16 的 top-1 保持率是 92.0%。这个数字要打个折看:第三方自测,不是官方基准,而且 top-1 保持率只反映首选 token 的一致率,不等于下游任务准确率。上生产前用自己的任务集复测一遍,别直接采信。
稠密路线在这个档位的意义
今年主流是 MoE:总参数做大、激活做小,用稀疏性换成本。Kimi K3.1 Pro 是 2.8T 总参数激活 104B,M3.1 Flash 是 428B 激活 23B,都是这个思路。
Nanbeige 反着来,33B 全稠密。这条路的好处是行为可预测:没有路由抖动,长程工具调用时每一步的计算量恒定,不会因为某个 token 被路由到冷门专家而出现延迟尖峰。对需要稳定吞吐的服务来说,这点比峰值性能重要。
坏处也直接:同等的激活量下,稠密模型的内存占用更高,跑起来更贵。所以它的定位其实是「单机、离线、稳定」,不是「大规模服务」。
谁适合下这个模型
适合:32GB 内存以上的单机做智能体实验、需要 512K 长上下文处理代码仓库或长文档、要 Apache 2.0 干净协议做二次分发、想拿它蒸馏小模型的团队。
不适合:以中文对话质量为核心的产品(Qwen 系更稳)、显存紧张的 24GB 显卡用户(得上低比特量化,精度有损)、追求极限吞吐的服务端(MoE 更划算)。
说实话,33B 稠密这个规格有点尴尬。往上,30B 档的 MoE 用更少激活做到相近能力;往下,7B 到 14B 的量化版在消费级机器上跑得更舒服。它真正的价值在「单机 + 长上下文 + 稳定」这个交集里,出了这个范围就不划算了。
FAQ
官方 80.9 分可信吗?
数字本身没问题,但它是 Terminal-Bench 2.1 的自报成绩,且没有说明是否用了工具链增强。看模型自报分的时候,我一般打个八折当上限参考。
和 Qwen3.8-27B 到底谁强?
分场景:智能体与终端任务 Nanbeige 明显强(4.0 口径下 23.8 对 6.3),中文对话与知识问答 Qwen 更稳。没有全面胜出的一方。
32GB 内存真能跑起来吗?
能,但只能用 AD-IQ4_XS 那一档(20.3GB),还要给 KV cache 留余量。512K 上下文开满会爆内存,实际用 8K–32K 更现实。
为什么先出大模型再蒸馏小模型?
这是当下小模型的主流训练路径:大模型当教师生成高质量轨迹,小模型学的是「怎么做」而不是「知道什么」。Nanbeige 官方把这条写进了定位里。
Apache 2.0 有什么限制?
基本没有,商用、修改、再分发都可以,只需保留协议与版权声明。比带 MAU 门槛的自定义协议省事得多。
结语
这个模型的正确读法是「30B 档多了一个 Apache 2.0 的智能体专精选项」,不是「Qwen 杀手」。
它值得试,尤其你在做本地智能体实验、又不想碰许可条款的时候。但别被 80.9 这个数字带着走——先把版本号和测试方搞清楚,再决定要不要花那几个小时下权重。
参考资料
- Nanbeige4.3-33B 模型卡(Hugging Face)- 协议、上下文与官方基准
- AtomicChat/Nanbeige4.3-33B-GGUF - 第三方量化档位与体积
- 网易科技 - 第三方 A100 实测:Terminal-Bench 4.0 与 Qwen3.8-27B 对比
- 本站 Qwen3.8 家族深度解读 - 27B 档位与许可证对照
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。