
一句话总结:10 月 6 日 OpenAI 公开了 722 份由内部未发布模型生成的数学手稿,覆盖 372 组成果,部分附了 Lean 形式化证明。机器能验的那一层过了,人类能理解的那一层是空的,发布后两天就有 3 篇因符号错误撤回、14 篇修订。争论的焦点不在 AI 会不会做数学,在于验证这件事的成本被推给了谁。
一、发生了什么
时间线先摆清。
9 月 11 日,圈内开始传 OpenAI 解决了若干长期开放问题。9 月 21 日,OpenAI 宣布与一个九人独立小组 AGMAI 合作,成员横跨类型论、代数几何、自动推理和 AI 伦理。10 月 6 日,722 份手稿一次性公开,组织成 372 组成果,部分附 Lean 形式化代码放在 GitHub。10 月 8 日,更新日志显示首批里有 3 篇因符号错误撤回、14 篇修订、13 篇更新引用。
这个节奏本身很说明问题。学术出版要经过同行评审、修改、再评审,周期以月计。一次性放出七百多份,等于把审稿这一环整个跳过去,然后交给社区。
我的判断是:这批东西的价值不在"AI 能解题",而在它把一个平时被掩盖的成本暴露出来了,验证。
二、Lean 到底验了什么
这是整件事里最容易被误读的地方,得拆开说。
Lean 是一个交互式定理证明器,它做的事情是:你把数学命题写成代码,它检查这段代码的逻辑推导有没有漏洞。检查很严格,严格到只要有一个假设没被证,它就报错。
所以"Lean 验过了"这句话,准确含义是:从这份代码出发,到这段代码声称的结论,推导是成立的。
它不保证的是另外两件事:
第一,这段代码对应的命题,是不是原来那个命题。把"2-to-1 games conjecture"写成 Lean 语句,这个翻译过程是人做的,或者模型做的,翻错了机器不知道。
第二,这批手稿里有多少附了 Lean。斯科特·阿伦森的说法是,372 组成果里"有一些"有 Lean 证书,不是全部。夸塔的报道补充了细节:被 Lean 验证的那一项是 2-to-1 games conjecture,不是 unique games 本身。
我认为这两个限定决定了这批手稿的实际分量。一个通过 Lean 的代码,只证明了代码自己成立;它跟原论文的对应关系,还是得人来确认。而人的这一环,恰好是缺的。
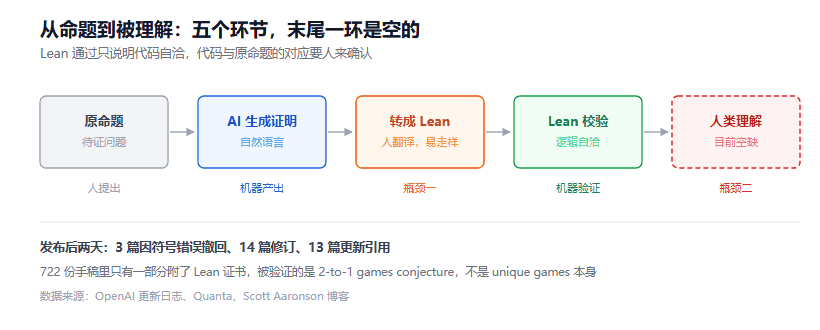
图 1:从命题到被理解,五个环节里机器能覆盖两个,末尾那个环节目前是空的
三、谁在批评,说了什么
几条有分量的意见。
牛津的 Ursula Martin 在《自然》上写得很直接:OpenAI 把一堆草稿抛出来,指望学术界来收拾。
陶哲轩的关注点不一样,他说深感挫败的是,参与这些证明的人里没有人能回答问题或做讲座。正常的学术链条里,证明者要能向同行解释解法、教下一代,后续研究才能接上。这条链条现在断了。
阿伦森在博客里的表述更干脆:目前还没有人真正理解这些证明中的任何一个,"理解它们的竞赛才刚刚开始"。同时他也说了,那个 Lean 证书大概率是真证明,但他没法排除 Lean 内核被利用这种极端情况,只是认为极不可能。
还有一条来自 MIT。Dor Minzer、Yumou Fei、Shuo Wang 在 AI 传闻出现约三天后,向 ECCC 提交了 95 页的人工证明,证的是一个稍弱的 2-to-1 结果。Minzer 的话很实在:你不知道会不会被那家万亿美元公司抢发。
Mark Braverman 一句总结我觉得最准:靠新闻稿做数学,对数学不健康。
顺便说一句,10 月 7 日在陶哲轩博客上出现了一份署名"人类数学协会"的客座声明,称一次性发七百多份文件是"权力展示"而不是学术展示,呼吁数学家停止与 OpenAI 合作。这份声明没有署名者、没有成立日期,陶哲轩本人表示只是转帖不代表认同。我的看法是它反映了一种真实情绪,但作为论据的分量有限,因为它没给出任何关于手稿正确性的证据。
四、3 篇撤回透露的信息
更新日志里那三个数字,比任何评论都有说服力。
722 篇里,2 天内撤回 3 篇、修订 14 篇、更新引用 13 篇。撤回率约 0.4%,修订加更新约 3.7%。
单看比例不高。但要想清楚一件事:这是在发布前已经过内部流程、部分还做了 Lean 形式化的结果。也就是说,剩下那 96% 里还有多少处需要改,现在没人知道,因为没人读完。
我倾向于认为这批稿子的数学质量可能真的不错,模型在这类问题上的能力有目共睹。但"可能不错"和"已经验证"是两个概念,把它们混在一起,就是给后面接手的人挖坑。
五、真正的成本在哪
算一笔账。
官方口径是每项成果平均消耗约相当于 ChatGPT Pro 三小时算力。生成的成本被压得很低,低到可以批量做。
验证的成本没变。一个受过训练的数论研究者读一份 20 页的证明,找出隐藏的假设漏洞,需要几天。722 份,就算分给 100 个人,每人 7 份,也是几个月的全职投入。
这笔成本现在落在谁头上?落在那些本来在教本科生、写自己论文的数学家身上,而且是免费劳动。九人顾问小组解决不了这个问题,九个人读不完 722 份。
这就是我说"验证成本被推给别人"的意思。生成变便宜了,不等于整条链路变便宜了,只是把贵的那一段挪到了别人桌上。
六、对做工程的人有什么用
这事的启示不止于数学。
任何用 AI 批量产出"看起来经过检验的东西"的场景,都有同一个陷阱:中间的自动校验只覆盖了一部分,剩下那部分被默认为通过。
拿代码场景对照最清楚。CI 全绿说明单测过了,不代表业务逻辑对;类型检查通过说明类型自洽,不代表没有逻辑漏洞。Lean 之于数学,等于类型检查之于代码,它保证的是局部自洽,不是全局正确。
所以我给自己定了一条规矩:凡是自动化检查没覆盖到的环节,必须在交付说明里点明"未验证",不能把它藏在整体通过里。 这条规矩来自踩坑,不来自理论。
FAQ
722 份手稿是 OpenAI 官方确认的数字吗?
是,多家媒体报道一致,包括更新日志里撤回篇数也是以 722 为分母。另有少数报道写 719,可能是不同时点的统计,以官方仓库为准。
Lean 通过是不是就说明证明对了?
不是。Lean 检查的是代码内部的逻辑推导。代码与原始命题的对应关系需要人来确认,这一步机器做不了。
为什么数学家反应这么大?
因为发布方式绕过了同行评审,而评审是学术共同体的核心劳动。一次性放七百多份,等于把审稿工作量单方面转移出去,且没有对应的责任主体。
这事对数学研究有实际贡献吗?
有,但贡献的形态不是"又多了一批定理"。更实际的价值是把"AI 能不能产出可验证的数学"这个问题变成了可检验的实验,代价是消耗了社区的验证精力。
普通人该关心这件事吗?
如果你在用 AI 做任何需要正确性保证的工作,这类争论提供了一套现成的检查清单:哪一层是机器验的、哪一层是人验的、人这一层现在是谁在做。
结语
这批手稿最终会被消化掉,可能一年,可能三年。到那时候回头看,它的意义大概是第一次让整个行业看清:生成能力和验证能力之间有个缺口,模型越强,缺口越大。
给个能马上用的动作:翻一遍你手上任何由 AI 产出的交付物,问三个问题。哪部分是机器验过的,哪部分是靠人看的,人看的那部分有没有记录。三个问题答不上来的,那份东西现在就是"未验证"状态。
参考资料
- 朝鲜日报英文版 - OpenAI 发布未经评审数学手稿引发的责任争议
- AGI Watch - 事件时间线、Lean 证书状态与各方表态汇总
- 财经头条 - 722 篇手稿的算力口径与撤回修订数据
- Lean 官方文档 - 交互式定理证明器的工作原理
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。