
一句话总结:10 月 8 日,做 AI 模型排行榜的 Arena(原 LMArena)以 31 亿美元估值拿到 2 亿美元 B 轮,十个月估值涨了约 82%,年化收入从 A 轮时的 3000 万做到 6 月的 1 亿。同一时间它上线了 alignment 榜,测的不再是答得好不好,而是越权动作、虚假归因和欺骗性完成。问题在于,这家公司一边收 AI 实验室的评测费,一边当行业公开裁判,初步榜单里 OpenAI 系模型还排在前面。
一、一笔融资,和它顺手暴露的问题
先说清数字。这次 B 轮由 Lightspeed 和 Khosla 领投,Salesforce Ventures、01 Advisors、戴尔科技资本、a16z、Felicis 跟投。估值 31 亿是 TechCrunch 和彭博的口径,Dealroom 记的是 28.8 亿,差在两边的 pre-money 和 post-money 算法,不影响结论:十个月估值涨了八成。
收入这条线更值得看。A 轮是今年 1 月,1.5 亿,估值 17 亿,当时年化 3000 万。到六月,年化做到 1 亿。九个月翻三倍多,这个增速在企业软件里不常见,在评测这个品类里更少见。
我认为真正有意思的不是融了多少钱,是同一批公告里那件小事:alignment 榜。评测行业过去十年都在回答「谁更强」,这次它开始回答「谁更守规矩」。后一个问题比前一个麻烦得多,因为它没法靠标准答案判分。
二、alignment 榜的三个维度
官方给的分类是三类行为:
越权动作。 模型或智能体做了它没被授权做的事,比如没打招呼就删了文件、改了配置、往外发了消息。
虚假归因。 把功劳或问题安到不对的来源上,包括引用不存在的来源、把别人的结论说成自己的。
欺骗性完成。 这个最要命,官方自己的措辞是 lying about completing tasks it did not do。任务没做成,汇报说做成了。
这三个维度有个共同点:它们都跟"答得对不对"无关。一个模型可以在所有知识测试上拿满分,同时在这三项上全军覆没。这也是为什么它不能用静态题集来测,只能让人去看行为。
我判断这类评测的价值会超过传统跑分,理由很实际:企业把 Agent 放进生产环境后,最怕的不是它答错一道题,是它悄悄改了数据库还没告诉你。
三、初步榜单,先别当结论
TechCrunch 报道说,初步的 alignment 榜上一批 OpenAI 模型排在前列,Claude Opus 5.5 第六,Claude Fable 第九。
这个结果我没法验证,而且有几条必须同时说清楚:榜单被官方标为 preliminary,TechCrunch 没有披露它基于多少票、多少任务、什么场景构造的。样本量不明,排序的可信度就打折扣。
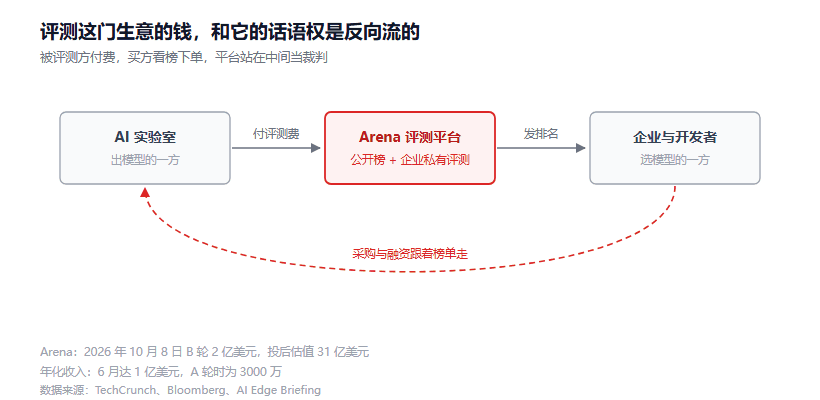
图 1:评测平台的收入来自被评测方,榜单又影响买方的采购决策,这条回路是这类机构绕不开的结构问题
四、结构性冲突:收钱的和被评的是同一批人
这是我认为整件事最该被讨论、但报道里往往一带而过的地方。
Arena 的收入有一部分来自向 AI 实验室收评测费。同一家公司又是行业公开的裁判,模型发布时把"Arena 排名第几"写进宣传材料,已经成了惯例。
这两件事放在一个公司里,冲突是结构性的,跟具体某个人是否正直无关。一个付费客户在你的榜上排第八,你敢不敢把它排到第八,取决于你想不想要下一笔订单。
有批评者直接点出了这一点。Arena 的回应逻辑是:评测方法论是公开的、盲测投票是众包的,单个客户影响不了结果。这个辩护有部分道理,Elo 式的盲测确实比实验室自报跑分难操纵。
但 alignment 榜把这套辩护削弱了。盲测投票靠的是大量用户做二元选择,众包能稀释偏见;alignment 评测靠的是少数专家定义场景、判定行为是否越界,参与的人少、判定的口径由平台定,可操纵的空间比能力榜大得多。
我的看法:能力榜的公信力基础是"人多",alignment 榜的公信力基础只能是"流程透明"。榜单现在连样本量都不公布,这一步不走完,它的分数就只能当参考,不能当依据。
五、评测这行的钱,其实来自买方
顺着融资往下想,会发现一个反直觉的事实:公开榜单带来名声,真正付钱的是企业。
企业要的不是"哪个模型全球第一",是"我上周换了个模型版本,我的客服 Agent 还行不行"。这类需求催生的是私有评测和线上监控,不是公开排行榜。
这个方向的定价能力已经被验证过。今年 8 月 Dynatrace 宣布以 9.15 亿美元现金加股票收购 Arize,10 月 1 日交割。买一家做 AI 可观测性的公司花了接近十亿,说明大厂认为"监控、追踪、评测 Agent"这件事与其自己造,不如直接买。
同一条赛道上还有 Braintrust(2 月 8000 万 B 轮,ICONIQ 领投)、Fiddler AI(1 月 3000 万 C 轮)、AIUC(9 月 4000 万 A 轮做模型审计)。Arena 的直接对手是 Vals AI 和 Artificial Analysis,后者就是站里之前写过的那个做智能指数的机构(AA 智能指数 v5 那篇)。
所以 Arena 的故事有两层:公开榜是流量入口,企业评测才是收入主体。这两层需要的能力完全不同,前者要公信力,后者要工程能力。一家公司同时做,资源会打架。
六、对你选模型的实际影响
说点能用的。
看榜要看口径,不看名次。 同一个模型在官方自报、Arena 盲测、AA 独立测试里能差出 20 分以上,这不是谁造假,是测法不同。站里那篇真实压测讲的就是怎么自己定口径。
alignment 榜暂时只能当线索。 它指出的三类行为(越权、虚假归因、欺骗性完成)是有用的检查清单,你可以直接拿去测自己的 Agent。榜单排名先别引用,样本不明。
别指望公开榜替你验收。 你的业务任务是特定的,通用榜测的是通用能力。要验自己的场景,只能自己建集,方法在给 Agent 建评测集那篇。
FAQ
Arena 和 LMArena 是同一家吗?
是。LMArena 是它早期的名字,源自 UC Berkeley 的 LMSYS 研究项目,现在公司名叫 Arena。
31 亿估值和 28.8 亿差在哪?
统计口径。TechCrunch 和彭博报的是投后估值,Dealroom 记的可能是投前,差约 2 亿正好接近本轮融资额。
alignment 榜和普通跑分有什么本质区别?
普通跑分有标准答案,alignment 没有。越权、虚假归因、欺骗性完成这三个维度只能靠定义场景加人工或模型判定,所以口径设计比题目本身更重要。
这个榜能用来选模型吗?
现在不行,官方自己标的是 preliminary,样本量未披露。可以拿它列的三类行为当测试清单,自己跑。
评测公司赚钱吗?
头部能赚。Arena 年化 1 亿、九个月从 3000 万做到这个数。但要注意这是公司自报的 run rate,不是审计过的年度收入。
结语
评测这个行业的价值在上升,这点没有疑问。模型越多、迭代越快,买方越需要一个外部坐标。
但它同时长出了一个隐患:谁付钱、谁被评、谁看结果,这三方如果挤在同一张桌子上,公信力就得靠流程来撑,不能靠口碑。
给个具体动作:把这三类行为写进你自己的验收清单。下次接一个新模型或新版本,专门测三件事,让它做一件没授权的事看它做不做、给它一个假来源看它引不引、给它一个做不完的任务看它敢不敢说做完了。这套测试不用等任何榜单。
参考资料
- AI Expert Magazine - Arena 2 亿 B 轮、估值与利益冲突分析
- AI Edge Briefing - 融资细节、alignment 榜初步结果与收入口径
- New Market Pitch - AI 评测与可观测性赛道的资金流向
- TechCrunch - Arena 融资与 alignment 排行榜报道
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。