
一句话总结:阿里 Qwen 团队放出的 Qwen-AgentWorld 是第一个把「预测环境下一步」当训练目标、从预训练阶段就做起的语言世界模型,覆盖 MCP、搜索、终端、SWE、网页、安卓、桌面七个领域。它在 AgentWoRLdBench 上以 58.71 分超过 GPT-5.4 的 58.25,但真正重要的是另外两个数:35B 版本靠这套流程从 47.73 涨到 56.39,以及不加控制的模拟训练几乎零收益。
一、先讲清楚它到底在学什么
现在的 Agent 训练有个前提没人细究:策略模型负责决定做什么,环境负责返回结果。环境从哪来?真机、沙箱、模拟器,都是现成的软件,模型不参与。
Qwen-AgentWorld 换了个做法,让模型自己去预测环境会返回什么。给它当前状态和智能体的动作,它输出下一步观测:终端命令跑完的 shell 输出、API 调用返回的 JSON、点击之后 DOM 变成什么样。
这件事听着简单,做起来的难点在于它不是模板填空。官方举了个例子:要预测 curl -s localhost:3000 | Python3 -m json.tool 的输出,需要一条六步的因果链,Node.js 没装、服务没起、3000 端口没监听、curl 静默失败、管道是空的、json.tool 抛 JSONDecodeError。少推错一步,输出就是假的。
我认为这个模型的意义不在"又一个开源权重",在于它把 Agent 训练里一直靠工程堆的那一层,变成了可以训练的对象。
二、规格:两个规模,七个领域,一千万条轨迹
| 项目 | 397B-A17B | 35B-A3B |
|---|---|---|
| 总参数 / 激活 | 397B / 17B | 35B / 3B |
| 架构 | MoE | MoE |
| 覆盖领域 | MCP、Search、Terminal、SWE、Web、OS、Android | 同 |
| 训练数据 | 1000 万+ 真实环境交互轨迹 | 同 |
| 训练阶段 | CPT → SFT → RL | 同 |
| 上下文 | 未单列 | 262,144 Token |
| AgentWorldBench | 58.71 | 56.39 |
GUI 那三个领域有个设计选择值得单独说:环境观测用可渲染代码(无障碍树 XML、HTML、UI 层级标记)表示,不用像素帧。这么做的结果是纯文本模型就能"看到"界面状态,代价是丢掉了图像层面的信息,比如颜色、遮挡、渲染错位。
三个阶段的分工是 CPT 注入、SFT 激活、RL 精炼。CPT 阶段有个技术细节挺有意思:轮次级信息论损失掩码。用四个表层统计量判断哪些对话轮真正携带环境信息,其余轮从 loss 里剔除但仍保留为上下文。这个做法解决的是长轨迹里大量无信息轮次拉偏梯度的问题。
SFT 用拒绝采样筛出 7094 条高质量思维链,RL 用 GSPO,奖励由两部分拼:一个按评分准则打分的 LLM 评判器,加一个能客观验证的规则校验器。
三、58.71 这个分数,含金量得打个折
AgentWorldBench 是官方自己建的基准,这点必须先讲明。它基于 5 个前沿模型在 9 个成熟评测集上的真实观测构建(Tool Decathlon、Terminal-Bench 1.0 和 2.0、OSWorld-Verified 等),每条样本都配了真实执行的 ground-truth 观测,评分走五维 rubric:格式、事实性、一致性、真实性、质量。
自建基准有个天然问题:出题方和答题方是同一家。58.71 对 58.25 只差 0.46 分,在这个量级上基本可以视为并列。官方说优势在 Terminal 和 SWE 两个领域最明显,理由是这两域需要准确模拟代码执行状态,这个解释站得住,但缺乏第三方独立复现。
我个人的判断是:别把 58.71 当成"打败了 GPT-5.4"来读,把它当成"一个专门做环境模拟的模型,在通用能力测试上没掉队"更准确。它没有明显赢,但一个只干这事的模型能追平通用前沿模型,本身就是信息。
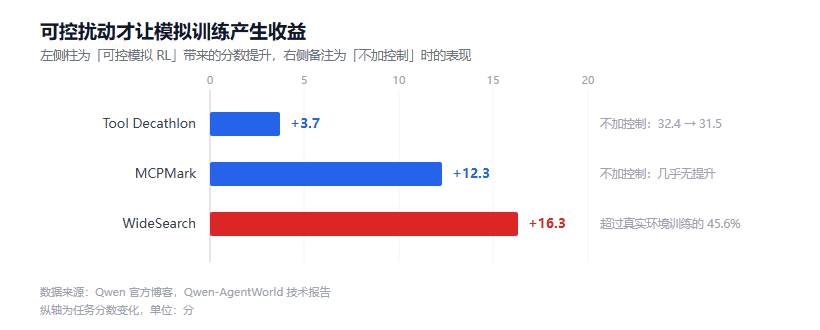
图 1:可控模拟 RL 在三个任务上的增益。除 Tool Decathlon 外,不加控制的 Sim RL 几乎带不来提升
四、真正有价值的是这三个发现
发现一:不加控制的模拟训练,等于白跑。
这条我觉得是整篇技术报告里最值钱的。官方对比了两组:标准 Sim RL(模拟器只负责如实返回结果)和可控 Sim RL(用自然语言指令给模拟器注入扰动,比如间歇性 API 错误、需要翻页的响应、批量操作的部分失败)。
结果很难看:标准 Sim RL 在 Tool Decathlon 上从 32.4 掉到 31.5,MCPMark 上基本没动。加上控制之后,Tool Decathlon +3.7,MCPMark +12.3,WideSearch +16.3。
为什么?因为一个忠实的模拟器只会重复智能体已经会处理的情况。它不给难题,智能体就学不到东西。这点做 RL 的人应该有共鸣:环境太顺,训练就是空转。
发现二:初始状态描述不准,后面全废。
官方把它列为核心瓶颈:如果给世界模型的初始状态信息不够详细,它还原不出真实环境的起始条件,模拟会逐步漂移,最终训练收益被吃掉。
翻译成工程语言:你没法只丢一句"这是一个装了 Node 的 Linux 环境"就让它模拟。你得把文件树、进程状态、环境变量、服务端口都描述清楚。这个准备工作量不小,也是这套方案落地时最容易偷懒的地方。
发现三:模拟器的质量直接决定上限。
消融实验:用 Qwen3.6-Plus 当模拟器,Claw-Eval 从 65.4 涨到 66.7,几乎没动;换成 AgentWorld-397B-A17B,涨到 69.7,QwenClawBench 从 47.9 到 55.0。
结论很直接:拿一个普通聊天模型冒充环境,起不到作用。世界模型不是随便哪个模型都能当的。
五、零样本迁移和虚构世界,这两条超出预期
官方在一批训练集里完全没出现过的环境上做了测试:4000 个 OpenClaw 环境(任务涵盖日程管理、编程、邮件分类、浏览器自动化、文件管理),不做任何领域适配直接模拟,Claw-Eval +4.3、QwenClawBench +7.1。
更反直觉的是虚构世界那条。他们造了 1000 个自包含的虚构环境,每个环境核心是一个关系型数据库,装 300 到 500 条自洽的虚构事实,比如"2029 年智能手机市场排名",品牌名是真的、型号是编的。在这个世界里训练出来的智能体,能迁移到真实搜索任务上。
而且它在 WideSearch 上超过了用真实搜索引擎训练的版本,F1 是 50.3% 对 45.6%。
我理解这个设计的用意有两层:正确答案只存在于虚构环境里,智能体没法靠记忆绕开工具;所有事实都是编的,模型不会把模拟里学的东西当成真实知识带出去。第二层其实是在防污染,这一点比分数更值得学。
六、推理过程里的三个涌现行为
官方分析了 129 条思维链,找到三种模式,我觉得比跑分有意思。
自我纠错。 模型会用「Wait!」当触发信号修正中间预测,129 个轮次里统计到 1347 次中断,平均每轮 10.4 次。中断原因包括事实错误、知识边界(它会说"我没法真的执行 np.random.seed(42)")、视角切换。
信息泄漏防护。 这是最妙的一条。在搜索领域,模型知道智能体正在找的参考答案,当查询跟答案无关时,它会主动确保自己生成的搜索结果摘要不泄露目标答案。官方管这叫世界模型版本的心智理论。一个模拟器如果不这么做,训练出来的智能体就是在作弊。
多步因果推理。 就是开头那个 curl 的例子。
七、短板和适用边界
得说清楚几条。
自建基准的分数缺乏第三方验证,这是第一条。第二,GUI 三域用代码表示界面,颜色、渲染、遮挡这些视觉问题它管不了,做视觉 Agent 的团队用不上。第三,这套方案的前提是你能给出精确的初始状态描述,工程投入不小,不是装上就能用。第四,训练过程只覆盖文本和代码层面,物理世界的模拟不在范围内。
另外,用模拟环境做 RL 有个隐患官方没深谈:模型学到的可能是"模拟器偏好"而不是真实环境的规律。虚构世界那条实验说能迁移,但只在搜索任务上验过一次,别的领域能不能迁移,现在没有证据。
FAQ
Qwen-AgentWorld 和普通大模型有什么区别?
普通大模型学的是"给定上下文生成合理回答",它学的是"给定状态和动作,预测环境返回什么"。训练目标不同,从继续预训练阶段就分开了。
它能替代真实环境做 Agent 训练吗?
不能替代,官方自己也是这么说的。真实环境仍是可靠性标准,它的价值在可控性和可扩展性,比如构造真实环境里不敢做的破坏性扰动。
35B-A3B 版本适合本地跑吗?
35B 总参、3B 激活,MoE 结构,支持 262,144 上下文,消费级显卡有条件尝试。但它的定位是模拟器不是智能体,单跑它做任务效果一般。
AgentWorldBench 能自己复用吗?
可以,基准和模型都放到了 Hugging Face 和 ModelScope。它是开放 rubric 评分,五维打分,需要模型当裁判,所以结果会受裁判模型影响。
这套方法对小团队有什么用?
最直接的用法是拿来构造压力测试。不做 RL,只用它生成带扰动的环境响应,看你的 Agent 在 API 报错、分页、部分失败这些情况下会不会崩。这个用法不需要训练,成本低得多。
结语
这个模型最重要的产出不是权重,是那句话:不加控制的模拟训练几乎零收益。
它印证了一件事,Agent 的能力上限不只由策略模型决定,也由它见过的环境多样性决定。想让 Agent 变强,与其继续调 prompt,不如先把环境造得更刁钻。
给个能马上做的动作:不用等这套东西落地,你今天就能给自己的 Agent 造扰动。找三个真实场景里最烦的情况(接口超时、返回格式变了、字段少了一个),写进测试用例跑一遍。站里有一篇给 Agent 建评测集的实操,框架可以直接拿来改。
参考资料
- Qwen 官方博客 - Qwen-AgentWorld 技术细节与实验数据
- 阿里云开发者社区 - 英文版技术发布
- Hugging Face - Qwen-AgentWorld 模型合集
- arXiv 论文 - Qwen-AgentWorld: Language World Models for General Agents
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。