
一句话总结:逆向里最高频的第一步不是找算法,是把被混淆的字符串还原出来。单字节 XOR 的解法很朴素,256 次尝试加一个打分函数,正确 key 拿 340 分、第二名 214 分,判定可以自动化。但同一套思路套到多字节 key 上会翻车:分组爆破快 128 倍,解出来的却是错的,而且看不出错在哪。
一、先说场景
拿到一个程序,配置文件、日志、字符串表里全是被混淆的字节,肉眼看不到任何可读内容。这是逆向最常见的开局。
混淆手法里最简单也最常见的一类是单字节 XOR,整个字符串每个字节都跟同一个数异或。它算不上加密,但在挡 grep、挡字符串搜索这件事上很有效,成本又几乎为零,所以到处都是。
这篇自己做样本、自己破。为什么造样本:手上有真样本才能知道答案对不对,这对写破解脚本很重要,不然你以为跑通了其实是跑到沟里去了。
二、前置条件
Python 3.9 以上,标准库。脚本 114 行,标准库就够。
样本是一段 JSON 配置,明文 114 字节,用 key=0x5A 做单字节异或,再 base64 编码成字符串。研究真实样本时这一步换成正则从二进制里切常量段,逻辑一样。
PLAIN = json.dumps({
    "endpoint": "http://API.internal.example/v2/sync",
    "user": "svc_backup",
    "password": "P@ssw0rd_2026",
    "retry": 3,
}, ensure_ascii=False).encode("utf-8")

REAL_KEY = 0x5A

def enc(data, key):
    return bytes(b ^ key for b in data)

CIPHER_B64 = base64.b64encode(enc(PLAIN, REAL_KEY)).decode()
三、核心是那个打分函数,不是爆破本身
爆破毫无技术含量:key 从 0 到 255 试一遍,一共 256 次。
真正决定成败的是怎么判断"这个 key 解出来像不像人话"。绝大多数人第一次写这个都会栽在这。
我的打分函数三条规则:
PRINTABLE = set(bytes(string.printable, "ascii"))
COMMON = (b"http", b"user", b"pass", b"json", b"key", b"Token",
          b"{", b"}", b":", b"retry", b"api")

def score(plain):
    if not plain:
        return -999
    s = int(sum(1 for b in plain if b in PRINTABLE) / len(plain) * 100)
    low = plain.lower()
    for kw in COMMON:
        if kw in low:
            s += 30
    if plain.count(b" ") / len(plain) > 0.3:
        s -= 20
    return s
第一条是可打印字符占比,权重最高,因为异或错一个 bit 就会产生一堆控制字符。第二条是关键词命中,这条才是真正拉开差距的地方:http、{、: 这些符号在文本里出现,几乎不可能是巧合。第三条是反向惩罚,空格过多的通常是乱码。
顺序不能反。如果先靠关键词,短字符串上会误判;如果只靠可打印比例,全角标点和中文会一起被吃掉。
四、跑起来是什么样
密文长度 114 字节,base64 前缀 IXg/ND4qNTM0LnhgengyLi4qYHV1Oyoz...

Top 5 候选 key:
  key=0x5A ( 90)  得分= 340  {"endpoint": "http://api.internal.ex
  key=0x7A (122)  得分= 214  [ENDPOINT  HTTPAPIINTERNALEX
  key=0x4F ( 79)  得分= 190  n7p{qez|{a7/57}aae/::te|;|{apg{ty;pm
  key=0x42 ( 66)  得分= 190  c:}v|hwqvl:"8:pllh"77yhq6qvl}jvyt6}`
  key=0x4E ( 78)  得分= 189  o6qzpd{}z`6.46|``d.;;ud}:}z`qfzux:ql

选中 key=0x5A,得分 340,与真实 key 一致
解析成功,字段: endpoint, user, password, retry
正确 key 340 分,第二名 214 分,差 126 分。这个差距意味着不需要人工看,脚本可以自己判。
有意思的是第二名。0x7A 把整段解成了大写,[ENDPOINT HTTPAPIINTERNALEX。这也是可打印字符,比例同样是 100%,但一个大小写都不对、找不到标点的串,得分只有正确解的六成。
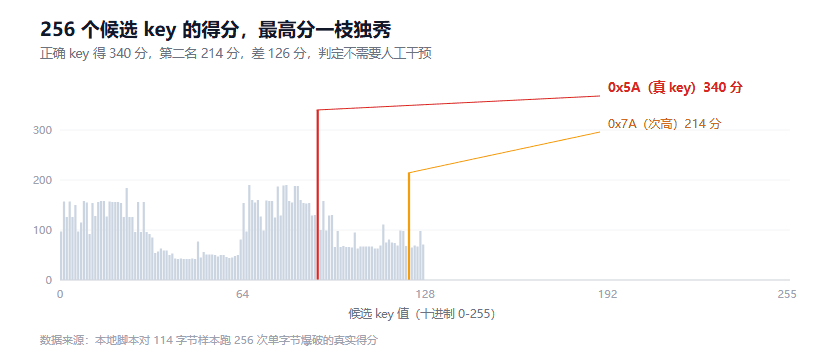
图 1:256 个候选 key 的真实得分。红柱 0x5A 是正确答案,橙柱 0x7A 是次高的那个"看着像但其实错"的解
五、验证比判定重要
这段是我认为整篇最该记住的:"看起来像人话"不等于"解对了"。
所以我加了一步结构化校验,解出来的东西必须能被 JSON 解析,字段名还得对得上预期:
plain = enc(raw, best_key)
cfg = json.loads(plain)          # 解析不了直接抛异常
print("解析成功,字段:", ", ".join(cfg))
print("endpoint =", cfg["endpoint"])
解析成功再取字段,取字段不报错,这两步过了才算解对。如果只靠打分排名,遇到键值都短、特征弱的样本,脚本会自信地给你一个错的答案。
真实样本里这条更重要:配置文件通常是 JSON 或 INI,走解析器比对着屏幕看靠谱一百倍。二进制段没有结构怎么办?找其中像 URL、像文件路径的片段做交叉验证。
六、多字节 key:一条会骗人的捷径
单字节破完很容易上头,觉得多字节就是同一个套路套两遍。我试了,翻车了。
常规做法叫分组爆破:假设 key 是两字节循环,把密文按奇偶位置切成两段,每段单独爆破,复杂度从 65536 降到 512,快 128 倍。
--- 两字节重复 key:两种打法对比 ---
真实 key: ['0x3C', '0xA7']
分组法解出: ['0x29', '0xBF'] -> 不一致 | 正文对得上: False
  位置 0:片段长度 57,最高分 190,key 0x29
  位置 1:片段长度 57,最高分 190,key 0xBF
联合法解出: ['0x3C', '0xA7'] -> 一致 | 正文对得上: True | 得分 340
打分次数:分组法 512 次,联合法 65536 次
分组法解错了,而且错得很有欺骗性:它每一段都自信地给出了 190 分的"最优解",如果你只看分数不看结果,会以为成了。
原因不难想。切成交错的两段以后,第 0 段是明文的第 1、3、5、7 个字节,第 1 段是第 2、4、6、8 个字节,两段都是被打散的碎片。打散之后 http、{ 这些连续特征全部消失,关键词加分这个最有力的信号直接失效,只剩下"可打印比例"这一个弱指标。弱指标在 256 个候选里分不出高下,随便一个都行。
联合法就是老老实实跑 65536 个组合,每个组合解出完整明文再打分。慢,但完整明文里关键词特征还在,判别力完全不是一个级别。
我现在的做法是:先分组法跑一遍拿到候选,再用联合法在候选附近做确认,两边结果不一致就以联合法为准。纯分组法的结论不能直接信。
七、坑清单
按踩到的概率排。
1. 只靠可打印比例打分,短字符串上永远解错。 密文不到 20 字节时,能解出可打印结果的不止一个 key,比例指标分不开。这种情况必须上关键词或者结构化校验。
2. 分组爆破用在文本上。 就是上一节那个坑。分组法的前提是"每段数据足够长且特征独立",文本被打散以后这个前提不成立。它适合的是纯随机数据,比如加密后的二进制负载。
3. 解出来就直接用,不做结构化校验。 我第一版就犯了这个,脚本报了最优解,我照着抄进报告,后来发现字段名少了一个字母。加一行 json.loads 就能挡住。
4. 用 latin-1 解码看结果,把中文全吃掉。 样本里有中文的话,decode("latin-1") 不会报错但会把多字节字符拆成乱码,看着像是 key 错了。预览用 utf-8 加 errors="replace",能看到替换符就知道是编码问题不是 key 问题。
5. 忘了有些混淆是"每字节 key 递增"。 不是固定 key,是 b ^ (k + i) 这种。这种情况 256 次爆破全会失败,但得分最高的那个通常能把前几个字节解对,看到"解出前半段、后半段越来越乱"这个现象,就该换思路试递增了。
八、边界
这套方法的适用范围明确:单字节或短周期重复 key 的 XOR 混淆。
碰到 AES、RC4 这些真加密,打分爆破完全无效,只能去动态调试拿密钥。碰到带压缩的负载,得先解压再打分。
还有一种情况我暂时没解:混淆后的数据被切成多段、每段用不同的 key。这时候需要先做相似度聚类,把同 key 的段归到一起,工作量是另一个量级。
站里之前写过协议逆向讲怎么从抓包还原签名,讲的是参数怎么拼;这篇处理的是字符串怎么还原,两件事在同一个流程里前后脚发生。PE 结构那篇的导入表分析则决定了你从哪个函数的附近去找这些常量。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。