
一句话总结:PenguinHarness 把 Agent 的全部配置放在文件系统里,提示词、技能、记忆都是文件,框架只负责把文件拼成可运行的 Agent 对象。我照着这个思路写了 60 行代码复刻一遍:一个 Agent 的全貌只有 5 个文件、628 字节、装配后 61 token。复制目录就是造新 Agent,代价是副本会分叉。
做 Agent 做到一定阶段,都会撞上同一堵墙:你的 prompt 已经改到第七版,但没人记得第一版为什么被推翻。
我这边就有这个毛病。MEMORY.md 改了十几次,每次改完就覆盖,想回溯只能翻对话记录。工具脚本也是,publish_online.py 从 200 行涨到 600 行,中间删过哪些校验、为什么删,全在脑子里。
PenguinHarness 的作者郑耀威(LlamaFactory 那个)给的解法很朴素:把 Agent 拆成文件,文件系统当唯一真相来源。
我看到这句的时候愣了一下,因为它听起来太简单了。但仔细想,简单的地方正是它值钱的地方。
一、PenguinHarness 的核心主张:文件就是 Agent
原文的说法是四句话:
- Agent 是文件,提示词是文件,对话历史也是文件
- 框架只负责把文件拼装成可运行的 Agent 对象
- 构造一个新 Agent,就是文件的复制粘贴
- 运行时用 PenguinMessage 作为唯一消息协议
我第一次读到"对话历史也是文件"的时候,觉得这不就是把 context 存盘吗。后来才想明白区别:存盘是为了下次读,文件化是为了让人和 Agent 能改同一份东西。
存盘的 context 是个黑盒 blob,你没法 diff 它。文件化的 context 是一堆 markdown,你能 git diff,能 code review,能回滚到上周三。
这个区别决定了后面所有的用法。
二、用 60 行代码复刻 Agent 的装配过程
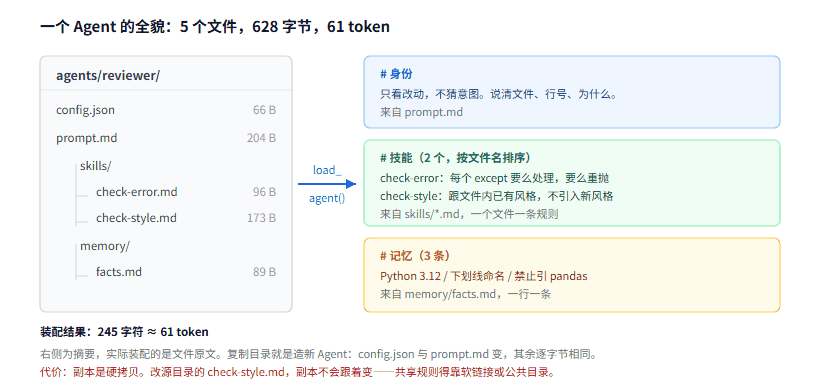
图 1:左边是文件,右边是装配出来的上下文。中间只有一个 loader
我的实现只保留了三个东西:消息协议、Agent 目录、装配函数。
消息协议用 dataclass,字段就五个:
@dataclass
class PenguinMessage:
    role: str            # user / agent / tool
    content: str
    sender: str = "user"
    receiver: str = ""
    ts: float = field(default_factory=time.time)
加载一个 Agent,就是把目录读成对象:
def load_agent(home: Path) -> Agent:
    cfg = json.loads(_read(home / "config.json") or "{}")
    skills = {f.stem: _read(f) for f in sorted((home / "skills").glob("*.md"))}
    memory = {}
    for line in _read(home / "memory" / "facts.md").splitlines():
        line = line.strip()
        if line.startswith("- ") and ":" in line:
            k, _, v = line[2:].partition(":")
            memory[k.strip()] = v.strip()
    return Agent(name=cfg.get("name", home.name),
                 prompt=_read(home / "prompt.md"),
skills=skills, memory=memory, config=cfg, home=home)技能是一个文件一条规则,文件名就是技能名。记忆是一行一条,- 键: 值 的格式。
装配就是字符串拼接,没有任何魔法:
def assemble(self) -> str:
    parts = [f"# 身份\n{self.prompt.strip()}"]
    if self.skills:
        parts.append("# 技能")
        for k, v in self.skills.items():
            parts.append(f"## {k}\n{v.strip()}")
    if self.memory:
        parts.append("# 记忆\n" + "\n".join(
            f"- {k}: {v.strip()}" for k, v in self.memory.items()))
    return "\n\n".join(parts)
整段代码里没有一个 if 是关于"这个 Agent 是什么角色"的。 角色在 prompt.md 里,规则在 skills 里,事实在 memory 里。代码只负责搬。
三、Agent 装配出来只要 61 token
跑出来的数字比我想的小。
一个能用的代码审查 Agent:
agents/reviewer/
├── config.json          66 B
├── prompt.md           204 B
├── skills/
│   ├── check-error.md   96 B
│   └── check-style.md  173 B
└── memory/
    └── facts.md         89 B
5 个文件,628 字节。装配后 245 字符,按字符除以 4 估,约 61 token。
这个数字值得停一下。 我们平时往 system prompt 里塞的东西动辄几千 token——角色设定、输出格式、注意事项、few-shot 示例。而"这个 Agent 是谁"最核心的部分,可能 60 token 就够了。
多出来的那些 token 在干什么?大部分在做两件事:一是防模型乱来(重复强调同一个约束三遍),二是把不该常驻的东西常驻了(只在特定场景用的规则,每次对话都带着)。
文件化能治第二件事:技能按需加载。你可以只把当前任务相关的 skill 文件拼进去,其余不动。
这件事上下文压缩那篇量化过:30 轮会话里,滑动窗口能压到 833 token 但丢掉三分之二的约束,分层压缩保住全部约束只压到 1146 token。文件化的好处是把"该丢什么"变成显式选择,而不是让摘要器去猜。
四、复制目录就是造新 Agent,但会分叉
我测了复制。
把一个 review Agent 复制成 writer,只换 prompt.md:
def clone_agent(src, dst, new_name, prompt_patch=None):
    shutil.copytree(src, dst)
    if prompt_patch is not None:
        (dst / "prompt.md").write_text(prompt_patch, encoding="utf-8")
    cfg = json.loads(_read(dst / "config.json"))
    cfg["name"] = new_name
    (dst / "config.json").write_text(json.dumps(cfg, ensure_ascii=False, indent=2))
用 md5 对比两边:
不同  config.json            08838b96 / 4f43bc29
一致  memory/facts.md        f2291f7f / f2291f7f
不同  prompt.md              e92f0cce / cf4d046f
一致  skills/check-error.md  a81dcfe9 / a81dcfe9
不同  skills/check-style.md  b8c3779a / 2f1c6d58
前两行是预期的:名字变了,prompt 换了。第三、四行也是预期:没动的东西逐字节相同。
但注意第五行。 我在测试中间改过一次源目录的 check-style.md,结果副本没跟着变——因为 copytree 是硬拷贝。
这就是"复制即造 Agent"的代价:复制完就分叉了。
对单个 Agent 来说这是好事(互不干扰)。但如果你有 20 个 Agent 共享同一套代码规范,改一次要改 20 遍,那就不是好事了。
官方没提这个问题。我的解决办法是把共享规则放公共目录,各 Agent 用相对路径引用或者软链接。这样就变成"共享 + 特化"的混合结构:
shared/skills/        公共规则(代码规范、输出格式)
agents/reviewer/      自己特有的(只看 diff、不猜意图)
五、文件系统真正解决的问题是什么
说实话,不是省 token。
61 token 那个数字好看,但真实场景下你要加载的技能和记忆会多得多。如果把上百个 skill 全拼进去,token 一样会爆。
它真正解决的是另外三件事。
第一,改动能被 review。 prompt 从 200 行改成 220 行,git diff 能给你看加了哪 20 行。以前你只能看到"prompt 又变了"。
第二,规则可以单独测试。 一个 skill 一个文件,你可以写个脚本单独喂给它一段代码,看它触发不触发。混在一个大 prompt 里,你没法判断某条规则到底有没有生效。
第三,Agent 变成了可以被 Agent 改的东西。 这点最重要。文件是模型天然能读写的格式,Agent 想优化自己的 prompt,直接改文件就行,不需要理解某个框架的内部 API。
第三条其实就是"自进化"的技术前提。为什么 PenguiHarness 敢说自己能自进化?因为 Agent 和它的配置在同一个抽象层上——都是文件。
但自进化的难点不在改,在评
郑耀威自己在采访里说过一句话,我觉得比宣传材料里所有数字都重要:
修改 Agent 很容易,让它变好却很难。
他的解法是做评估集。团队花了半年多做了一套叫 GDPevo 的基准,覆盖医疗、金融、法律等六个场景,专门划分训练集和测试集。
理由很直接:如果自进化跑在测试集上,你分不清 Agent 是学会了还是背会了。
这个坑做评测的人都懂。但大部分人做 Agent 自优化时会忽略——你拿同一批 case 反复调 prompt,调到 95% 通过率,换一批 case 立刻掉到 60%。
所以这套东西真正难的地方是评估集的构建,不是文件系统的设计。文件系统是必要条件,不是充分条件。
六、PenguinHarness 常见问题
0.2 元建一个 Agent 是怎么算的?
这是官方宣传口径,指演示里"生成一个 RAG 应用"那个任务的 token 成本。同一个项目还有"比云代码便宜 70 倍""五次合同审查不到五美分"两种说法,场景不同、基准不同,我没找到统一的算法。建议当成营销数字看,不要当成成本预期。
它和 Claude Code、Codex 的区别在哪?
Claude Code 这类工具是"你给需求,它写代码"。PenguinHarness 是"你给需求,它生成一个新 Agent"。产出物不一样:一个是应用,一个是能被反复调用的智能体。
文件系统当真相来源,性能不会有问题吗?
读文件有开销,但相对模型推理可以忽略。真正的开销在装配:如果技能很多,每次拼上下文要扫一遍目录。我的实现是 glob("*.md") 全读,没有做按需加载,技能多了会慢。
PenguinMessage 是必需的吗?
不是。它是个约定,好处是所有组件用同一种消息格式通信,方便替换。你自己定义个 dict 也能跑,但跨 Agent 传递时容易各写各的。
能用在生产环境吗?
仓库 3000 多 star,还在早期。演示数据来自单一来源,我建议先当研究项目看。
七、边界
我只复刻了骨架,没跑完整的自进化循环。 文件装配、复制分叉、消息传递这三件事我实测了,评估驱动的自动迭代没测——那需要一整套基准和几十轮调用,成本超出这次的范围。
61 token 这个数字是我这套最小实现的,不代表官方。 官方那套还包括 hooks、工具定义、历史记录,装配出来会大得多。
"省 token"这个说法我持保留态度。 文件化确实让按需加载变得可能,但能不能省取决于你有没有做按需加载。全量拼进去,token 一分不少。
站内之前写过 Skill 的三层加载,讲的是同一类思路:把常驻的东西压缩到最小,其余按需读。 那篇讲的是 Skill 机制,这篇讲的是把整个 Agent 拆成文件,两者能对照着看。
参考资料
- 编程知识 - PenguinHarness 开源:让 Agent 自进化开箱即用
- 控场 AI - ChatGPT 自建更优 ChatGPT:开源工具 Penguin Harness 让 Agent 自我进化
- 尧图网络 - Coding Agent 能力边界横评
- 但自进化的难点不在改,在评
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。