
一句话总结:FlashProve 那类方案要改造推理、慢 90 倍,但不是所有场景都付得起。轻量做法是「可复现性校验」:固定模型版本、量化方式、seed 和参数,公布输出哈希,让别人重跑对比。代价接近零,前提是模型开源且推理确定性。难点在 GPU 浮点非确定性——一个 token 分叉,16 个 token 里 9 个会跟着变,哈希直接失效。
上一篇写了 FlashProve,它的代价让我犹豫:慢 90 倍、一份证明 19MB、只支持 1024 token。
如果我只是想确认「对面的模型有没有被偷偷换掉」,有没有更便宜的办法。
想了半天,有。而且便宜得多,只是保证弱一些。
一、先想清楚:你要验证的到底是什么
先把命题拆细。你可能想证明三件不同的事:
| 想证明的 | 严格程度 | 能不能用轻量方案 |
|---|---|---|
| 输出是某个模型生成的 | 强 | 不能,需要密码学证明 |
| 服务端没有篡改输出 | 中 | 能 |
| 服务端的参数配置没变 | 中 | 能 |
| 服务端没在高峰期偷偷降级 | 弱 | 能发现,不能证明 |
第一行是 FlashProve 干的事。后面三行,用「可复现性」就够了。
区别在于:FlashProve 证明的是「这个计算确实发生了」,可复现性证明的是「两次计算的结果一致」。
后者便宜,但需要你信任一次基线。
二、方案一:可复现性校验,成本接近零
思路很朴素:如果模型、版本、量化方式、seed、采样参数都固定,同样的输入应该产出同样的输出。
那服务端只要公布「我用的是什么配置 + 输出的哈希」,你就能自己重跑一遍对比。
import hashlib, json

def fingerprint(model_id, version, quant, seed, temperature, prompt):
    """把影响输出的所有因素拼成一个指纹"""
    payload = json.dumps({
        "model": model_id, "version": version, "quant": quant,
        "seed": seed, "temperature": temperature, "prompt": prompt,
    }, ensure_ascii=False, sort_keys=True)
    return hashlib.sha256(payload.encode()).hexdigest()

def output_hash(text: str) -> str:
    return hashlib.sha256(text.encode()).hexdigest()
服务端每次响应带上两组哈希:一个是配置指纹,一个是输出哈希。
你拿到之后,用同样的配置跑一遍,比对两个哈希。
全部对得上,说明配置没变、输出一致。
这个方案的成本是多少?算一次 sha256,微秒级。相比 FlashProve 的 9 秒证明和 17 秒验证,成本差六个数量级。
三、复现难点:GPU 浮点让可复现变得不确定
这里有个坑,很多人不知道。
同一个模型、同样的输入、temperature=0,在 GPU 上跑两次,输出可能不一样。
原因是浮点运算不满足结合律:(a+b)+c 和 a+(b+c) 的结果在浮点下可能差末位。而 GPU 的并行归约顺序取决于线程调度,不同 batch 大小、不同 batch 内位置,归约顺序都不同。
差多少?量级在 1e-4 到 1e-5。
听起来无关紧要,但下一步就致命了。
四、一个 token 分叉,哈希校验就全变
模型选 token 靠的是 argmax(temperature=0 时)。如果两个候选的 logit 只差 2e-4:
原始:  [8.4213, 8.4211, 3.2, ...]  -> 选第 1 个
扰动:  [8.4213, 8.4214, 3.2, ...]  -> 选第 2 个
3e-4 的扰动,翻转了 2e-4 的差距。
一旦第 6 个 token 变了,后面全变。因为自回归的每一步都依赖已生成的序列。
我写了个模拟验证这件事,用中文词表跑 16 个 token:
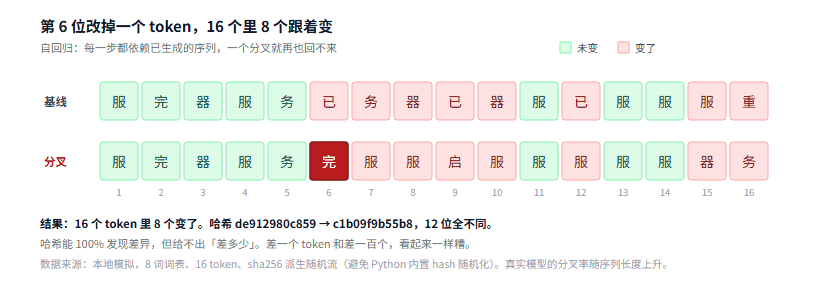
图 1:第 6 位改掉一个 token,后面 10 个位置里有 8 个跟着变了
基线:   服完器服务已务器已器服已服服服重
第 6 位: 服完器服务完服服启服服服服服器务
16 个 token 里只有 8 个和基线相同,8 个变了,整整一半。
哈希对比:
基线哈希: de912980c859
分叉哈希: c1b09f9b55b8
12 位全不同
这个结果说明两件事。
好消息:哈希对差异极其敏感,一个 token 变了绝对跑不掉。
坏消息:它也给不出「差多少」的信息。差一个 token 和差一百个 token,哈希看起来一样糟。
五、方案二:加一层元数据承诺
纯哈希的问题是「对不上时不知道原因」。加一层元数据能缩小排查范围。
做法是让服务端在推理之前先公布承诺:
def commitment(model_id, version, quant, seed, prompt_hash, ts):
    """推理前的承诺:先说我打算用什么配置跑"""
    payload = f"{model_id}|{version}|{quant}|{seed}|{prompt_hash}|{ts}"
    return hashlib.sha256(payload.encode()).hexdigest()
流程变成三段:
- 请求发出,服务端回一个
commitment(此时还没生成内容) - 服务端推理,返回输出 +
output_hash - 你把 commitment、配置、输出一起校验
承诺在前的意义是:服务端不能事后改口径。 如果它先说用 A 配置,跑完发现不对改成 B,承诺的哈希就对不上。
这比「事后公布配置」强一档。虽然还是不能证明「真的用了那个模型」,但能证明「说过的配置没变过」。
六、两种验证方案怎么选
我把三条路放一起对比:
| 方案 | 能证明什么 | 成本 | 前提 |
|---|---|---|---|
| FlashProve | 输出确实来自模型 M | 慢 90 倍,19MB/次 | 需改造推理、整数模型 |
| 可复现校验 | 两次输出一致 | 微秒级 | 模型开源、确定性推理 |
| 承诺 + 哈希 | 配置没被事后篡改 | 微秒级 | 服务端配合 |
选法很直接:
做合规审计、司法取证,用 FlashProve。贵,但结论确定。
自己部署、想监控有没有跑偏,用可复现校验。你控制模型,只需要一个报警器。
用第三方 API、想确认对方没临时降级,用承诺 + 哈希。这是唯一能在不信任对方的前提下做点什么的方案,虽然只能发现问题,不能定性。
站内之前写过 从 token 时间戳反推推理配置,那是纯黑盒推测。这篇的两个方案都需要服务端配合——这就是可验证性的根本困境:想验证,就得对方愿意被验证。
七、边界
可复现校验证明不了「用的是哪个模型」。 它只能证明「两次一样」。如果服务端从一开始就用小模型,而且一直不换,你的校验会永远通过。这是它和 FlashProve 的本质差距。
GPU 非确定性我用模拟演示,没有真机验证。 真实的差异量级取决于显卡型号、CUDA 版本、batch 大小、是否用了 flash attention。有的配置能做到完全确定,有的不行。要确认你的环境,只能实测。
16 个 token 的模拟样本很小。 分叉率 56% 这个数字会随序列长度变化——序列越长,分叉累积越明显。真实场景下 1000 token 的输出,分叉率可能接近 100%。
承诺机制依赖服务端诚实执行。 如果服务端先把所有可能的 commitment 都算好,再挑一个用,这套机制就失效了。要防这个,需要可信时间戳或者链上存证,成本又上去了。
这套方案对闭源模型基本无效。 你没法重跑,只能信服务端的哈希。这时候哈希的作用只剩「同一请求两次结果一致」,连配置对不对都验不了。
还有一个我没解决:基线从哪来。 第一次比对时手上没有可信参照。如果第一次拿到的就是被篡改的结果,后面所有校验都在错误的基线上做。要解决得靠外部锚点,超出本文范围。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。