
一句话总结:BashReliability 这个指标量的是「Agent 生成的命令能不能跑通」。我拿 20 条命令实测了一遍:按退出码算,13 成 7 败,得分 +30%;把「退出码 0 但语义已经变了」的 5 条也算进去,只剩 +5%。同一个 Agent,两种口径差 25 个百分点。问题在于退出码只告诉你「没报错」,不告诉你「做对了」。
Kimi K3.1 Pro 那批数据里,最让我在意的是 BashReliability 从 -4.5% 提到 +7.9%。
一个指标能从负数涨到正数,说明它衡量的是某种「及格线」以上的东西——不是「好一点」,是「从不行到行」。
我想知道这个指标具体怎么算,所以自己搭了一套。
一、BashReliability 这个指标在量什么
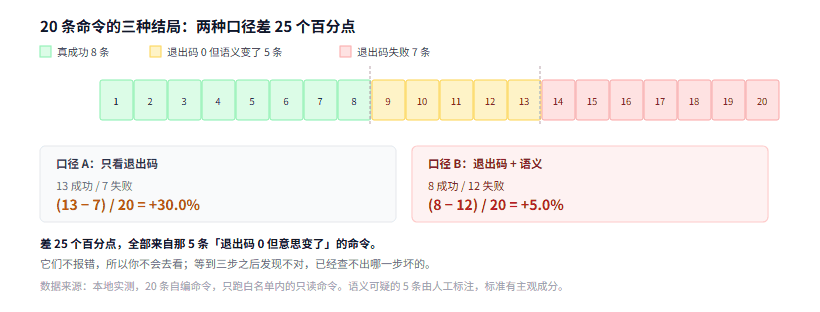
图 1:同样 20 条,按退出码算和按语义算,得分差 25 个点
先说定义。我从材料里能确定的是:它有正负,负数表示比基准差。
按这个特征,合理的定义是:
Reliability = (成功数 - 失败数) / 总数范围 -100% 到 +100%。全成就是 +100%,全败是 -100%,成败各半是 0。
Kimi 的 K3 是 -4.5%,意味着失败略多于成功。K3.1 Pro 是 +7.9%,成功略多于失败。
这个指标衡量的不是「命令写得好不好」,是「给一个任务,Agent 生成的命令有几条能直接跑」。
在真实工作里,这条线很关键。Agent 说要查日志,给你一条 grep,报错;再给一条,又报错。你得一条条看、一条条改,还不如自己敲。
二、20 条命令,一半对一半埋了坑
我造了 20 条模拟 Agent 输出的命令。一半是对的,一半埋了常见的坑。
安全约束先说:只跑只读命令,删文件、改系统的一律不执行。白名单里是 ls、pwd、echo、cat、grep、wc、head、find、python -c 这些。
判定的核心就三行:
def run(cmd):
    r = subprocess.run(cmd, shell=True, capture_output=True, timeout=8)
    return r.returncode, r.stderr.decode("utf-8", "ignore").strip()

success = (code == 0)
跑完,20 条里 13 条成功、7 条失败。
失败原因分布:
| 原因 | 条数 | 占比 |
|---|---|---|
| 路径不存在 | 2 | 29% |
| 其他 | 2 | 29% |
| 参数拼错 | 1 | 14% |
| 类型错误(对目录用 wc) | 1 | 14% |
| 环境不对(非 git 目录跑 git) | 1 | 14% |
按公式算:(13 - 7) / 20 = +30.0%。
这是一份「还过得去」的成绩单。比我预期的高。
三、按退出码算,+30%
+30% 意味着什么?
在这个口径下,Agent 生成的命令十条里有六条半能跑通。对日常任务来说勉强可用——你得盯着,但不至于全废。
但这个数字有个大问题:它把「没报错」当成了「做对了」。
我给那 20 条命令做语义检查的时候,发现了 5 条这样的:
grep -n 'def' tools/seo_check.py --line-number   重复参数,靠容错跑通
head -n -5 tools/seo_check.py                    负行数语义变了(变成除末尾 5 行)
python -c "print(1+1)" --verbose                 多余参数被静默忽略
find tools -name *.py                            通配符被 shell 提前展开,语义已变
echo $UNDEFINED_VAR                              变量未定义,静默输出空
这 5 条的退出码都是 0。工具不认为它们错了。
但它们全都不是你以为的那个意思。
四、把语义可疑的也算上,只剩 +5%
同样的 20 条,换个口径:
真实成功 = 13 - 5 = 8 条
失败 = 7 条
严格得分 = (8 - 7) / 20 = +5.0%
+30% 变成 +5%。同一个 Agent,同一批命令,差 25 个百分点。
这 25 个点就是「静默错误」的代价。
它的危害比报错大得多。报错你会去看;静默错误你不看,直接当成功了继续往下走。等到三步之后发现不对,已经查不出是哪一步坏的。
这和我之前写过的 Agent 三件坏事是同一个病:谎报完成。
五、为什么退出码靠不住
三条原因。
第一,工具本身在容错。 grep 允许重复给参数,head -n -5 是合法语法(表示除末尾 5 行),python -c 后面的多余参数会被当成 sys.argv 的一部分而不是报错。这些设计在命令行时代是体贴,在 Agent 时代是坑。
第二,shell 会替你做决定。 find tools -name *.py 里的 *.py 如果不加引号,shell 会先展开成文件名列表,然后传给 find。find 拿到的是 -name seo_check.py publish_online.py ...,只取第一个,其余当成起始路径。这条命令能跑通,但结果不是你想要的。
第三,空结果是合法的。 echo $UNDEFINED_VAR 输出空行,退出码 0。grep 没匹配到内容时退出码是 1(这个还算好),但很多工具对「没找到」和「找到了」都返回 0。
要判断命令做没做对,得看输出,不能只看退出码。
六、自己测的时候要注意什么
如果你要给自己的 Agent 打这个分,四条建议。
一、用例要覆盖「看起来对但语义变了」的情况。 只测「跑不跑得通」,分数会虚高 20 个点以上。
二、分类比总分有用。 +30% 这个数字看不出该改什么。按失败原因拆开,你才知道是「路径感知差」还是「参数记不牢」。
三、样本要够。 20 条只能看趋势,不能下结论。要比较两个模型,至少 200 条,而且用例得来自真实任务而不是编的。
四、环境要固定。 同一条命令在不同目录、不同系统上结果不同。我这份测试依赖 tools/ 目录存在,换台机器就跑不了。
七、边界
这 20 条命令是我编的,不是真实 Agent 输出。 所以 +30% 和 +5% 这两个数字只说明方法可行,不代表任何模型的实际水平。
语义检查是我人工标的。 哪条算「语义可疑」有主观成分。比如 head -n -5 严格说也是合法用法,只是和「取前 5 行」的意图不符。换个标注标准,数字会变。
「20 条里 5 条静默错误」这个比例不能推广。 我是刻意埋了坑的,真实场景的静默错误率应该低得多。但低不等于没有。
和 Kimi 的 BashReliability 不是同一个指标。 只是思路相同。它的具体定义、评分基准、样本构成,我都没拿到。数字不能横向比较。
我只测了「命令能不能跑」,没测「跑了之后结果对不对」。 后者需要任务级的验证,比这个难一个量级。
站内另一篇讲决策模型为什么错判比漏判严重,那篇的结论在这里同样成立:评测口径差一点,结论差很多。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。